/
















Text
                    КОМПЬЮТЕРНЫЙ

АНАЛИЗ
генетическою
текстов
АКАДЕМИЯ НАУК СССР
Институт молекулярной генетики

КОМПЬЮТЕРНЫЙ

АНАЛИЗ

генетических
текстов

Ответственный редактор
доктор физико-математических наук

М.Д. Франк -Каменецкий

в

Москва
"Наука"
1990
УДК 519.6.575

Авторы: А.А.Александров, Н.Н.Александров, М.Ю.Бородовский,
Ю.А.Каламбет, А.3.Кистер, А.А.Миронов, П.А.Певзнер, В.А.Шепелев

Компьютерный анализ генетических текстов/

А.А.Александров, Н.Н.Александров, М.Ю.Бородовский и др.
М.: Наука, 1990.-267с.-

13ВМ 5-О2-ОО4691-4

Книга является одной из первых в мировой литературе монографий,
посвященных компьютерной генетике - новой дисциплине, сформировав-
шейся в последние 10 лет на стыке молекулярной биологии и математи-
ки. Материал книги основан на современных достижениях компьютерного
анализа первичных структур биополимеров и включает основные резуль-
таты ведущих советских и зарубежных специалистов. В монографии боль-
шое внимание уделено проблем'ам поиска гомологичных фрагментов; ста-
тистическому анализу последовательностей; локализации функциональных
сигналов и кодирующих областей; построению физических карт; предска-
занию вторичной структуры РНК; пакетам программ анализа структуры
биополимеров и банкам данных в молекулярной биологии.

Для студентов, аспирантов, специалистов в области молекулярной и
математической биологии, генетики, генной инженерии.

Табл. 47, Ил. 86. Библиогр. 351 назв.

ТЬе Ьоок зиррозеб Фо Ье атоп§ Фйе ПгзФ топойгарМез оусг ФЬе
тог1<1 ЬеУоФеб Фо ФНе сотриФег §епеФ1сз. Т1нз Пе1<1 оГ зс!епсе Наз
Ьееп <Деуе1орес1 оп ФНе Ьаз1з оГ ЬоФН то1еси1аг Ыо1огу апб таФЬетаФФс
1с1еаз с!иг1п§ 1азФ Феп уеагз. ТЬе те1п зФаТГ оГ Фпе Ьоок геПесФз
сопФетрогагу асЫуетепФз оГ сотриФег апа1уз!з оГ ФЬе пис1еоФ13е
зериепсез, 1.е. а питЬег оГ гези1Фз оЬФаФпеа Ьу ЗоуФеФ зс1епФ1зФз аз
те 11 аз ФЬе1г ТогеФ^п со11е§иез. ТЬе та1ог аФФепФФоп тез §1уеп Фо
ФЬе ФоИотепе риезФФопз: зециепсе а11§птепФз, зФаФФзФФса! азресФз оФ
ФЬе пис1еоФ13е зециепсез, гесо§пФФ1оп оФ ФипсФФопа! зФепаФз апб
сосНп§ ге^тепз, гесопзФгисФ1оп оФ гезФгФсФФоп тарз, ВИА ФоФсНпе
ФогесазФ ргоЫетз, ФпФгобисФФоп Фо Ф11е рго^гатт раска^ез апЗ
ЬаФаЬазез 1п то1еси1аг Ыо1о§у.

Рог зФибепФз, розФ^габиаФез, апб зресФаНзФз 1п ФЬе Г1е1 б оф
то1еси1аг апб таФпетаФ1са1 Ыо1о§у, §епеФ1сз апб §епеФ1с
епц1пеег1п2.

Рецензенты: А.А.Богданов, А.В.Лукашин

1903010000- 067
к----------------- 475-90,

042(02)-90

полугодие

18ВК 5-О2-ОО4691-4

@ Коллектив авторов,1990
ПРЕДИСЛОВИЕ

Когда-то,в самом начале 60-х годов,в только что организованном Радио-
биологическом отделе Института атомной энергии им. И.В. Курчатова (ныне
этот отдел преобразован в Институт молекулярной генетики АН СССР) прохо-
дило обсуждение общей стратегии предстоящих работ. Начальник отдела,
Виктор Юлианович Гаврилов, выдвинул идею бросить все силы отдела на раз-
работку методов секвенирования белков и нуклеиновых кислот. Тогда мой
отец, Давид Альбертович Франк-Каменецкий, бывший тогда научным консуль-
тантом отдела, сказал: "Хорошо, допустим вы научились быстро секвенирс-
вать ДНК, допустим вы прочли все ДНКовые тексты. Как вы их будете хра-
нить и использовать? Ведь это будут громадные фолианты!"

Теперь, тридцать лет спустя, мы вплотную подошли к этой проблеме. Об-
щая длина всех расшифрованных ДНКовых текстов более 40 млн нуклеотидов,
и объем новой информации растет лавинообразно. Начал осуществляться про-
ект "Геном человека”, в который включились все развитые в научном отно-
шении страны. Текст человеческого генома, содержащий более трех миллиар-
дов букв, будет почти полностью (а может быть и весь) прочитан к концу
текущего тысячелетия. Как хранить и "переваривать" всю эту гигантскую
информацию?

Совершенно ясно, что здесь невозможно обойтись без самых современных
компьютеров. Только они позволяют хранить и быстро просматривать тексты
такой длины. Но кроме компьютера необходимо специальное матобеспечение,
которое позволяло бы анализировать ДНКовые тексты, находить их "смысл1;
Создание такого матобеспечения - огромная и сложнейшая задача, над кото-
рой во всем мире трудится быстро увеличивающаяся армия программистов,
математиков, биофизиков, биологов.

В предлагаемой вниманию научной общественности книге подводится итог
работы в этом направлении,проделанной к концу 80-х годов. По замыслу ее
создателей прежде всего она должна стать руководством для тех, кто уже
широко пользуется генетическими текстами, т.е. для практически работаю-
щих молекулярных генетиков. Она также должна стать плацдармом для даль-
нейшего развития методов анализа последовательностей ДНК.

Наука в данной области развивается стремительно. Уже сейчас, когда
пишутся эти строки, появились новые подходы, которые не могли быть вклю-
чены в книгу. Это прежде всего подходы,основанные на моделях нейронных
сетей. Но освещение этих новых нарождающихся направлений - дело будущего.

М.Д. Франк-Каменецкий
ВВЕДЕНИЕ

Разработка методов клонирования и определения последовательнос-
ти оснований (секвенирования) нуклеиновых кислот положило начало
новому этану развития молекулярной биологии. Знание первичной
структуры участков генома, выполняющих определенные функции, дало
возможность эффективно применить для их исследования целый арсенал
новых методов генной инженерии. Эти методы (направленный мутаге-
нез, рекомбинация 1п у11го и др.) позволяют модифицировать участки
нуклеотидных последовательностей и исследовать их функции на моле-
кулярном уровне. С их помощью комбинируются участки генетического
материала и создаются геномы с совершенно новыми функциями. С дру-
гой стороны, эпоха массового секвенирования нуклеотидных последо-
вательностей по-новому ставит две кардинальные проблемы биологии:
проблему структура-функция и проблему молекулярной эволюции.

Секвенирование нуклеиновых кислот в настоящее время стало ру-
тинным методом молекулярной биологии. Несомненно, в ближайшем бу-
дущем появятся еще более совершенные автоматические секвенаторы,
что приведет к резкому увеличению числа расшифрованных последова-
тельностей. В настоящее время расшифровано около 100 тыс. фрагмен-
тов различных геномов, а также ряд целых геномов небольшого разме-
ра (в сумме около 35 млн нуклеотидов). Однако, с биологической
точки зрения, это совсем немного. Все расшифрованные последова-
тельности составляют примерно 10 книг по 1000 страниц или суммар-
ную длину генома пяти бактерий, а геном человека, например, соста-
вит несколько тысяч таких книг.

Благодаря знанию генетического кода мы имеем возможность опре-
делять участки нуклеотидных последовательностей, кодирующих потен-
циальные белки. Этот источник и сегодня, спустя 10 лет после рас-
шифровки первого целого генома (бактериофаг ФХ174), дает нам ос-
новную информацию о функциональном строении нуклеотидной последо-
вательности. В то же время, несмотря на то, что известны сотни
последовательностей различных функциональных сигналов нуклеиновых
кислот, наши представления о принципах их организации весьма огра-
ничены. Это обусловлено трудностями экспериментального исследова-
ния регуляторных участков и сложностью их строения.

До начала эпохи массового секвенирования многим исследователям
казалось, что функциональные участки будут закодированы однознач-
ными последовательностями, скорее всего изменяющими локальные фи-
зические свойства молекулы нуклеиновой кислоты. В действительности
оказалось, что это не так. Лишь участки действия некоторых фермен-
тов имеют одинаковое строение, и их легко найти на расшифрованной
последовательности - таковы некоторые сайты действия рестриктаз I-
типа. Участки, которые узнают на ДНК белки-регуляторы работы ге-
нов, не столь однозначны. Их поиск - уже более сложная задача.
Сайты начала и окончания работы РНК-полимераз, участки начала
трансляции РНК, участки сплайсинга имеют весьма сложное строение.
Они состоят из нескольких характерных блоков, находящихся на варь-
ирующих расстояниях, часто включают элементы вторичной структуры,
что сильно затрудняет их поиск на последовательностях.

Выявление и анализ закодированных в последовательностях функци-
ональных сигналов требует применения современных методов информа-
тики - качественных баз данных с современными средствами управле-
ния, новейших методов распознавания образов, статистических иссле-
дований, применения специальных алгоритмов для преодоления возни-
кающих вычислительных трудностей.

В настоящее время исследование функциональных свойств расшифро-
ванных последовательностей нуклеиновых кислот - это новый раздел
молекулярной биологии, граничащий с информатикой, с одной стороны,
и молекулярной биофизикой - с другой. Можно с уверенностью ска
зать, что в настоящее время анализ последовательности биополимера
позволяет извлечь лишь очень небольшую долю закодированной в ней
информации. В конечном счете точное выявление функциональных осо-
бенностей в последовательностях нуклеиновых кислот будет возможно
только после детального исследования соответствующих реакций, осу-
ществляемых нуклеиновобелковыми комплексами.

Таким образом, прогресс в предсказании функциональной структуры
расшифрованных участков генома непосредственно зависит от уровня
наших молекулярно-биологических представлений. На современно!,: эта-
пе развития молекулярной биологии и программ анализа возможны лишь
вероятностные предсказания функциональной структуры на основании
знания последовательности. Однако, так как секвенирование стано-
вится наиболее простым методом анализа структуры генетического ма-
териала, возрастает также и ценность теоретического предсказания
его функциональной структуры. Возможности теоретических методов
анализа структур биополимеров только начинают открываться.

Специальные компьютерные программы позволяют повысить эффектив-
ность проведения генно-инженерных разработок путем анализа карт
рестрикции ДНК и анализа кодируемых белковых продуктов, оптимиза-
ции синтеза фрагментов ДНК различными методами, выбора оптимальных
зондов для выделения индивидуальных генов и т.д. Неожиданно полез-
ной оказалась методика сравнения вновь расшифрованных последова-
тельностей со всеми последовательностями банка. При этом были отк-
рыты такие родственные отношения между совершенно различными гена-
ми, которых никто не подозревал. Например, обнаружение высокой
степени гомологии между ростовым фактором из тромбоцитов крови че-
ловека и онкогеном вируса шерстистой обезьяны открыло новое нап-
равление в исследованиях рака, которое сейчас бурно развивается.
Подробное изложение вопросов, связанных с проблемой поиска гомоло-
гий, читатель найдет в гл. 1 (Миронов А.А.).

Рост объема баз данных первичных структур биополимеров немед-
ленно вовлек в сферу изучения генетических текстов традиционные
для генетиков методы теории вероятностей и математической статис-
тики. Статистический анализ генетических последовательностей выя-
вил большое количество аномальных характеристик (например, обога-
щенность геномов различными повторами, блоками), которые еще пред-
стоит объяснить на функциональном уровне. Это наблюдение показало,
что необходимы специальные усилия для того, чтобы корректно опи-
сать генетические тексты с помощью математических моделей, в част-
ности с помощью аппарата теории марковских цепей. Такие модели
необходимы для оценки статистической значимости гомологий, вычис-
ления компактных информационных характеристик текстов (энтропии,
избыточности и т.д.), предсказания частот встречаемости нуклеотид-
ных "слов". В свою очередь, изучение наиболее (или наименее) расп-
ространенных слов, выявление участков генома различающихся по час-
тоте использования некоторых "стандартных" комбинаций нуклеотидов,
позволяет выдвигать новые гипотезы о функциональной роли фрагмен-
тов генетического текста и их эволюционной истории. Перечисленным
вопросам посвящена гл. 2 (Бородовский М.Ю. и Певзнер П.А.).

Одной из наиболее популярных тем компьютерной генетики является
идентификация в природных нуклеотидных последовательностях таких
участков, которые кодируют белки. Здесь также приносят реальную
пользу математические модели функциональных областей генома, пост-
роенные с помощью методов статистики. Большая или меньшая надеж-
ность предсказания зависит от степени полноты априорной информации
(наличия или отсутствия обучающей выборки). Подробно об этом можно
прочесть в 3-й главе (Бородовский М.Ю.).

Определенного прогресса можно ожидать в ближайшие годы в разви-
тии методов поиска и анализа локальных функциональных сигналов в
нуклеотидных последовательностях. Вероятно, применение статисти-
ческих методов, методов распознавания образов, возможно, совершен-
но новых подходов (например, вычислительных систем типа нейронных
сетей, обладающих свойствами ассоциативной памяти), позволит в
ближайшие годы заметно повысить надежность теоретических предска-
заний функциональных свойств последовательностей биополимеров.

За последние годы появилось значительное количество структурных
данных относительно строения нуклеиновых кислот, белков и их комп-
6
лексов. Появление новых гипотез о структурных особенностях взаимо-
действия ферментов с нуклеиновыми кислотами может послужить базой
для разработки эффективных программ идентификации функциональных
сигналов. В 4-й главе книги (Александров Н.Н. и Каламбет Ю.А.) чи-
татель найдет изложение вопросов, связанных с теоретическими мето-
дами распознавания функциональных сигналов.

Возникновение структурной гипотезы о функционировании нуклеино-
вобелкового комплекса является точкой контакта двух пока в значи-
тельной степени разобщенных направлений компьютерного анализа био-
полимеров - анализа нуклеотидных последовательностей и структурно-
го анализа и предсказания вторичных и третичных структур белков.
Вероятно, в ближайшие годы эти направления сблизятся и, возможно,
будут объединены в едином программном комплексе.

В начале 80-х годов стало очевидно, что современному генному
инженеру компьютер необходим не менее (а иногда и более) чем физи
ку, химику или экономисту. Возникла необходимость в создании авто-
матизированного рабочег’о места генного инженера. При этом выяви-
лось, что ряд задач, возникающих у генных инженеров, связан с ана-
лизом огромного количества вариантов. Такие задачи не поддаются
решению при помощи "лобовых" подходов, для их анализа необходимо
применение методов современной дискретной математики. Одна из та
ких задач - физическое (рестрикционное) картирование молекул ДНК -
рассматривается в гл. 5 (Певзнер П.А.). Физическое картирование -
один из самых распространенных методов анализа ДНК. В связи с
предполагаемым секвенированием генома человека объем работ по фи-
зическому картированию в ближайшие годы будет значительно увели-
чен. В настоящее время физическое картирование - один из разделов
компьютерной генетики, где удалось "заставить" работать серьезные
результаты из разных областей математики (теория графов, потоки в
сетях, эргодическая теория).

Другой задаче, связанной с анализом огромного числа вариантов,-
предсказанию вторичной структуры РНК - посвящена гл.6 (Кистер
А.Э.). Здесь рассматриваются как комбинаторные методы решения этой
задачи, так и хорошо зарекомендовавший себя в последнее время так
называемый кинетический подход.

Для оперативной работы с последовательностями создаются специ-
альные банки данных. Организация информации в банках данных, мето-
ды распространения информации и работы с ней описаны в гл.7 насто-
ящей книги (Шепелев В.А.).

В банке в доступном для пользователя виде хранится каждая рас-
шифрованная последовательность и ее паспорт, в котором указаны
различные сведения о ней. Это сведения об организме, из которого
выделена последовательность, о документе, где она описана, о рас-
положении на ней регуляторных участков и белках, которые она коди-
рует и т.д. В настоящее время созданы три большие базы данных пос-
ледовательностей нуклеиновых кислот: "СепЬапк" (Лос-Аламос, США -
более 30 млн. нуклеотидов), база данных нуклеотидных последова-
тельностей Европейской молекулярно-биоло гической лаборатории
(ЕМВЬ, Гейдельберг, ФРГ - более 30 млн. нуклеотидов) и Тенэксп-
ресс” (СССР, ВИНИТИ-ИМГ АН СССР - более И млн. нуклеотидов). Из-
вестны также несколько белковых баз данных, наиболее представи-
тельной из которой является ЙВКР-Р1Е (США). Эти базы данных расп-
ространяются на различных носителях - магнитных лентах и дисках,
на оптических дисках.

Производство баз данных и их интенсивное заполнение началось в
середине 80-х годов и развивается очень интенсивно. Объем баз дан-
ных удваивается каждые три года. Однако в погоне за полнотой сос-
тавители баз данных проявляют недостаточное внимание к качеству и
содержанию вводимой в базы данных информации. Принципы построения
баз данных генетических текстов являются предметом горячих дискус-
сий. Ясне, что в ЭВМ нужно вводить как можно больше информации, но
биологическую информацию трудно формализовть. Этим определяется
тенденция к дифференциации баз данных. Например, в СССР кроме баз
данных первичных структур нуклеиновых кислот и белков намечаются к
выпуску базы данных векторов для генной инженерии, функциональных
сигналов нуклеиновых кислот, ферментов, метаболических путей, ге-
нетических карт.

В то же время исследователю для решения биологических задач
нужна одновременно самая разнообразная информация о генетике, био-
синтезе и функционировании различных продуктов, а также библиогра-
фические сведения. Это приводит к необходимости создания интегри-
рованных систем молекулярно-биологической информации, включающих
все элементарные базы данных и связи между ними. Такие системы
создаются в качестве опытных разработок и пока не распространяются
на коммерческой основе. Таким образом, в банках данных в настоящее
время накоплено и находится в доступном для пользователя виде ог-
ромное количество информации о последовательностях биополимеров.

Активному внедрению методов компьютерного анализа в молекуляр-
ную биологию существенно способствовал прогресс в вычислительной
технике и математическом обеспечении последних двух десятилетий.
Как раз к началу периода массового секвенирования (к концу 70-х
годов) уже были ясны основные концепции формирования баз данных,
которые как раз в это время начали широко применяться в области
точных наук и деловой сфере.

Для работы с базой данных ЭВМ должна быть снабжена специальным
комплексом программ СУБД (системой управления базой данных), пос-
ледняя позволяет проводить разнообразные действия с документами
базы данных: осуществлять поиск нужных документов по многим пара-
метрам, выделять информационные подбазы по определенным признакам,
каталогизировать данные и т.д. В 80-х годах в мире создано нес-
колько крупных систем для работы с несколькими базами данных
структур биополимеров. Эти комплексы создавались на мощных ЭВМ и,
несомненно, имеют большие возможности. Однако на крупных компь-
ютерных системах выполняется сравнительно небольшое число работ
разведочного характера.

Это во многом связано с психологией исследователей-биологов.
Если физики давно привыкли работать в вычислительных центрах и
знают, что без компьютеров им не обойтись, то некоторые биологи
предпочитают считать нуклеотиды вручную, не обращаясь в вычисли-
тельный центр.

Биологам крупно повезло, что как раз к моменту возникновения
необходимости обрабатывать последовательности с помощью ЭВМ на
свет появились первые персональные компьютеры. Они стали важным
инструментом в молекулярно-биологических лабораториях прежде всего
потому, что на них очень удобно иметь локальные библиотеки после-
довательностей и других данных. Ресурса персональных ЭВМ вполне
хватает для выполнения самых необходимых операций над последова-
тельностями, эти ЭВМ стоят прямо в лабораториях и для них не нужно
ни дополнительного персонала, ни дополнительных помещений. Дру
жественное общение" персональной ЭВМ с пользователем часто приво-
дит к тому, что непрофессионалы приобщаются к программированию и
благодаря хорошему знанию своей предметной области создают ценные
программные продукты.

Таким образом, подавляющее большинство расшифрованных последе
вательностей анализируется в настоящее время на персональных
компьютерах. Конечно, не все программы, необходимые для работы :.ю
лекулярных биологов эффективны на персональных компьютерах. Прог
раммы, требующие больших вычислений, рационально использовать на
мощных ЭВМ. К ним относятся программы поиска гомологичных последо-
вательностей во всем банке, выравнивание последовательностей, пос-
троение вторичных структур РНК, программы, связанные с энергети-
ческими и термодинамическими расчетами и т.д.

Наиболее распространенными сейчас являются персональные компь-
ютеры фирмы 1ВМ. Это связано с господствующим положением этой фир-
мы на компьютерном рынке, вследствие чего 1ВМ-РС совместимые
компьютеры быстро совершенствуются благодаря изготовлению для них
различными фирмами дополнительных устройств и матобеспечения. В
СССР также начато массовое производство 1ВМ-РС совместимых компь-
ютеров.

В настоящее время в мире появляется все большее количество ком-
плексов программ анализа структур биополимеров для персональных и
более мощных компьютеров (их стоимость лежит в пределах от 500 до
20 тыс. долларов). В СССР и социалистических странах в соответст-
вии с научнотехническими программами "Генинформ" и Тенинформ-СЭВ"
также разработано математическое обеспечение для ЭВМ различных ти-
пов. До 1991г. будут разработаны мощные комплексы программ иссле-
дования структур биополимеров для 1ВМ-РС совместимых компьютеров.

Квалифицированное использование этих средств анализа позволяет
существенно повысить эффективность научных исследований в области
молекулярной биологии, биотехнологии и некоторых разделов медици-
ны. В то же время, несмотря на широкое распространение компьютер-
ных методов в молекулярной биологии, ощущается существенный недос-
таток литературы, освещающей широкому пользователю основные науч-
ные принципы, на которых построены прикладные программы анализа
структур биополимеров.

В настоящей книге читатель познакомится с идеями и представле-
ниями, на которых основаны современные методы анализа первичных
структур биополимеров (в основном нуклеиновых кислот).

А.А.Александров
ГЛАВА 1. ПОИСК ГОМОЛОГИЙ

1.1.	ФОРМУЛИРОВКА ЗАДАЧ ПОИСКА ГОМОЛОГИЙ

Одна из наиболее часто возникающих проблем при анализе биологичес-
ких текстов - поиск гомологий. И это понятно, поскольку схожесть текс-
тов позволяет делать выводы об их эволюционной и/или функциональной
близости. Здесь можно привести пример обнаруженной гомологии между оп-
ределенными типами онкогенов и клеточными генами (НаЬагго еФ а1.,
1984), что привело к возникновению нового направления исследований.
Гомологии между последовательностями часто используют для реконструк-
ции эволюционных деревьев. Такие важные аспекты анализа биологических
текстов, как поиск повторов, палиндромов, симметричных участков, сай-
тов рестрикции, также связаны с проблемой поиска гомологий. Анализ го-
мологий необходим также при подготовке и проведении целого ряда экспе-
риментальных работ, в частности при синтезе олигонуклеотидных зондов
для поиска клонов в клонотеке, стыковке фрагментов нуклеотидных после-
довательностей при секвенировании протяженных участков ДНК или целых
геномов и др.

Проблему поиска гомологий можно ставить по-разному, и это приводит
к разным методам ее решения и к разным результатам. Можно выделить
следующие основные задачи поиска гомологий.

-	Задача 1. Найти в двух текстах наибольшие полностью совпадающие
фрагменты. Это так называемая задача о поиске максимального общего
слова, и здесь в качестве критерия гомологии выступает длина совпадаю-
щего фрагмента.

-	Задача 2. Найти максимальые фрагменты, совпадающие не полностью,
а, быть может, с некоторыми заменами. Для этой задачи критериями гомо-
логии являются длина совпадающих фрагментов и число (или процент) сов-
падающих букв (нуклеотидов или аминокислот). Для решения задач 1 и 2
разработаны весьма эффективные алгоритмы и сделаны оценки статистичес-
кой значимости найденных гомологий.

-	Задача 3. Найти максимальные фрагменты, не полностью совпадающие,
а имеющие замены и вставки. Эта задача называется задачей о выравнива-
нии и отличается от задачи 2 возможностью введения в сравниваемые пос-
ледовательности вставок. В качестве критерия гомологии здесь, как пра-
вило, выступает число совпадающих букв за вычетом штрафов за замены и
вставки. Для решения этого типа задач обычно применяют методы динами-
ческого программирования.

Описанные задачи допускают так называемую локальную формулировку,
при которой в анализируемых текстах требуется найти не одну пару фраг-
ментов, обеспечивающую максимум соответствующего критерия гомологии, а
все возможные пары такие, для которых этот критерий выше заданного по-
рогового значения. Например, найти все совпадающие фрагменты длиной не
менее к букв. Типичной локальной задачей о поиске гсмолсгий является
задача поиска повторов.

Порой в литературе встречаются сообщения о том. что между теми или
иными последовательностями обнаружена гомология 90, 70 или даже 49%. В
первом случае значимость гомологии не вызывает сомнений и, как прави-
ло, она видна "на глаз". Во втором случае сходство не очевидно, и зна-
чение процента совпадений зависит от того, какая задача решалась и ка-
ковы были параметры, например чему равен штраф за делецию. В третьем
же случае возникает сомнение, а есть ли здесь вообще гомология? Поэто-
му, с одной стороны, важно знать, какая именно задача о гомологии ре-
шается и при каких параметрах, а с другой - необходимы статистические
оценки значимости гомо.;.тий. Последнее представляет собой сложную ма-
тематическую задачу, некоторые аспекты которой рассмотрены в главе,
посвященной статистическим методам анализа генетических текстов.

Для решения задач о поиске гомологий разработаны эффективные алго-
ритмы и соответствующие программы. Однако, пожалуй, наибольшей попу-
лярностью среди биологов пользуются программы, прямо не решающие ни
одну из перечисленных задач. Это - программы построения так называемых
точечных матриц гомологии. Они очень наглядны и не требуют от исследо-
вателя точного знания, какого типа гомология его интересует.

Известен целый ряд нуклеотидных последовательностей, достаточно
сильно отличающихся друг от друга, в то время как их функциональная
близость не вызывает сомнений. Речь идет о транспортных и рибосомных
РНК. Здесь приходится говорить о гомологии совсем иного свойства - го-
мологии по вторичным структурам. При текстуальном сравнении этих пос-
ледовательностей под близостью следуе" понимать существование схожих
наборов инвертированных повторов, способных образовывать двунитевые
участки (Спирин,1986). Другим примером подобной гомологии является
близость (предсказанных) пространственных структур альфа и бета интер-
феронов при очень слабом сходстве кодирующих их областей. На гомологи-
ях подобного рода мы здесь подробно останавливаться не будем, посколь-
ку для их выявления нет достаточно развитых алгоритмов.

Существуют чисто экспериментальные методы поиска гомологий нуклео-
тидных последовательностей.Наиболее распространенными являются подхо-
ды, основанные на гибридизации молекул нуклеиновых кислот и дальнейшем
анализе дуплексов тем или иным методом. При анализе протяженных гомо-
логий применяют также сопоставление рестрикционных (физических) карт
соответствующих фрагментов ДНК. И в том, и в другом случае нет необхо-
димости определять последовательность оснований в сравниваемых молеку-
лах. Рассмотрение соответствующих методик не является предметом насто-
ящей книги.
В настоящей главе рассмотрены основные вопросы, связанные с поиском
гомологий. В параграфе 2 описаны простейшие алгоритмы поиска гомологий
- методы построения точечных матриц гомологии и методы поиска наиболь-
шего общего слова. Параграф 3 посвящен методам динамического програм-
мирования для задач выравнивания. В параграфе 4 рассмотрена проблема
поиска по банкам генетиче~ких текстов. В параграфе 5 подведены основ-
ные итоги и перечислены некоторые нерешенные проблемы, связанные с по-
иском гомологий.

1.2.	ПРОСТЕЙШИЕ МЕТОДЫ ПОИСКА ГОМОЛОГИЙ

Точечные матрицы гомологии. Построение так называемых точечных мат-
риц гомологий (с:л., например, СИЬЪе.. Ме1пФуге.1970) является одним из
наиболее популярных методов поиска гомологий, Суть метода сводится к
следующему. Пусть требуется сравнить последовательности 5, и 52 длиной
Ы и П2 соответственно. Для анализа этих последовательностей строится
прямоугольник размером (рис.1.1), по верхней стороне прямоуголь-
ника выписывается (или подразумевается) первая последовательность, по

Рис. 1.1. Построение точечной матрицы
гомологии. Линии соответствуют гомологиям

Рис. 1.2.Зависимость вероятности появ-
ления точки на точечной матрице гомологии
от отношения(пыпчисло совпадений)/ (длина
окна) при разных размерах окна 1 для нук-
леотидных (а) и аминокислотных (б) после-
довательностей

а б

ТТСААС’АТСААССТСАССС

!

10

10

10

10

10

.1 = 10

.. 1 -- 1 5
1=20

.1=30

I =50
.1=70
„1=100

к/ I

0,0	0,5	1,0

левой стороне - вторая последовательность. Затем в каждой клетке пря-
моугольника, соответствующей совпадающим буквам, ставится точка. При
анализе полученной картины выделяют группы точек, расположенных на ли-
нии, параллельной диагонали (выделены на рисунке). Эти группы точек и
определяют гомологичные фрагменты на последовательностях. Однако полу-
ченная картина обладает слишком большой избыточностью информации и по-
этому трудно читается. Было бы лучше, если бы на этой картине отсутст-
вовали одиночные точки, а при сравнении более длинных последователь-
ностей - комбинации точек, которые можно считать случайными. Таким об-
разом, возникает задача фильтрации. Обычно она решается так: точка в
точечной матрице гомологии ставится при условии, что она соответствует
буквам, принадлежащим фрагментам последовательностей длиной да и имею-
щим не менее к совпадений (естественно да>=к). Иными словами, на матрице
отмечаются локальные гомологии без делеций и вставок при критерии "не
менее к совпадений на фрагменте длиной да”. С помощью теории вероятнос-
тей при заданных » и к можно оценить вероятность появления точки на
матрице гомологии. Действительно, анализ окна длиной V сводится к схеме
Бернулли, где успех - совпадение пары букв. Тогда вероятность Р(да,к)
появления точки равна

Р(да,к)= Е С’рЧД-р?'1,
1 =к *

где С‘ - биномиальный коэффициент; р - вероятность совпадения букв в
последовательностях. На рис.1.2,а приведены графики зависимости веро-
ятности появления точки на точечной матрице гомологии от отношения к/»
при разных V для случая нуклеотидных последовательностей (р-0,25). На
рис.1.2,б приведены аналогичные графики для аминокислотных последова-
тельностей. Более полный анализ методов фильтрации при построении
точечных матриц гомологии дан в гл."Статистические методы анализа ге-
нетических текстов". Отметим, что при разных « и к, отвечающих одина-
ковым вероятностям, точечные матрицы гомологии могут оказаться сущест-

Р и с. .3. Пример точечной матрицы гомологии фрагмента последователь-
ности Бео оперона Е.соИ с самим собой при параметрах фильтрации к=12,
1=16 (1) и к=31, 1=63 (б)

венно разными. Исходная точечная матрица гомологии отвечает случаю
да=к=1, а при более общих значениях «и к задача построения точечной
матрицы сводится к локальной задаче 2 - найти на двух последователь-
ностях фрагменты длиной не менее да и имеющие не более да-к замен и к
графическому отображению ее решения. На рис.1.3,а,б приведены примеры
точечных матриц гомологии при различных значениях параметров фильтра-
ции к и ч. Расчеты проведены с помощью пакета программ ОПА-ЗиП на ЭВМ
1ВМ. РС/ХТ.

При анализе аминокислотных последовательностей целесообразно ис-
пользовать несколько иной фильтр, а именно точка ставится, если в ок-
не длиной V суммарный уровень сходства аминокислот не менее заданного.
Дайхофф (СауЬоТТ, 1972) провела детальный анализ частот аминокислотных
замен в гомологичных семействах белков. В табл. 1.1 приведены получен-
ные веса аминокислотных замен. При подсчете суммарного уровня сходства
в окне суммируют числа, соответствующие аминокислотам в сравниваемых

Таблица 1.1
Относительные частоты аминокислотных замен

бР0ЕАНф8ТККНУ1М СЬЕ V *

6	29

Р 12 14

О 11 1023

Е 11111920

А 13 14 12 12 14

Ы 111014121217

О 10111414111221

8	12 1 1 12 11 13 13 1 1 13

Т 101010101212111318

К	7	81010	9121110	9 24

В	4	4	7	7	5 10 13	7	6 22 75

Н	6	6	9	8	81312	9	9112059

V	78781089911856	22

I	66678788 10	757	21	25

М	5666878898 10	6	16	16	26

С	645576511	9423	11	9	12	166

Ь	445665667646	15	18	21	5	40

Р	2223	4- 33453477	11	11	2	12	70

У	111122232337366	16 66 137

V	11111222223 15 244	13 41 46 414

Таблица 1.2

Различие физических свойств аминокислотных остатков

СРОЕАЫ28ТК Р Н V 1 М С Ь Г V
6 О
Р 42 О
О	94	108	О

Е	98	93	45	О

А	60	27	126	107	О

И 80	91	23	42111 О

С	87	76	61	29	91	46	О

8	56	74	65	80	99	46	68	О

Т	59	38	85	65	58	65	42	58	О

К	127	103	101	56	106	94	53	121	78	О

Р	125	103	96	54	112	86	43	110	71	6	О

Н	98	77	81	40	86	68	24	89	47	32	29	О

V	109	68	152	121	64	133	96	124	69	97	96	84	О

I	135	95	168	134	94	149	109	142	89	102	97	94	29	О

М	127	87	160	126	84	142	101	135	81	95	91	87	21	10	О

С	159	169	154	170	195	139	154	112	149	202	180	174	192	198	196	О

Ь	1 38	98	172	1 38	96	153	ИЗ	145	92	107	102	99	32	5	1 5	198	О

Р	1 53	1 14	177	140	ИЗ	1 58	1 1 6	155	103	1 02	97	100	50	2 1	28	205	22	О

У	147	110	160	122	112	143	99	144	92	85	77	83	55	39	36	194	36 22	О

V	184	147	181	152	148	174	130	177	128	110	101	115	88	61	67	215	61 40	37
последовательностях. Уровень сходства можно также рассчитать с исполь-
зованием коэффициентов отличия физических свойств аминокислот, таких,
ка!к гидрофобность, заряд, объем боковой группы. Соответствующие пара-
метры приведены в табл. 1.2 (СгапФЬат,1974). При этом следует иметь в
виду, что числа в табл. 1.2 характеризуют отличия свойств аминокислот,
в то время как; таёлд ' 1.1 отражает их сходство. Поэтому при использо-
вании табл. 1.2 в качестве критерия постановки точки следует использо-
вать условие, что суммарный вес меньше заданной величины.

Простейшие методы поиска общего слова. Опишем теперь методы реше-
ния задач 1 и 2, к которым сводится задача построения точечной матрицы
гомологии. Простейший алгоритм заключается в следующем (рис.1.4.).
Последовательность 51 со сдвигом накладывается на последовательность
52. По общей части этих последовательностей пробегает окно длиной да.
В каждом положении окна подсчитывается число совпадающих букв. Если
это число превышает пороговое значение к, значит найдена пара гомоло-
гичных участков. После просмотра всех возможных наложений 3, на 52 и
всех возможных положений окна задача 2 считается решенной. Число опе-
раций, которые выполняются при работе этого алгоритма, оценивается вы-
ражением: число возможных наложений последовательностей'число возмож-
ных положений окна'длина окна=П1 "П2'да, и для большинства реальных за-
дач составляет величину порядка 1С7. Иными словами, этот простой алго-
ритм достаточно трудоемок.

I ТСААСТАТСААССТСАССС. . .

| - + + 4- + + -+1
О,	С А А ТС Т АС А Т С Т А Т Т С А . . .

3, ТТСААСТАТСААССТСАССС...

1	I „ X X X -X 4 - хН

Зг СААТСТАСАТСТАТТСА...

Рис. 1.4. Простейший алгоритм поис-
ка общего слова. Рамка соответствует
бегущему окну

Рис. 1.5. Улучшенный алгоритм поис-
ка общего слова

Верхняя рамка - предыдущее положе-
ние окна; нижняя - новое положение
окна

Трудоемкость этого алгоритма можно сократить примерно в да раз. Для
этого достаточно сделать простое наблюдение (рис. 1.5). При сдвиге
правой границы окна на одну позицию вправо число совпавших букв к* в
окне увеличится на 1, если в окно попадет совпавшая пара и не изменит-
ся в противном случае. При сдвиге же левой границы окна на одну пози-
цию вправо число к* уменьшится на 1, исли из окна вышла совпадающая
пара букв и не изменится в противном случае. Таким образом, нет необ-
ходимости в каждом положении окна подсчитывать число совпадающих букв,
а достаточно лишь следить за его изменением. Теперь алгоритм выглядит
так: просматриваются все наложения последовательности на 32; при
каждом наложении подсчитываем число совпадений в крайнем левом положе-
нии окна, затем сдвигаем окно вправо и следим за изменением числа к'
совпадений. В тех случаях, когда к* превысит пороговое значение счита-
ется, что найдена гомология. Этот алгоритм называют методом скользящей
рамки. Его трудоемкость равна П,*И2.

Метод 1-граммного разложения. Описанные алгоритмы применимы для ре-
шения задач 1 и 2, однако для задачи 1 (поиск строгих гомологий без
замен и делеций) можно предложить алгоритм, требующий всего Ы^^+а'
операций, где а - число букв в алфавите (для нуклеотидных последова-
тельностей а=4, для аминокислотных последовательностей т=20), а 1 -
некоторое число, смысл которого будет пояснен ниже. Работа этого алго-
ритма также весьма проста (Каг11п е1 а1., 1983). По последовательнос-
тям 3, и 32 составляем таблицы Т, и Т2 положений всех подслов (фраг-
ментов) длиной 1 (например, таблицы положений всех гексануклеотидов)
так, что каждой строке этой таблицы отвечает одно подслово. Например,
последовательности ТАТ&СА соответствует одна строка, а последователь-
ности СТА&СС - другая и т.д.. Число строк в каждой такой таблице равно
а1. -На рис.1.6 приведен пример построения такой таблицы. При достаточ-
но большом 1 многие строки будут пустыми. Для нахождения гомологий
между последовательностями в таблицах находим непустые строки - именно
они и определяют гомологию. Остается только проследить за тем, что не-

Р и с. 1.6. Разложение последова-
тельности по 1-граммам (1=2)

Сверху показана последователь-
ность; слева - 1-граммы; горизон-
тальные линии - найденные 1-граммы;
справа изображена таблица 1-грам-
много разложения

тталлатлтсААСсталасс

которые гомологии длиной 1 могут быть фрагментами более протяженной
гомологии. Например, АТАТСС и САТАТС являются фрагментами семичленника
САТАТОС. Идеи этого подхода весьма плодотворны, они будут встречаться
и в дальнейшем, поэтому целесообразно дать ему название, например, ал-
горитм 1-граммного разложения, поскольку построение таблиц Т, и Т2 яв-
ляется разложением текста по 1-граммам (фрагментам длиной 1).

Хотя алгоритм 1-граммного разложения применим лишь для решения ло-
кальной задачи 1, с его помощью можно существенно ускорить решение за-
дачи 2 и, как мы увидим ниже, задачи о выравнивании. Можно заметить,
что если два фрагмента длиной 1 имеют к совпадающих букв, то эти фраг-
менты имеют идеально совпадающие подфрагменты длиной не менее
!'=[!/(1-к+1)]. Поэтому, прежде чем решать задачу 2 с параметрами 1 и
целесообразно решить задачу 1 с параметром 1’ и затем вокруг най-
денных гомологий проверять выполнение условий задачи 2. Этот прием
4озволяет принципиально снизить трудоемкость решения задачи 2, если
Только 1' достаточно велико.
Рестриктазное картирование нуклеотидных последовательностей являет-
ся специальным случаем решения задачи 1. Здесь применение идей 1-грам-
много разложения также позволяет значительно ускорить процесс картиро-
вания и сделать его практически не зависящим от числа рестрикционных
сайтов, подлежащих картированию. Суть заключается в следующем. Все
сайты рестрикции приписываются к тетрануклеотидам по первым четырем
узнаваемым нуклеотидам. Например, сайт ЕсоК 1 СААТТС приписывается к
четверке СААТ, а сайт ХЬо 2 (^)САТС(^) приписывается к двум четверкам
- АСАТ и СО АТ. В результате получается таблица (рис.1.7). Обратим вни-
мание на то, что в одной строке разложения таблицы сайтов рестрикции
может оказаться больше одного сайта, и наоборот - одна рестриктаза мо-
жет попасть в несколько строк таблицы. После этого просматривается
последовательность. В каждой позиции определяется тетрануклеотид, свя-
занный с ней. Далее по этому тетрануклеотиду в таблице находятся рест-
риктазы, которые могут узнать эту последовательность, и их сайты узна-
вания сравниваются с нуклеотидной последовательностью в этой точке.
Это сравнение необходимо для рестриктаз, узнающих более 4 нуклеотидов.
Характерным показателем эффективности работы многих пакетов прикладных
программ является время, необходимое для картирования плазмиды рВК-322
по 100 сайтам рестрикции. Большинство программ выполняют эту работу за
время 1-5 мин, применение же алгоритма 1-граммного разложения позволя-
ет проделать эту работу за несколько секунд.

АААА

АААТ

АСАТ ХЬо 2

СААТ	ЕсоК 1

ССАТ	ВатН 1	ХЬо 2

Рис. 1.8. Построение позиционного дерева

Рис. 1.7. 1-граммное
разложение таблицы сай-
тов рестрикции

Применение метода 1-граммного разложения для аминокислотных после-
довательностей сопряжено с большими затратами оперативной памяти, пос-
кольку даже для запоминания трехбуквенных комбинаций требуется
203=Й000 строк таблицы разложений. Для того чтобы обойти эту труд-
ность, прибегают к редукции алфавита, т.е. объединяют близкие по свой-
ствам аминокислоты в группы, и в качестве букв в последовательности
используют символы, обозначающие группы. Правда, применение подобного
рода редукции требует затем проверки гомологий, найденных методом 1-
граммного разложения, поскольку при преобразовании алфавита часть
информации о последовательности теряется.
Позиционные деревья. Описанный только что метод 1-граммного разло-
жения обладает одним существенным недостатком - ранг 1 разложения дол-
жен задаваться заранее, и при этом возможны ошибки двух типов - слиш-
ком высокий ранг приводит к потере существенных гомологий, а слишком
низкий - к большому информационному шуму. Мартинец (МагНпех, 1983)
использовал оригинальный способ разложения по уникальным подсловам.
Опишем этот способ на примере. Пусть у нас есть последовательность

5={ТСАСАСТ*},

где * - признак конца последовательности. Тогда строим дерево по сле-
дующему алгоритму (рис.1.8). Из корня выпускаем ветви по числу типов
букв, которые встречаются в последовательности, и на концах ветвей пи-
шем соответствующие буквы и их позиции, т.е. делаем 1-граммное разло-
жение при 1=1. Если таких позиций оказалось несколько, то значит най-
денная буква не уникальна, в противном случае (как буква С в нашем
примере) найденная буква является уникальным подсловом. Из неуникаль-
ных вершин выпускаем ветви по числу типов букв, которые следуют за со-
ответствующей буквой. Так, за буквой А всегда следует буква С, поэтому
из клетки А выходит одна ветвь, а из клетки С, за которой могут следо-
вать либо А, либо Т, выходит две ветви. В вершинах второго уровня пи-
шем списки позиций, с которых начинаются соответствующие двухбуквенные
слова. Если список состоит из одного элемента, значит это двухбуквен-
ное слово уникально, в противном случае продолжаем ветвление. В конце
процесса получаем так называемое позиционное дерево. Каждый путь по
нему до висячей вершины описывает уникальные подслова минимальной дли-
ны. Показано, что число операций, необходимое для построения такого
дерева имеет порядок П’1п(П), где И - длина последовательности.

При помощи позиционного дерева можно анализировать повторы - любой
путь от корня, не доходящий до висячей вершины - отвечает повтору.
Чтобы найти общие слова двух последовательностей, их объединяют в од-
ну. Далее для объединенной последовательности строится позиционное де-
рево, затем на нем ищутся пути, соответствующие двум последовательнос-
тям - они отвечают гомологиям.

Метод Мартинеца более трудоемок и требует большей памяти, чем прос-
тейший метод 1-граммного разложения, однако при его помощи получать
серьезные результаты о частоте встречаемости различных подслов, нахо-
дить очень короткие уникальные подпоследовательности и т.п.. Аналогич-
ные идеи разложения последовательности на уникальные подслова, но с
использованием методов быстрой сортировки, высказывались также в рабо-
те Корна и др.(Когп е1 а1., 1977).
1.3.	ВЫРАВНИВАНИЕ БИОЛОГИЧЕСКИХ ТЕКСТОВ

Основные понятия. Задача выравнивания является, пожалуй, наиболее
общей задачей поиска гомологии, поскольку при выравнивании мы имеег.
возможность учесть довольно общие виды различий текстов - замены
вставки, делении. Единственное, чего нельзя учесть при решении задач (
выравнивании, так это блочных перестановок, хотя при локальном подход-
можно обнаружить и их. Чтобы конкретизировать предмет дальнейшего об-
суждения, введем несколько основных понятий. Выравниванием двух текс-
тов будем называть расстановку вставок на последовательностях. Но
рис.1.9,а приведен пример выравнивания. Очевидно, что это выравнивание

1ТСААС 1А7С--ААСС- ТСАССС!АТСАА •-
-----АСТ — АТС.А ~АС СТ А-Тй — ААТлС

1ТСААСГАТ--СА-АССТСАСССТАТСАА---

----АСТАТСССАТАСС-СА-СС---СААТАС

САСС:СТАТ = САА - --

САСС;----;СААТАй

Рис. 1.9. Примеры выравниваний
(а,б,в)

ГТСАА-(ЛАТСААССТСАСССТАТСА.

* * «« * ******

АСТАТСССАТАС--ОС -АСССТА _

Р и с. 1.10. Путь на точечно;
матрице гомологии (а! и соо"-
ветствующее выравнивание (б

сделано не наилучшим образом, поскольку любой здравомыслящий исследо-
ватель в начале нижнего текста сделал бы на одну вставку меньше, после
ААС в верхнем тексте не делал бы вставки и т.д., т.е. сделал бы вырав-
нивание, как на рис.1.9,6. Почему же выравнивание рис.1.9,б лучше, че;.
выравнивание рис.1.9,а? Во-первых, потому, что в кем больше совпадаю-
щих букв, во-вторых, в нем меньше вставок (или делений, так как встав-
ка в одну последовательность эквивалентна делении в другой последова-
тельности), в-третьих, в нем меньше замен. Чтобы при определении опти-
мального выравнивания учесть все три требования (побольше совпадений
поменьше делеций и замен), вводят так называемую функцию сходства Р:

Р=кп*уп-к

(1.1

V
с

где к , кн, кс - количество совпадений, делеций и замен в выравнива-
нии; Ут, Ул, ус - некоторые весовые коэффициенты. Выравнивание счита-
ется оптимальным, если функция сходства для него не меньше, чем для
любого другого выравнивания. Часто оптимальных выравниваний бывав"
несколько, например выравнивание рис.1.9,в ничем не хуже выравнивание
рис. 1.9, б.
Для выбора коэффициентов Ут, ул, тс используют различные соображе-
ния. В частности, известно, что мутационный процесс чаше приводит к
транзициям (заменам А-С, Т-С), чем к заменам другого типа, поэтому при
исследовании проблем эволюции заменам типа транзиции придают меньший
вес. С другой стороны, при формировании дуплексов СС-пары дают больший
выигрыш в энергии, поэтому при анализе вероятностей образования дуп-
лексов совпадениям 0-0 и С-С придают больший вес. При выравнивании
аминокислотных последовательностей заменам придают вес в соответствии
с близостью их свойств или частотой аминокислотных замен в мутационном
процессе. Для этого можно использовать табл. 1.1 и 1.2. Сложнее дело
обстоит с "ценой делеции" Уа. Для того чтобы оценить вероятность деле-
ции, необходимо предварительно эти делеции обнаружить, т.е. провести
выравнивание, а для этого, в свою очередь, надо задаться коэффициентом
V . Обычно полагают у,,=(2-5)‘7т. Если ууург, то в оптимальном вырав-
нивании никогда не будет замен, поскольку в этом случае выгоднее деле-
гировать несовпадающие буквы из обеих последовательностей и получить
штраф 2ча, чем получить штраф тс за несовпадение.

Можно представить себе и использовать более общий вид функции сход-
ства. Для этого заметим, что любое выравнивание можно разбить на чере-
дующиеся блоки - совпадающих, несовпадающих и делегированных элемен-
тов. Например, на рис.1.9,в мы имеем И таких блоков: с 1-й по 4-ю по-
зицию - блок делеций в первой последовательности, 5-9-я позиция - блок
совпадений и т.д.. После такого разбиения можно определить функцию
сходства как сумму функций сходства по блокам:

Е=Бгга(кт)-ьЕгс(кс)-Ега;ка) .	(1.2)

где кт, кс, ка - длины блоков совпадений, несовпадений, делеций, а
!т, Гс’ ~ Функции сходства для этих блоков соответственно. Функция
сходства (1.2) может использоваться, например, при выравнивании коди-
рующих областей, поскольку делеции/вставки, не кратные размеру кодона,
приводят к сбою рамки считывания, и за них необходимо назначать значи-
тельно большие штрафы, чем за делеции/вставки, кратные трем. При ана-
лизе блочных перестроек обычно назначают штраф за делецию, слабо зави-
сящий от размера делеции и т.п.

Из сказанного видно, что выбор конкретной функции сходства подчинен
достаточной степени субъективизма. Но, к счастью, сильно гомологичные
последовательности выравниваются примерно одинаково при различных ва-
риантах функции сходства, чего нельзя сказать о последовательностях со
слабой гомологией. Поэтому утверждения о гомологии 90% говорят о дейс-
твительно высокой гомологии, в то время как "гомология 40%" ничего не
говорит без четкого указания параметров, которые использовались при
выравнивании. Дальнейшее описание алгоритмов будем вести для простей-
шего вида функции сходства (1.1).
Иногда в качестве критерия качества выравнивания используют рассто-
яние (БеПегз, 1974). В случае последовательностей под расстоянием по-
нимают обычно минимальное число элементарных преобразований, превраща-
ющих одну последовательность в другую. Такими элементарными преобразо-
ваниями могут быть деления, вставка, замена или в более сложных слу-
чаях транспозиция элементов. Однако для решения задач выравнивания (а
особенно для решения локальных задач выравнивания) более удобно ис-
пользовать сходство, хотя принципиальной разницы между этими критерия-
ми нет.

Метод динамического программирования. Чтобы описать алгоритм пост-
роения оптимального выравнивания, попробуем представить себе геометри-
ческий образ выравнивания. Для этого вспомним точечную матрицу гомоло-
гии (рис.1.10). Любую линию на этой матрице, идущую либо вверх, либо
вправо, либо вправо - вверх параллельно диагонали условимся называть
путем по точечной матрице гомологий. Нетрудно догадаться, что любой
путь по матрице из левого нижнего в правый верхний угол отвечает неко-
торому выравниванию, причем движение вверх или вправо отвечает делеции
в одной из последовательностей, а при движении параллельно диагонали
прохождение через пустые клетки соответствуют заменам, прохождение че-
рез точки - совпадениям. Например, пути рис.1.10,а соответствует вы-
равнивание 1.10,6. Задача оптимального выравнивания, таким образом,
сводится к поиску наилучшего пути по матрице гомологии. При поиске
этого пути будем одновременно строить матрицу наилучших значений функ-
ции сходства: Е(I,1) - есть значение функции сходства, отвечающее оп-
тимальному пути из левого нижнего угла матрицы гомологий в точку
(1,1). Если известны значения функции сходства в точках (1-1,1), (1.1~
1) и (1-1,1-1) и оптимальные пути в эти точки, то можно найти значение
функции сходства для наилучшего пути, ведущего из точки (1,1) в точку
(1,1), и определить этот путь. Оптимальное значение функции
определяется по формуле

Р(1,1)=шах{ Е( 1-1,1 )-ча,	(1.3)

Е(1,1-1)-Уй,

Е( 1-1,1-1)+уи),

где Ун=Ут, если 1-буква первой последовательности совпадает с 1- бук-
вой второй последовательности, и ун=-ус в противном случае. Наилучший
путь к точке (1,1) определяется членом в формуле (1.3), на котором
достигается максимум,- это наилучший путь к соответствующей точке
((1-1,1), (1.3-1) или (1-1,з-1)) плюс переход: в первом случае по го-
ризонтали, во втором по вертикали, а в третьем по диагонали

(рис. 1.11). Например, если максимум достигается на втором члене форму-
лы (1.3), то оптимальный путь в точку (1,1) будет состоять из опти-
мального пути в точку (1,1-1) (а он нам известен!) плюс переход впра
во. На практике обычно фиксируют только эти переходы, а весь оптималь-
ный путь восстанавливают по ним в конце работы алгоритма. Совокупность
найденных переходов будем в дальнейшем называть картой обратных пере-
ходов. Для окончательного построения алгоритма осталось только опреде-
лить начальное значение функции сходства в точке (1,1) и разобраться с
начальной (нижней) строкой и начальным (левым) столбцом матрицы Р
(рис.1-12,а). Для этого добавляют слева столбец с номером 0, а снизу
строку с номером 0. Значения на этих линиях определяются ценой делеции
о и с. 1.11. Переходы при построении |г< ' -) 11 3~~ Ч Р< ь —I
оптимального выравнивания

рис. 1.12. Пример матрицы сходства	/ и

(а), карты путей (б) и оптимального	_____/

выравнивания (в), построенных методом	I Р(I	I Р( ,.ь р I

динамического программирования (Ут=1,	1-------1	1------1

Уа=1, ус=П

с А АТСААСТАТС	СААТСААСТАТС

крайних букв в последовательностях. На рис.1.12,а изображен пример
матрицы Р, а на рис.1.12,б - соответствующая карта путей при значениях
параметров чт=чс=чд=1, выделенный путь отвечает оптимальному выравни-
ванию. На рис.1.12,в приведено выравнивание, соответствующее оптималь-
ному пути. Оптимальное значение функции сходства для этого выравнива-
ния Р(Н1Д2)=0.

Индуктивные методы поиска оптимальных путей, подобные только что
описанному, называются методами динамического программирования. Алго-
ритм динамического программирования для решения задач выравнивания
впервые был предложен Нидльманом и Вуншем (ИеесПетап, МипзсЬ, 1970) и
его можно применять для решения широкого круга задач.

Алгоритм Нидльмана - Вунша построен таким образом, что он ищет оп-
тимальный путь из левого нижнего угла в правый верхний. При этом выс-
тавляются штрафы за краевые вставки, например в выравнивании
рис. 1.12, в за первые три и последние три нуклеотида функция сходства
штрафуется на Ъ'Уа, хотя очевидно, что имеет место просто сдвиг одной
последовательности относительно другой. Поэтому метод Нидльмана - Вун-
ша применим только для тех случаев, когда совпадают "начала отсчетов"
сравниваемых последовательностей.

Как нетрудно убедиться, трудоемкость этого алгоритма равна Ы,-Ы2,
однако, если наложить ограничение на максимальное число ошибок к, то
можно сократить число операций, необходимых для поиска оптимального
пути до величины порядка Ы’к (Ьапбаи еФ а!.,1986). Действительно, в
этом случае нет необходимости вычислять функцию сходства во всех точ-
ках матрицы, а достаточно их вычислить лишь в окрестности диагонали
шириной 2‘к.

Можно модифицировать задачу выравнивания таким образом, чтобы не
штрафовать за сдвиг последовательностей друг относительно друга. На
матрице гомологий эта задача будет формулироваться так. Среди всех пу-
тей, начинающихся и кончающихся на границе матрицы гомологий, найти
наилучший. Алгоритм, решающий такую задачу, очень похож на метод
Нидльмана - Вунша. Отличие заключается в том, что при построении мат-
рицы К под оптимальным значением функции сходства понимается функция
сходства для наилучшего пути, ведущего из точки (1,1) на нижнюю или
левую границу матрицы гомологии. Для того чтобы числа Е(1,1) имели
соответствующий смысл, достаточно вместо введения нулевых строки и
столбца определить нижнюю строку и левый столбец: Р(1,1) и Е(1,1) при-
равниваются чт или в зависимости от совпадения или несовпадения со-
ответствующих букв в выравниваемых словах. Чтобы теперь найти опти-
мальный путь, необходимо после построения матрицы Е найти наибольшее
значение функции сходства на правой и верхней границе матрицы выравни-
вания и восстановить оптимальный путь из найденной точки.

Первая постановка задачи выравнивания "из угла в угол" характерна
для анализа сходства заведомо близких текстов, например гомологичных
белков или сигналов, для которых начала и концы функционально значимы.
Вторая постановка задачи "от границы до границы" встречается при сек-
венировании для стыковки прочитанных фрагментов, а также при выравни-
вании последовательностей, когда функционально-значимые точки на них
неизвестны, но предполагается отсутствие несовпадающих участков на
краях. Есть еще одна постановка задачи глобального выравнивания - сре-
ди всех путей найти наилучший. Здесь не ставится никаких ограничений
на положения концов путей. Такая постановка задачи типична при иссле-
довании функциональных сигналов, сайтов рекомбинации, подборе зондов и
пр.

Задачу о поиске оптимального пути без ограничений на положение его
концов также можно решать методом динамического программирования. Для
этого прежде всего необходимо определить смысл чисел Е(I,1). В этом
случае под Е(1,1) будем понимать значение функции сходства для наилуч-
шего из путей, приводящих в точку (1,1) (он может начинаться, где
24
угодно левее и ниже этой точки). Если мы разобьем какой-либо путь на
два участка, то цена целого пути будет равна сумме цен его частей. По-
этому понятно, что к любому пути невыгодно добавлять участки с отрица-
тельной ценой. Отсюда следует, что на всем оптимальном пути величина
Е(1,3) должна быть положительной и может обращаться в 0 только внача-
ле, поскольку в противном случае оптимальный путь будет иметь участки
с отрицательной или нулевой ценой, которые выгодно отбросить. Все эти
рассуждения допускают наличие на оптимальном пути внутреннего участка
с отрицательной функцией сходства, например блок делеций в одной из
последовательностей, который соединяет два хорошо совпадающих участка,
поскольку отбрасывать можно только начало или конец пути, но не сере-
дину. Таким образом, можно модифицировать формулу (1.3) для вычисления
Р(1,1):

Р(1,з)=тах{ Р(1-1,з)-Уа,	(1.4)

Г(1.1-1)-Уд,
Е(1-1,1-1)+уи,
О }.

Так же как и для предыдущих задач, будем параллельно с матрицей В
строить карту обратных переходов. Точка (1*,1*), отвечающая наибольше-
му значению Е*=тах{Р(1,1)}, определит нам конец оптимального пути, и
начиная с этой точки можно пройти по карте обратных переходов до того
места, где Е обратится в 0 - это соответствует началу оптимального
пути.

Все описанные выше варианты метода динамического программирования
применимы для функции сходства вида (1.1). При использовании более об-
щего вида функции сходства (1.2) применяется вариант Ватермана и Смита
(ИаЪегтап е1 а1., 1976) метода динамического программирования. Его
трудоемкость составляет величину порядка т1п(М1фМ22,Н12,М2), что явля-
ется платой за более общий вид функции сходства.

Описанные алгоритмы позволяют находить единственный оптимальный
путь. Однако иногда бывает интересно посмотреть альтернативные вариан-
ты с той же ценой или с ценой, чуть меньшей. Эту задачу также позволя-
ет решать метод динамического программирования (Ма1егтап, 1983).

Локальное выравнивание. Описанные алгоритмы решают глобальную зада-
чу выравнивания, т.е. ищут наилучший в том или ином смысле путь. Воз-
можна также локальная постановка задачи выравнивания: найти все пути
на матрице гомологий, для которых функция сходства превышает заданную
величину и удовлетворяют следующим требованиям: во-первых, найденные
пути должны быть оптимальными при фиксированных начале и конце; во-
вторых, эти пути должны быть в некотором смысле максимальными - любое
наращивание локально-оптимального пути может привести лишь к уменьше-
нию функции сходства; в-третьих, эти пути должны быть непрерывными -
функция сходства фрагмента пути от начала до любой его точки должна
быть положительной. Это требование означает запрет на чисто формальное
объединение ничем не связанных путей. Кроме того, разумно наложить
запрет на пересечение путей: если два пути пересекаются или имеют об-
щие точки, то из них выбирается тот, для которого функция сходства на-
ибольшая. Эти требования, кроме требования максимальности, не встреча-
лись в локальной задаче поиска общего слова, поскольку в задаче об об-
щем слове пути могут идти только параллельно диагонали.

Задачи о локальном выравнивании возникают при поиске разного рода
повторов, возможных сайтов рекомбинации, анализе и поиске разного рода
функциональных сайтов и т.п. Отметим, что если существует хорошее (с
функцией сходства больше порогового значения) глобальное выравнивание,
то оно (точнее ее существенная часть) будет найдено при решении ло-
кальной задачи выравнивания. Таким образом, задача поиска локальной
гомологии в некотором смысле является самой общей задачей выравнива-
ния.

Для поиска локального выравнивания можно применять тот же метод ди-
намического программирования, что и для задачи поиска оптимального пу-
ти. Пусть в результате применения этого метода мы построили матрицу Р
и карту обратных переходов (рис.1.13,а,б). Возьмем теперь любой путь
на карте переходов и построим вдоль него график изменения функции
сходства (рис.1.14). Он будет состоять из целого ряда подъемов и спа-
дов - подъемы соответствуют совпадениям букв в сравниваемых последова-
тельностях, спады - дефектам гомологии - заменам и делециям. Выделим
участок пути до наибольшего значения функции Р. Он отвечает всем тре-
бованиям локальной гомологии, если только наибольшее значение функции
сходства превосходит пороговую величину. Действительно, этот участок
оптимален по самому построению, он максимален, поскольку любое его на-
ращивание приводит лишь к уменьшению функции сходства и, наконец, он
непрерывен, так как функция сходства на нем всюду положительна. Есть
ли на этом пути другие участки, отвечающие требованиям локальной гомо-
логии? Есть. Для того чтобы в этом убедиться, отбросим только что най-
денный участок и построим функцию сходства для оставшейся части пути,
помня, что она не может быть отрицательной (на рис.1.14 она обозначена
пунктирной линией ). После такого преобразования функция сходства мо-
жет неоднократно обратиться в 0. К каждому фрагменту с ненулевой функ-
цией сходства можно применить предыдущие рассуждения, т.е. найти наи-
большее значение функции сходства, выделить участок от начала фрагмен-
та до максимума функции сходства в качестве локальной гомологии, пе-
ресчитать функцию сходства, начиная от найденного максимума. Описанную
процедуру нужно повторять до тех пор, пока максимальное значение функ-
ции сходства на оставшемся участке превосходит пороговое значение. Об-
работав таким образом все пути, построенные методом динамического
программирования, можно найти все локальные гомологии. Описанный метод
является модификацией, предложенной И.И.Ветровым (частное сообщение)
алгоритма Гоада и Канехисы (Соай, КапеЫза, 1982).

Описанные методы динамического программирования достаточно эффек-
тивны, требуют не больше порядка операций для решения задачи вы-
равнивания, однако им присущ серьезный недостаток - они требуют для
своей работы большой емкости памяти для запоминания карты обратных пе-
реходов (помнить всю матрицу Е не обязательно, поскольку на каждом ша-
ге используется только предыдущая строка этой матрицы). Так, для вы-
равнивания двух последовательностей по 103 букв требуется память по-
рядка одного мегабайта. Оперативная память такого размера редко встре-
чается в персональных компьютерах, и для реализации методов динамичес-
кого программирования приходится использовать внешнюю память на маг-
нитных дисках, что приводит к заметному увеличению времени работы

программы.

Рис. 1.13. Матрица сходства (а) и карта путей (б) в задаче поиска
оптимального пути (лт=1, уй=2,ус=2)

Жирной линией показан оптимальный путь; тонкие линии соответствуют
перспективным путям; точечные линии - щетина"- бесперспективные пути

ТСАЛС7А7СААСС7САССС7ССС7САССАА

Рис. 1.14. Изменение
Функции сходства вдоль
пути

Чтобы обойти эту трудность, достаточно взглянуть на карту обратных
переходов для задачи локальной гомологии или для задачи поиска опти-
мального пути (рис.1.13,б) и убедиться в том, что эта карта в основном
пуста - на ней встречаются лишь отдельные "веточки". Может быть, в
этом случае нет необходимости запоминать всю карту, а лишь только "ве-
точки", отвечающие гомологиям? Это можно сделать так. При работе алго-
ритма динамического программирования карта обратных переходов и матри-
ца Р строятся строка за строкой. Получив очередную строку карты пере-
ходов, ее можно упаковать, выбросив пустые элементы и запомнив, где и
сколько таких элементов было выброшено. Этот прием позволяет упаковать
карту достаточно плотно (в 5-10 раз). В принципе карту обратных пере-
ходов можно уплотнить еще примерно в 2 раза, для чего обратим внимание
на то, что все веточки обрасли "щетиной", отвечающей переходам, не
имеющим продолжения. Было бы разумно перед упаковкой и запоминанием
карты эту "щетину" "сбрить", что делается достаточно просто. Макси-
мальный размер делеции и диагонального перехода по несовпадающим пози-
циям легко определить 1а=Р( 1,)АЙ, 1„=Р( 1,1 )Ас. Поэтому достаточно
просмотреть 1а клеток матрицы гомологии по горизонтали и 1т клеток по
диагонали, и если ни из одной из них невозможно продолжение, значит
эта линия - "щетина" и ее надо "сбрить", приравняв к 0 функцию сходст-
ва во всех клетках, ей принадлежащих. Этот прием применим при условии,
что приоритетным при выборе максимума в формуле (1.4) является переход
по диагонали.

Возможен также другой подход к проблеме запоминания карты обратных
переходов - не запоминать ее всю. Для этого вспомним метод 1-граммного
разложения. Пусть штрафы за делецию и за замену равны у6=ус=2, а пре-
мия за совпадение равна Ут=1. Тогда ясно, что при этих условиях любая
гомология начинается не менее чем с трех совпадающих букв. В этом слу-
чае можно предложить подход: методом 1-граммного разложения находим
все совпадающие тройки (назовем их затравками) - с них может начинать-
ся гомология. Начиная с совпадающей тройки пускаем алгоритм динамичес-
кого программирования. При этом просматривается только часть матрицы
гомологии. В процессе построения функции сходства и карты обратных пе-
реходов запоминаются только ненулевые перспективные клетки, связанные
с выбранной 1-граммой. Функция сходства Е и карта обратных переходов
строятся до тех пор, пока не получится пустая строка, т.е. строка, не
содержащая ни одной ненулевой перспективной клетки, связанной с зат-
равкой. После этого находим наибольшее значение функции сходства и с
помощью карты обратных переходов восстанавливаем выравнивания. Полу-
ченные выравнивания запоминаем, а карту обратных переходов теперь мож-
но забыть и использовать освободившуюся память для построения другого
выравнивания. Применение этого подхода позволяет находить локальные
гомологии при ограниченном ресурсе памяти. Следует, однако, иметь в
виду, что описанный алгоритм не гарантирует выполнения всех условий
локальной гомологии, а именно может нарушиться условие непересечения
путей. Чтобы этого не произошло, следует проверить, не является ли
затравка фрагментом уже найденной локальной гомологии. При наличии та-
кой проверки описанный алгоритм оказывается весьма аффективны'., пос-
кольку его использование не требует работы со всей матрицей, а прос-
матриваются только "веточки", определяющие локальную гомологию. Иными
словами, экономия памяти позволила сэкономить время счета, причем тем
больше, чем менее "ветвисты" карты обратных переходов, а это, в свою
очередь, связано с параметрами гомологии - чем выше отношение Уа/У„,
тем меньше ветвлений на карте, а стало быть, меньше время счета. К со-
жалению, строгую оценку трудоемкости этого алгоритма сделать не удает-
ся.

При описании точечных матриц гомологии говорилось о проблеме филь-
трации. В качестве альтернативы описанному методу фильтрации можно ис-
пользовать следующий фильтр: точка ставится в том случае, если она
принадлежит локальной гомологии (ЗФабеп, 1982). В этом случае точечная
матрица гомологии выступает в качестве способа визуализации результа-
тов поиска гомологий.

1.4.	ПОИСК ГОМОЛОГИЙ ПО БАНКУ ГЕНЕТИЧЕСКИХ ТЕКСТОВ

Применение метода 1-граммного разложения. Одной из наиболее инте-
ресных и в то же время наиболее трудных задач, связанных с поиском го-
мологий, является задача поиска гомологий по банку генетических текс-
тов. Трудность решения подобного рода задач связана с анализом колос-
сальных объемов информации. Так, объем банка нуклеотидных последова-
тельностей в настоящее время превосходит 107 букв и это число стреми-
тельно растет. Применение описанных выше квадратичных по числу опера-
ций методов требует для решения таких задач порядка 10*1 операций и
больших объемов памяти и доступно лишь самым мощным суперкомпьютерам
(СоФоН,Та§азЫга, 1986). С другой стороны, можно попытаться найти
альтернативные методы с тем, чтобы решение таких задач стало возможным
на персональных компьютерах средней мощности.

Один из таких путей связан с идеями 1-граммного разложения. Алго-
ритм поиска гомологий по банку последовательностей, основанный на ис-
пользовании 1-граммногс разложения, мало отличается от уже описанного в
п.2 - тестируемая последовательность раскладывается по 1-граммам и за-
тем проверяется встречаются ли те или иные 1-граммы в банке последова-
тельностей. Однако такое применение этого метода требует известной ос-
торожности. Дело в том, что неудачное задание ранга 1-грамм может при-
вести либо к очень большому уровню шума, либо к пропуску существенной
гомологии. И если при поиске гомологий между двумя последовательностя-
ми умеренного размера такого рода ошибка не страшна, поскольку можно
очень быстро повторить расчет с другими параметрами (потери времени
составят секунды), то при анализе банка последовательностей за такие
ошибки приходится платить часами счета. Кроме того, выбор слишком вы-
сокого ранга 1-грамм требует большой памяти для размещения разложения.
Обычно при применении методов 1- граммного разложения используют ранг
1=13 для нуклеотидных последовательностей и 1=4 для аминокислотных
последовательностей.

Метод 1-граммного разложения для задачи поиска по банку последова-
тельностей имеет существенный недостаток - он ищет только строгие го-
мологии без каких бы то ни было дефектов. Однако есть возможность нес-
колько смягчить зту строгость. Для этого надо изменить определение го-
мологии или, иными словами, начать решать другую задачу. Теперь под
гомологией будем понимать существование р совпадающих 1-грамм, рассто-
яние между которыми не превышает к букв, где го,1,к - параметры гомоло-
гии. Например, две последовательности рис.1.15 гомологичны в смысле
параметров го=3, 1=4, к=4, поскольку они имеют три пары гомологичных
четверок, разнесенных не более чем на 4 буквы. Такой подход позволяет

ТСАСС--ТСАТТСАТСААССС

***** **** *****
СТАССТСАСАТТ---СААССС

Рис. 1.15. Фрагменты, гомоло-
гичные в смысле разнесенных 1-
грамм

применять методы 1-граммного разложения для поиска гомологий с ограни-
ченными вставками и заменами - лишь бы сохранились го гомологичных 1-
грамм. На практике можно применять различные наборы параметров, при
этом будут решаться, вообще говоря, разные задачи и возможно получе-
ние разных результатов. При реализации этого алгоритма (Кондрашов,
Ройтберг, частное сообщение) для каждой цепочки гомологичных 1-грамм
приписывается вес, который вычисляется как сумма весов 1-грамм минус
штрафы за спейсеры, пропорциональные их размерам. При выборе парамет-
ров следует иметь в виду, что увеличение параметров шик приводит к
увеличению времени счета, кроме того, увеличение параметра к повышает
уровень шума. Применение методов 1-граммного разложения для поиска го-
мологий позволяет находить достаточно короткие гомологии с относитель-
но небольшим количеством дефектов. При поиске же протяженных гомологий
с большим количеством дефектов такой подход не применим.

Вилбур и Липман (1ШЪиг, Ыршап, 1983) предложили следующий метод
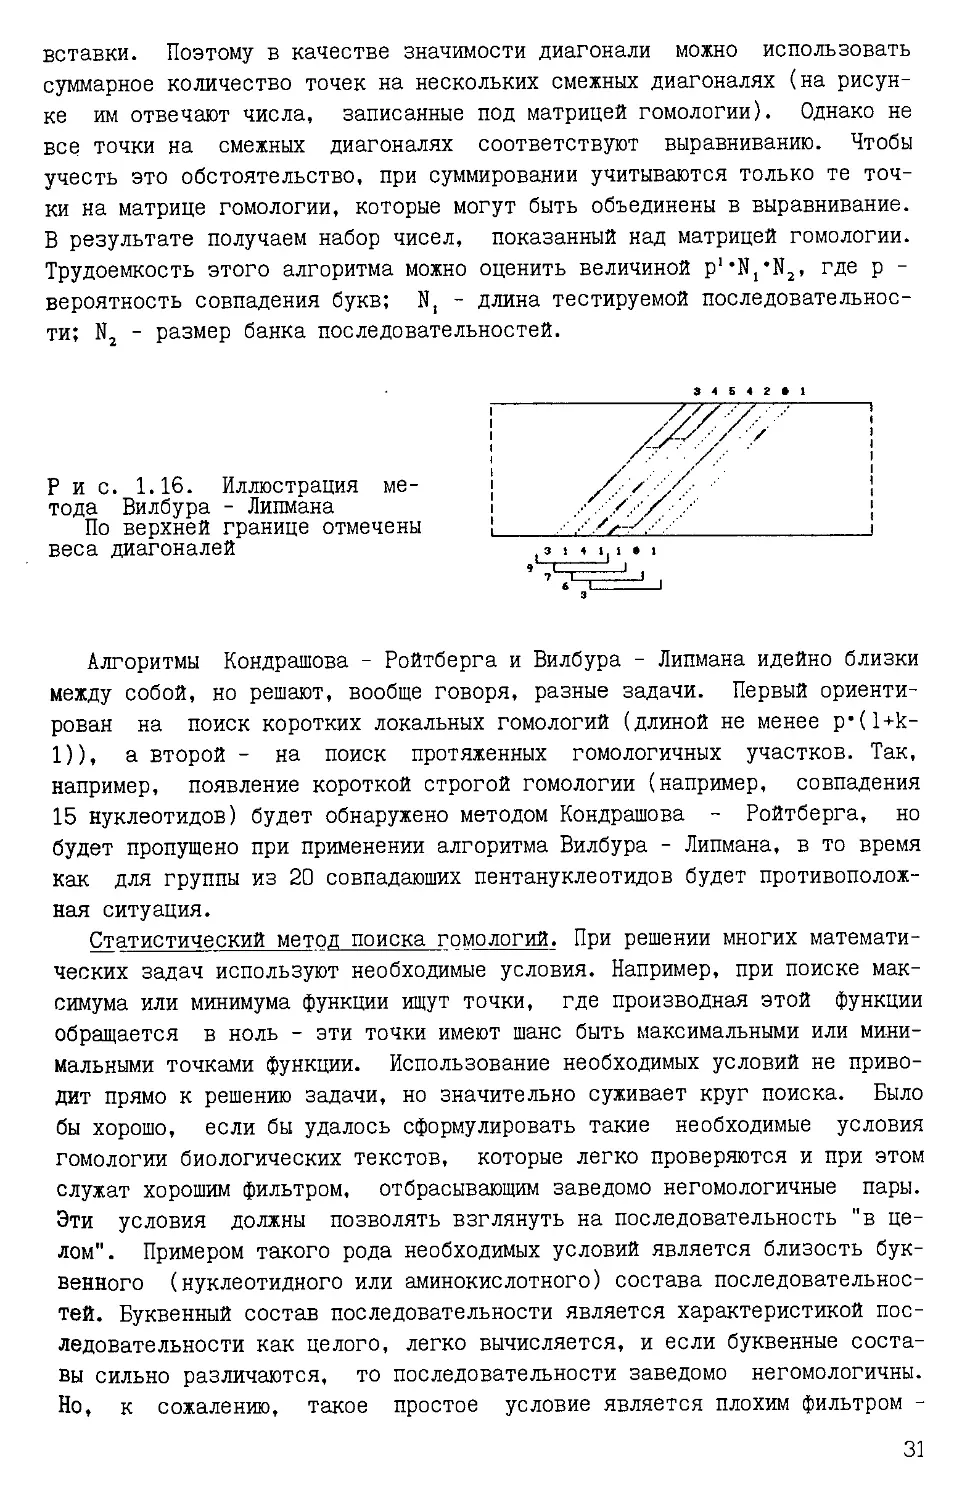
поиска гомологий по банку последовательностей. Представим себе точеч-
ную матрицу гомологий, построенную для тестируемой последовательности
и банка последовательностей (рис.1.16) при параметрах фильтрации: дли-
на окна 1, число ошибок 0. Для построения такой матрицы применим метод
1-граммного разложения. Как известно, гомологии без делеций и вставок
отвечают на этой матрице диагоналям, достаточно заполненных точками.
Чтобы оценить значимость той или иной диагонали, достаточно подсчитать
на ней количество точек. Если это число использовать в качестве крите-
рия гомологии, то будут потеряны гомологии, содержащие делеции и
вставки. Поэтому в качестве значимости диагонали можно использовать
суммарное количество точек на нескольких смежных диагоналях (на рисун-
ке им отвечают числа, записанные под матрицей гомологии). Однако не
все точки на смежных диагоналях соответствуют выравниванию. Чтобы
учесть это обстоятельство, при суммировании учитываются только те точ-
ки на матрице гомологии, которые могут быть объединены в выравнивание.
В результате получаем набор чисел, показанный над матрицей гомологии.
Трудоемкость этого алгоритма можно оценить величиной р1,Н1'Н2, где р -
вероятность совпадения букв; И! - длина тестируемой последовательнос-
ти; М2 - размер банка последовательностей.

Рис. 1.16. Иллюстрация ме-
тода Вилбура - Липмана

По верхней границе отмечены
веса диагоналей

Алгоритмы Кондрашова - Ройтберга и Вилбура - Липмана идейно близки
между собой, но решают, вообще говоря, разные задачи. Первый ориенти-
рован на поиск коротких локальных гомологий (длиной не менее р’(1+к-
1)), а второй - на поиск протяженных гомологичных участков. Так,
например, появление короткой строгой гомологии (например, совпадения
15 нуклеотидов) будет обнаружено методом Кондрашова - Ройтберга, но
будет пропущено при применении алгоритма Вилбура - Липмана, в то время
как для группы из 20 совпадающих пентануклеотидов будет противополож-
ная ситуация.

Статистический метод поиска гомологий. При решении многих математи-
ческих задач используют необходимые условия. Например, при поиске мак-
симума или минимума функции ищут точки, где производная этой функции
обращается в ноль - эти точки имеют шанс быть максимальными или мини-
мальными точками функции. Использование необходимых условий не приво-
дит прямо к решению задачи, но значительно суживает круг поиска. Было
бы хорошо, если бы удалось сформулировать такие необходимые условия
гомологии биологических текстов, которые легко проверяются и при этом
служат хорошим фильтром, отбрасывающим заведомо негомологичные пары.
Эти условия должны позволять взглянуть на последовательность "в це-
лом". Примером такого рода необходимых условий является близость бук-
венного (нуклеотидного или аминокислотного) состава последовательнос-
тей. Буквенный состав последовательности является характеристикой пос-
ледовательности как целого, легко вычисляется, и если буквенные соста-
вы сильно различаются, то последовательности заведомо негомологичны.
Но, к сожалению, такое простое условие является плохим фильтром -
слишком много негомологичных последовательностей имеют близкие буквен-
ные составы. Это связано прежде всего с тем, что буквенный состав ни-
как не учитывает порядок следования букв. Использование дибуквенного
состава существенно более сильный фильтр, поскольку в нем в какой-то
мере учтен порядок букв. Если же еще использовать разнесенные диграм-
мы, то порядок следования букв будет учтен еще полнее. Таким образом,
чтобы сравнить две последовательности, необходимо подсчитать количест-
ва двухбуквенных сочетаний вида ХУ, Х-У, X—У и т.д. для каждой пос-
ледовательности и затем сравнить полученные наборы чисел - если они
будут близки, то последовательности могут быть (но не обязательно бу-
дут) гомологичными, в противном случае они заведомо не гомологичны.
Максимальная степень к разнесенности двоек является параметром алго-
ритма: чем больше к, тем более жестким фильтром является соответствую-
щее необходимое условие гомологии, но тем больше времени требуется для
его проверки.

Отличие диграммного состава может служить мерой расстояния между
последовательностями, однако в таком виде она неудобна. Действительно,
если при сравнении двух последовательностей длиной 100 при к=3 это
расстояние оказалось равным 85, а при сравнении двух других последо-
вательностей длиной 800 при к=5 - 370, то, что из этого следует? Какое
расстояние следует считать случайным, а какое указанием на возможность
гомологии? Для решения этих проблем разумно нормировать диграммные
составы следующим образом. Рассмотрим последовательность 5 длиной Д.
Характеристической функцией е(1,Х) буквы X будем называть величину,
которая равна 1 во всех позициях последовательности, где встречается
буква Х?и равна 0 в остальных позициях

1, 5(1)=Х
е(1,Х)=

0, Б(1)ХХ .

Через эту функцию удобно записать буквенный, диграммный, Р грамм-
ный состав последовательности

а(Х)=Ее(1,Х),

5

а(Х,У,б)=2е(1,Х)-е(1+с1,У),

5

а(Х,У.....г,с!1,...,с11)=2е(1,Х)-е(1+с11,У)«...-е(1+с11,г).

5

Обозначим вероятность появления буквы X через р(Х) и зададим нор-
мированный диграммный состав формулой
Ь(Х,У,а)=(1/ (П-а))Е[е(1,Х)-р(Х)]-[е(1+с1,У)-р(У)].	(1.5)

5

Тогда расстояние между последовательностями определим как

г(б1,б2)= (1/к)Е[ь1(хл,а)-ь2(х,у,а)12 •	(1.6)

а < к
Х,У - по всему алфавиту

Формула (1.6) обладает тем преимуществом, что определяемое ею расс-
тояние универсально: его математическое ожидание не зависит от длины
последовательности. На рис.1.17 приведена плотность распределения ве-

Р и с. 1.17. Плотность расп-
ределения вероятностей для
статистического расстояния
между двумя случайными пос-
ледовательностями

роятностей расстояния между двумя случайными последовательностями. Ма-
тематическое ожидание расстояния между двумя случайными нуклеотидными
последовательностями (р(Х)=0,25) равно т=1,825.

Посмотрим теперь на свойства расстояния (1.6). Пусть две последова-
тельности длиной И отличаются друг от друга заменой или делецией. Тог-
да в них различаются 2(к+1) и к(к+4)/2 диграмм, и расстояние между ни-
ми будет соответственно равно

го=2(к+1)/Н; га=к(к+4)/К.

(1.7)

Глядя на формулы (1.7), можно сказать, что расстояние г характери-
зует плотность числа дефектов гомологии. Отметим еще важное свойство
расстояния г. Пусть две последовательности длиной И, и И2 имеют совпа-
дающий участок длиной И. Тогда математическое ожидание расстояния меж-
ду ними равно

М[г(Б),32)]=пг[ 1- (П/^)],

где ш - математическое ожидание расстояния между случайными последова-
тельностями, П2=Н/М2. Последнее свойство расстояния г означа-
ет, в частности, что при сдвиге последовательностей друг относительно
друга расстояние будет увеличиваться, но незначительно, и поэтому оно
позволяет улавливать гомологии на сдвинутых друг относительно друга

2 Заказ № 4327

33
последовательностях. Наконец, расстояние г мало чувствительно к блоч-
ным перестановкам в последовательностях.

Алгоритм поиска гомологий по банку последовательностей выглядит
так. Тестируемая последовательность разбивается на протяженные фраг-
менты, длина которых Ь примерно равна ожидаемому размеру гомологии.
При этом, чтобы учесть возможность несовпадения начал отсчета последо-
вательностей, это разбиение делается дважды - со сдвигом на Ь/2 или
трижды - со сдвигом на Ь/3 (обычно используется Б=200). Банк последо-
вательностей также разбивается на фрагменты длиной Ь. На каждом из
фрагментов тестируемой последовательности и банка определяется норми-
рованный диграммный состав по формуле (1.5) (для банка такую работу
можно сделать заранее), и для каждой пары фрагментов вычисляется рас-
стояние г по формуле (1.6). Если расстояние г меньше порогового значе-
ния г0 (обычно го=0,Зт), то эта пара фрагментов имеет много шансов на
гомологию. Трудоемкость этого алгоритма оценивается величиной

•П2/Ь2, где а - размер алфавита. Из этой формулы видно, что чем
длиннее искомая гомология, тем эффективнее работает алгоритм. На поиск
гомологии последовательности длиной 103 нуклеотидов по банку нуклео-
тидных последовательностей требуется всего порядка 107 операций, что
вполне доступно персональному компьютеру средней мощности. Из формулы
для трудоемкости следует, что если для нуклеотидных последовательнос-
тей (т»=4) он достаточно эффективен, то для аминокислотных последова-
тельностей (ш=20) его применимость сомнительна. Однако в этом случае
можно прибегнуть к редукции алфавита, как это делалось при применении
метода 1-граммного разложения, и значительно сократить время работы.

Описанный алгоритм, как, впрочем, и другие алгоритмы поиска гомоло-
гий по банку, является только фильтром, отсеивающим заведомо негомоло-
гичные пары, и если пара последовательностей успешно прошла через не-
го, необходимо применить один из описанных выше методов поиска гомоло-
гии между двумя последовательностями, чтобы убедиться в реальности
найденной гомологии и построить выравнивание. Эффективность статисти-
ческого фильтра достаточно высока - до 95% пар последовательностей,
прошедших через него, действительно имеют гомологию (Миронов, Алексан-
дров, 1988).

1.5.ЗАКЛЮЧЕНИЕ

Понятие гомологии является очень широким и включает в себя строгую
гомологию, гомологию с заменами, гомологию с делециями и вставками и
т.п.. Кроме того, различают глобальную и локальную постановки задач
поиска гомологии. Для решения задач поиска строгой гомологии наиболее
эффективными являются методы, связанные с 1-граммным разложением и с
построением позиционных деревьев; решение задач выравнивания обеспечи-
вают методы динамического программирования. Наиболее популярным благо-
даря своей наглядности является метод построения точечных матриц гомо-
логии, хотя он является скорее способом визуализации результатов рабо-
ты различных алгоритмов, чем самостоятельным методом.

В настоящей главе была описана только часть из всего многообразия
методов поиска гомологий, но даже эта малая часть приводит к естест-
венному вопросу: какому же методу следует отдать предпочтение, какая
задача поиска гомологии является самой общей? Такой универсальной за-
дачи нет, а стало быть нет и универсального метода поиска гомологии.
Поэтому чтобы анализ последовательности был достаточно глубоким, необ-
ходимо применить несколько алгоритмов, решающих разные задачи поиска
гомологии и при различных наборах параметров. Например, при поиске по
банку последовательностей целесообразно применить метод Кондрашова -
Ройтберга для поиска коротких гомологий и статистический метод для по-
иска протяженных гомологий. Затем для найденных пар можно применить
метод поиска локальных гомологий при разных наборах параметров. Кроме
того, имеет смысл построить глобальное выравнивание с родственными
последовательностями и т.д. Только такая комплексная обработка позво-
лит найти почти все эволюционные и функциональные связи анализируемой
последовательности и не даст пропустить интересные закономерности.

Есть ли нерешенные до сих пор проблемы, связанные с поиском гомоло-
гий? Безусловно. Это прежде всего вопрос о статистической значимости
выравнивания. Пока в большинстве случаев он решается с помощью модели-
рования на случайных последовательностях (см. гл. "Статистические ме-
тоды анализа генетических текстов"). Кроме того, во многих случаях,
по-видимому, возможно ускорить работу алгоритмов поиска гомологий. Эта
проблема остается актуальной, несмотря на непрерывный рост мощности
современных компьютеров, поскольку объем молекулярно-генетической ин-
формации растет не менее быстро.
Глава 2. СТАТИСТИЧЕСКИЕ МЕТОДЫ
АНАЛИЗА ГЕНЕТИЧЕСКИХ ТЕКСТОВ

2.1.ВОЗМОЖНОСТИ СТАТИСТИЧЕСКИХ МЕТОДОВ В ИССЛЕДОВАНИЯХ
ГЕНЕТИЧЕСКИХ ТЕКСТОВ. ОСНОВНЫЕ ЗАДАЧИ

Представьте себе, что Вам в руки попала книга на неизвестном язы-
ке. Можно ли понять правила этого языка и извлечь из книги какую-ни-
будь информацию? С похожей задачей столкнулись биологи и математики
в конце 70-х годов сразу после появления методов определения после-
довательностей нуклеотидов в ДНК. Первые попытки ее решения были
связаны с подробным статистическим анализом прочитанных генетических
текстов, например определением частот встречаемости различных слов и
сравнением этих характеристик у различных организмов. Поэтому первые
работы по статистическому анализу нуклеотидных последовательностей
напоминали порой демографические справочники - приводилась подробная
статистическая информация, но вопросы о том, по каким законам запи-
сан генетический текст, как выявить в нем функционально значимые об-
ласти, что в нем играет роль знаков препинания и т.д., нисколько не
прояснялись. Можно ли с помощью статистического анализа ДНК извле-
кать из прочитанных генетических последовательностей нужную "смысло-
вую" информацию и выявить законы формирования и "работы" генетичес-
кого текста? Положительный ответ на этот вопрос был дан в начале
80-х годов после появления алгоритмов поиска функциональных областей
в первичных структурах ДНК.

Здесь мы кратко опишем основные содержательные задачи статисти-
ческого анализа ДНК, рассматривающиеся в этой главе.

Выбор моделей генетических текстов. Не зная еще полностью язык
генетических текстов, мы вынуждены угадывать некоторые особенности в
расположении нуклеотидов и пытаться понять, могли ли зти особенности
возникнуть случайно или же они специфически связаны с биологическими
свойствами. Известно множество вопросов подобного рода, в частности:
является ли случайным понижение частоты встречаемости динуклеотидов
СО во фрагментах эукариотической ДНК (В1г<1, 1980) или как объяснить
повышение частоты встречаемости олигонуклеотидов вида ХКУ(ЮкУКУ в
большинстве известных нуклеотидных последовательностей (Агдиез,М1-
сЪе1,1987) и др.

Для решения этих проблем необходимо прежде всего предложить мо-
дель порождения генетического текста и проверить ее адекватность на
реальных примерах. Различные модели генетических текстов рассматри-
ваются в п.2.2. Изложенные там общие принципы используются и при
формировании моделей функциональных зон и функциональных сигналов,
применяющихся для разметки генетических текстов (см. гл.3,4).

 Построение "словарей” генетических текстов. Попытка найти ра-
зумную аналогию между генетическим и человеческим языком приводит к
вопросу: что в генетическом тексте следует считать аналогами для
букв, слов и предложений? Задумаемся прежде всего о том, что превра-
щает комбинацию букв в слово языка? Очевидно - наличие функциональ-
ного, смыслового значения.

"Сцепление” отдельных букв в словах приводит к вполне определен-
ным последствиям с точки зрения статистики. Например, если про-
анализировать частоты встречаемости всех троек подряд идущих букв
в каком-нибудь тексте на английском языке, то обнаружится, что трой-
ка ТНЕ (определенный артикль) встречается подозрительно часто. Даже
человеку, не сведущему в английском языке придется предположить, что
слово ТНЕ в этом тексте несет некоторую смысловую нагрузку.

Подобный подход к генетическим текстам активно используется в
лингвистике ДНК, при этом набор неожиданно часто (или редко) встре-
чающихся слов был назван словарем генетического текста. Для построе-
ния словарей генетических текстов необходимо уметь отвечать на воп-
рос, какие отклонения частот встречаемости слов от ожидаемых значе-
ний следует считать значимыми. Например, если слово ТСАТС 133 раза
встретилось в геноме фага лямбда - много это или, наоборот, мало?

При ответе на этот вопрос необходимо:

- построение адекватных математических моделей порождения генетичес-
ких текстов;

- предсказание частот встречаемости слов в рамках выбранной модели;

- оценка статистических параметров моделей порождения генетических
текстов.

В п. 2.3 рассматриваются рассматриваются вопросы, возникающие при
реализации статистического подхода к построению словарей генетичес-
ких текстов.

Заметим, что в последнее время были обнаружены такие закономер-
ности в распределении частот встречаемости кодонов в геномах ряда
организмов (Вогобочзку, Сизе1п-2а(1е, 1989), которые дают дополнитель-
ные аргументы для предположения, что, в рамках аналогии между
генетическими и лингвистическими текстами, роль буквы в кодирующих
областях генома может играть тройка нуклеотидов - кодон, а роль сло-
ва может принадлежать достаточно протяженной части нуклеотидной по-
следовательности гена - экзону (Сгизк1п, 5ш1111,1987).

Выявление зонной структуры геномов. Представьте себе, что вам в
руки попал сборник рассказов разных авторов на неизвестном языке,
только напечатанных подряд, без всяких знаков пунктуации и пробелов.
Можно ли восстановить (хотя бы приблизительно) начало и конец каждс-
го рассказа (т.е. выявить "швы" между рассказами различных авто-
ров)? По-видимому, единственная надежда на решение этого вопроса -
статистический анализ "стиля” различных писателей (например, частот
встречаемости каких-нибудь слов), ведь при переходе границы между
рассказами стиль должен меняться.

Согласно современным представлениям, геномы некоторых организмов
составлены из различных частей. Например, в середине 70-х годов была
выдвинута гипотеза о модульном строении геномов бактериофагов, сог-
ласно которой геномы бактериофагов состоят из некоторых частей - мо-
дулей, при этом модуль понимается как "дифференцированный сегмент,
детерминирующий определенные функции". При выявлении в геномах
швов между зонами, имеющими различные статистические свойства,
используются различия частотных словарей слева и справа от потенци-
альных швов (см. п.2.4).

Меры близости генетических текстов и анализ статистической зна-
чимости гомологий. Одна из основных задач компьютерного анализа ДНК
- выявление сходства (гомологии) различных генетических текстов. На-
личие такого сходства может служить признаком эволюционной близости
геномов или функционального сходства рассматриваемых участков. При
интерпретации результатов сравнения генетических текстов возникает
вопрос, можно ли найденное сходство считать значимым или оно возник-
ло случайно? С развитием банков данных и пакетов программ по молеку-
лярной биологии этот вопрос стал звучать все чаще, особенно в ситуа-
циях, когда "биологические" аргументы в пользу сходства рассматрива-
емых фрагментов отсутствовали. Статистический анализ не дает исчер-
пывающего ответа на этот вопрос. При его помощи, однако, можно оце-
нить уровень сходства, вероятность случайного возникновения которого
ничтожна мала.

Другой практический вопрос, который следует решать с учетом ста-
тистической значимости гомологий - выбор размеров зонда и условий
гибридизации при скрининге библиотек генов. Для локализации генов
при скрининге стараются использовать зонд, комплементарный нужному
участку генома, - в этом случае проходит гибридизация: зонд-ген. Од-
нако выбранный зонд может случайно оказаться комплементарен (или
почти комплементарен) и другим участкам генома - в этом случае гиб-
ридизация будет идти не только с локализуемым геном и процесс скри-
нинга значительно осложнится (Певзнер,Миронов,19876). Если вы хотите
облегчить эксперименальную работу и исключить неспецифическую гибри-
дизацию, скажем, в 99% случаев, вам нужно знать статистические ха-
рактеристики гомологии между зондом и геномом.

Для оценки уровня значимости гомологий нужно сформировать мате-
матическую модель порождения случайных текстов, а затем теоретически
или с помощью метода Монте-Карло оценить статистические характерис-
38
тики распределения значений уровня сходства между случайными текста-
ми заданной длины.

Таким образом, вопрос выбора адекватной модели порождения генети-
ческого текста тесно связан с вопросом о статистической значимости
гомологий. Анализ различных моделей порождения текстов может помочь
установить связь между статистической и биологической значимостью
гомологий (см. п.2.5).

Статистические методы в теории молекулярной эволюции. Расшифро-
ванные первичные структуры ДНК явились очень удобным объектом для
сравнительного изучения с позиций теории эволюции, вооруженной мето-
дами статистики и дискретной математики. Подробное изложение этих
вопросов можно найти в книге Ратнера и др. (Ратнер и др.,1985). Мы
же в п.2.6 остановимся на таких характеристиках ДНК, как энтропия и
избыточность, которые оказываются полезными при сравнении способов
организации генетической информации различных таксономических групп.

2.2. СТАТИСТИЧЕСКИЕ МОДЕЛИ ГЕНЕТИЧЕСКИХ ТЕКСТОВ

Зачем нужны модели? Один из распространенных способов применения
статистических моделей генетических текстов связан с изучением "нес-
лучайных" особенностей в первичной структуре ДНК. Суть применяемого
метода состоит в следующем. Анализируемый текст интерпретируется как
элемент некоторой совокупности текстов. В силу объективных причин
эта совокупность в целом может оказаться недоступной для исследова-
теля, и тогда она создается искусственно - генерируется с помощью
статистической модели. На полученном множестве текстов могут уже
быть рассчитаны вероятностные распределения значений тех признаков,
которые интересуют биолога. Если при этом окажется, что наблюдавшие-
ся на исходном объекте величины признаков характерны для "хвостов"
распределения и имеют малую вероятность, например Р < 0,001, то эти
данные могут считаться неслучайными в математическом смысле. Такие
результаты, полученные с помощью моделей, дают формальное основание
для дальнейшего изучения биологических и физических причин найденных
закономерностей.

Для анализа нуклеотидных последовательностей используются статис-
тические Модели разных типов. Они различаются по степени общности,
по способу реализации и по применяемому методу моделирования. Под
степенью общности имеется в виду то, насколько широким или узким яв-
ляется класс ситуаций, для которого используется модель. Мы можем
рассматривать модель нуклеотидной последовательности вообще, модель
первичной структуры ДНК организмов определенного таксона, модель оп-
ределенной функциональной зоны или даже функционального сигнала.

По способам реализации модели можно разделить на аналитические и
численные, подразумевая под этим способ вычисления статистических
характеристик.

В зависимости от применяемых методов можно выделить класс моде-
лей, использующий аппарат марковских цепей (с аналитической или чис-
ленной реализацией), и класс моделей, в которых применяются более
общие методики, объединенные под названием методов Монте-Карло и ре-
ализуемые, как правило, численно.

Простейшие марковские модели. Сложность разработки модели,
по-видимому, возрастает с уменьшением степени ее общности. Так, нук-
леотидную последовательность общего типа можно представить с помощью
генератора символов А,Т,С,С, порождающего каждый символ текста неза-
висимо и с равной вероятностью. Достоинство такой модели в том, что
из нее легко получить приближенные формулы для вероятности встречае-
мости в тексте заданного числа любых нуклеотидных слов и соответст-
венно получить моменты распределений - среднее, дисперсию и т.д.
Несмотря на то, что простейшая модель слишком груба для применения к
реальным нуклеотидным последовательностям, она быстро дает удобные
количественные оценки порядка величин.

Первым уточнением равновероятной модели будет поправка на частоту
встречаемости, характерную для одной из нитей ДНК данного организма
(или целого таксона). Например, мононуклеотиды Т,С,А,С в последова-
тельностях ДНК эубактерии Е.со11 из третьего выпуска базы данных
ЕМВЬ (135 тыс. нуклеотидов), встречаются с частотами Гт = 0,243,
1С = 0,243, = 0,252, = 0,262. Использование этих величин
в модели с независимым порождением каждого нового символа дает текст
более близкий к реальному. Забегая вперед, назовем зту модель мар-
ковской цепью нулевого порядка.

Второе уточнение связано с тем, что в реальных первичных структу-
рах ДНК мы видим явные предпочтения в "выборе" нуклеотидами своих
соседей (см. далее), которые принцип независимого порождения не учи-
тывают. Этот дефект модели можно устранить, если ввести новое поня-
тие - условную вероятность встречаемости нуклеотидов. Например, ве-
роятность появления нуклеотида А, при условии, что его соседом с 5'
стороны является нуклеотид Т будет обозначаться Р(А|Т). Если извест-
ны 16 условных вероятностей Р(Ь|а), а,Ь = Т,С,А,С, то их можно ис-
пользовать для генерирования модельной последовательности. Рассмот-
ренная модель имеет название марковской цепи первого порядка, а ве-
личины Р(Ь|а) называются также переходными вероятностями марковской
цепи.

Значения Р(Ь|а) можно определить, если известны частоты моно- и
динуклеотидов в выборке текстов - 1(а) и Г(аЬ), а,Ь,=Т,С,А,С - по
формуле

Р(Ь|аЫ(аЬ)/Г(а). (2.1)
Заметим, что мы традиционно выбираем направление 5'—3', хотя
можно изучать и цепи с физическим направлением 3'--5'.

Модели с меньшим числом параметров удобнее использовать, но в ря-
де ситуаций имеет смысл обращаться и к марковским моделям более вы-
соких порядков. Например, известно, что тип третьего нуклеотида ко-
дона связан с типом двух первых нуклеотидов нестрогой зависимостью,
которая специфична для организма и типа гена.

В общем случае определение переходных вероятностей для модели по-
рядка п требует знания частот встречаемости слов, состоящих из п+1
символа. Тогда, согласно принципу максимального правдоподобия,
значение переходной вероятности

Р(ЫаА-о.> - ' а.'ь-Т'С’4'0'

Вопрос о выборе порядка марковской модели для описания генетичес-
кого текста рассматривался неоднократно. Было установлено
(Сагс1еп,1980), что для расшифрованных геномов вирусов М52, 5740 и
ФХ174 можно использовать модели нулевого, второго и третьего порядка
соответственно и получать достаточно точные статистические характе-
ристики этих геномов. В работе Блэйсделла (В1а1зйе11,1985) было по-
казано, что большинство из исследовавшихся таги эукариотических пос-
ледовательностей может быть представлено марковскими цепями не ниже
2-го порядка, а другие - не ниже 3-го. Исследование нуклеотидных
последовательностей Е. со11 привело Филлипса и соавт. (РМШрз еФ
а1., 1987а,Ь) к выводу, что частоты встречаемости тетра-, пента-, и
гексануклеотидов достаточно хорошо предсказываются марковскими цепя-
ми 3-го порядка, хотя в некоторых случаях наблюдаемая частота встре-
чаемости вдвое отличалась от ожидаемой.

Встречаемость ди- и тринуклеотидов. Рассмотрим иерархию марков-
ских моделей последовательностей ДНК. При этом нам потребуются ре-
зультаты статистического (1-граммного) анализа известных нуклеотид-
ных последовательностей. Эти данные имеют, помимо того, и достаточно
интересную биологическую интерпретацию.

Метод 1-граммного анализа, предложенный Шенноном (1963) для изу-
чения лингвистических текстов, сам по себе является эффективным
средством исследования нуклеотидных последовательностей (Гусев и
др., 1980). Существует тесная связь 1-граммного анализа последова-
тельностей ДНК и моделирования ДНК с помощью марковских цепей. Суть
этой связи характерна для понятий анализа и синтеза. Закономерности,
обнаруженные путем 1-граммного анализа, можно вложить в модель в ви-
де переходных вероятностей. Результаты, к которым приводит такая
модель, могут либо совпасть с данными, полученными на реальном
объекте (последовательности), либо стать основой для выявления
новых закономерностей, которые в свою очередь могут быть исполь-
зованы для построения модели следующего уровня. Иллюстрация этого
положения последует далее.

Прежде всего необходимо сказать о моделях первого порядка и о ре-
зультатах анализа встречаемости динуклеотидов, которые непосредст-
венно связаны с параметризацией этих моделей.

В работах Нуссинов (Ыиззтпоу, 1984 а,Ь) был выполнен анализ 400
последовательностей ДНК, взятых из разных организмов, что в сумме
составило более чем 500 тыс. нуклеотидов. Были подтверждены предва-
рительные данные (Ыиззтпоу, 1980 а,Ь) о том, что в ДНК различных
таксономических групп существуют устойчивые асимметрии в частотах
встречаемости динуклеотидов. Так, например, в большинстве из 88 про-
кариотических последовательностей частоты встречаемости динуклеоти-
дов таковы, что имеет место соотношение 1(СС)>1(АТ)>Г(ТА), а в боль-
шинстве из 256 эукариотических последовательностей
1(С6)>Г(СС)>Г(6Т)>1(ТА)>Г(С6).

Можно строго показать, что закономерности встречаемости динуклео-
тидов не соответствуют модели нулевого порядка. Обозначим через
Ы(аЬ) число динуклеотидов типа аЬ, встретившихся в группе последова-
тельностей с суммарной длиной Ы нуклеотидов. Согласно модели нулево-
го порядка, ожидаемое число динуклеотидов типа аЬ равно П*Г(а)*Г(Ь),
где 1(а) и Г(Ь) - частоты мононуклеотидов. Это число обозначим
<Ы(аЬ)>. Полагая среднеквадратическое отклонение величины Ы(аЪ) рав-
ным <ЩаЪ)>1/2, вычисляем значения б(аЬ)=(П(аЬ)-<П(аЬ)>)/<П(аЬ)>1/2.

ТВ	СТ	СС	АБ	АА	СА	6Б	ТТ	БА	ТС	БС	АТ	АС	БТ	ТА	СБ

11,291 (1,26) (1,18) (1,16) (1,15) (1,15) (1,14) (1,07) (1,04) (1,00) (0,99) (0,85) (0,84) (0,82) (0,65) (0,42)

ТТ	АА	БС	6Б	СА	СС	СТ	ТБ	ТС	БА	АБ	СБ	АТ	АС	БТ	ТА

(1,22)	(1,20)	(1,13)	(1,17)	(1,04)	(1,02)	(1,01)	(1,01)	(1,01)	(0,97)	(0,96)	(0,92)	(0,91)	(0,90)	(0,86)	(0,79)

0

СС	6Б	ТТ	АА	ТБ	СТ	АБ	СА	БА	БС	ТС	АС	АТ	БТ	ТА	СБ

(1,22) (1,19) (1,16) 11,14) (1,14) (1,12) (1,09) (1,07) (0,99) (0,99) (0,94) (0,89) (0,88) (0,85) (0,79) (0,58)
в

Б6 АБ	СС	СТ	ТА	БС	ТТ	АА	АТ	СА	ТБ	БА	ТС	АС	БТ	СБ

(1,51) (1,16)	(1,14)	(1,09)	(1,06)	(1,04)	(1,02)	(1.00)	(1,00)	(0,96)	(0,94)	(0,93)	(0,93)	(0,92)	(0,79)	(0,62)

г

ТБ СА	СТ	ТС	6Б	БА	АА	ТТ	СС	АТ	АБ	БС	АС	БТ	ТА	СБ

(1,30) (1,20) 11,11) (1,11) (1,09) (1,08) (1,07) (1,07) (1,03) (1,02) (0,98) (0,98) (0,91) (0,82) (0,64) (0,61)

А

СС СТ ТБ ТТ 6Б АБ АА БА СА БС АС ТС АТ БТ ТА СБ
(1,18) (1,18) (1,15) (1,15) (1,12) (1,11) (1,10) (1,08) (1,03) (0,95) (0,94) (0,92) (0,84) (0,84) (0,78) (0,64)
е

Рис. 2.1. Приведенные частоты динуклеотидов в эукариотических ор-
низмах и их вирусах

а - позвоночные; б - беспозвоночные; в - ДНК вирусы; г - митохон-
дрии позвоночных; д - РНК вирусы (без ретровирусов/; е - ретровирусы
Значения частот расположены в порядке их убывания

Если бы модель нулевого порядка была адекватным описанием нуклео-
тидных последовательностей, то величина 1 = 2^[с1(аЬ)]2 имела бы рас-
пределение хи-квадрат с девятью степенями свободы. При рассмотрении
42
первичной структуры ДНК Е.соИ величина Ф принимает значение 2986.
Согласно таблицам распределения хи-квадрат (Крамер,1975), такой ре-
зультат позволяет отвергнуть гипотезу об адекватности модели нуле-
вого порядка с уровнем значимости 10‘4.

Подобное утверждение справедливо и для нуклеотидных последо-
вательностей других организмов (Мизз1поч, 1984а). Обозначим через г
величину отношения фактической частоты динуклеотидов к частоте ожи-
даемой по модели нулевого порядка. На рис.2.1. в каждой строке, от-
ражающей определенную эукариотическую таксономическую группу, поря-
док следования динуклеотидов определяется по убыванию параметра г.
Таким образом, на левом конце строк расположены предпочтительные, на
правом - дискриминирующиеся динуклеотиды.

Видно, что во всех случаях хромосомная ДНК позвоночных и ДНК их
митохондрий, ДНК непозвоночных, нуклеотидные последовательности ДНК
вирусов, ретровирусов и других РНК-содержащих вирусов имеют свои
специфические частоты встречаемости динуклеотидов, которые не согла-
суются с моделями нулевого порядка. Кроме того, можно заметить, что
распределение динуклеотидов в ДНК эукариот в целом отлично от расп-
ределения динуклеотидов в ДНК прокариот (рис.2.2). Например, в эука-
риотах динуклеотиды ЕН и УТ встречаются с повышенной частотой по от-
ношению к УН и НУ. Нуссинов (Ыиззшоч, 1981а,Ь) предположила, что об-
наруженные закономерности распределения динуклеотидов связаны с фи-
зико-химическими особенностями строения двойной спирали ДНК. В част-
ности, дискриминация УН и КУ динуклеотидов в эукариотах связана с
большими стереохимическими трудностями упаковки УН и НУ участков в
нуклеосомах по сравнению с ЕЕ и УУ.

АА 6С ТТ Тб С6 АТ СА ТС БА СС СТ 6Б БТ АС АБ ТА
(1,26) (1,20) (1,14) (1,13) (1,11) (1,02) (1,00) (0,97) (0,96) (0,94) (0,94) (0,94) (0,91) (0,89) (0,83) (0,77)
.а'

АА 6С	ТБ	ТТ	СБ	АТ	СА	ТС	СТ	БА	СС	БТ	66	АС	АБ	ТА

(1,29) (1,19)	(1,17)	(1,13)	(1,12)	(0,99)	(0,99)	(0,97)	(0,96)	(0,96)	(0,94)	(0,94)	(0,92)	(0,90)	(0,82)	(0,75)

6

АА БС	ТБ	СТ	66	ТТ	ТС	СБ	6А	АТ	СА	АС	СС	БТ	ТА	АБ

•(1,27) (1,18)	(1,14)	(1,11)	(1,07)	(1,06)	(0,99)	(0,99)	(0,97)	(0,96)	(0,95)	(0,94)	(0,92)	(0,85)	(0,82)	(0,79)

в

Рис. 2.2. Приведенные частоты динуклеотидов в прокариотах
а - бактерии; б - Е.соИ; в - фаги (кроме М52)

Означает ли это, что марковские модели первого порядка, опреде-
ленные по статистике динуклеотидов (и, стало быть, теперь учитываю-
щие важные закономерности, обусловленные стереохимией двойной спира-
ли ДНК), должны являться адекватной моделью природных нуклеотидных
последовательностей.

В этой связи уместно вспомнить работу Фитча (ЕИсй 1983), посвя-
щенную определению ожидаемой частоты встречаемости комбинаций нукле-
отидов, которые могут быть ответственны за образование шпилечных
вторичных структур РНК, содержащих "ножку" из спаренных по правилу
Уотсона - Крика одноцепочечных участков и "петлю”.

Ранее (Ми11ег, РИсй, 1982) была обнаружена повышенная частота
встречаемости подобных структур в межцистронных промежутках фагов и
вирусов по сравнению с частотами, определенными по модели нулевого
порядка. Теперь же, задаваясь размерами ножки и петли, Фитч вычислил
ожидаемые частоты встречаемости шпилек для вируса 5740 по моделям
первого порядка (табл.2.1) и показал, что вероятность наблюдаемого
распределения шпилек на шесть порядков выше, чем было установлено
ранее. Тем самым обнаруженный ранее феномен "неслучайных" шпилек
оказался вполне рядовым явлением.

Таблица 2.1

Наблюдаемые и ожидаемые

частоты встречаемости шпилечных структур

Показатель |			Длина ножки
1  1	1 |	2 1	3 |	4 1	5 1	6 1	> 7 |	Е
Частота		По модели нулевого			порядка
ожидаемая	13853	3581	925	239	61,8	16,0	5,54	18682
наблюдаемая	13285	3477	987	245	82	28	14	18118
Хи-квадрат	23,0	3,0	4,2	0,2	6,6	9,0	12,8	58,6
Частота		По модели первого			порядка
ожидаемая	13305	3651	1002	275	7,55	20,7	7,75	18337
наблюдаемая	13285	3477	987	245	82	28	14	18118
Хи-квадрат	1,69	8,29	0,22	3,27	0,6	2,57	6,55	23,15

Позволяют ли однородные марковские цепи объяснить явление селек-
ции кодонов (Ыизз1поу,1981Ь;А1шайог,1983)? Ведь известны и другие
точки зрения.

Стратегия использования кодонов связывается с формированием опре-
деленной конфигурации вторичной структуры мРНК, оказывающей влияние
на скорость синтеза белка на рибосомах (Назе^ауа еф а1.,1979). Пра-
вила селекции кодонов можно интерпретировать с точки зрения дискри-
минации "предтерминирующих" кодонов, т.е. кодонов, которые при заме-
не (мутации) одного нуклеотида превращаются в терминирующие (Моб!апо
еФ а1.,1981). Ясно, что уменьшение числа предтерминирующих кодонов
повышает мутационную устойчивость генома.

Достаточно убедительно выглядит и "энергетическая" гипотеза (Сго-
ззеап,Е1егз,1982), отражающая тот факт, что наиболее часто встре-
чающимися являются кодоны со средним значением энергии кодон-анти-
кодонового взаимодействия, а кодоны, сильно или слабо взаимодейству-
ющие со своими антикодонами, дискриминируются. По мнению авторов,
такая стратегия использования кодонов позволяет клетке создать наи-
лучшие условия для элонгации белковых цепей.
Существует и другая популярная точка зрения, которая также имеет
в виду оптимальные условия биосинтеза белка и обращает внимание на
тот факт, что наиболее активно используемые из синонимических кодо-
нрв в прокариотах и эукариотах соответствуют наиболее распространен-
ным из изоакцепторных тРНК (1кешига 1981,1982; Веппефгеп.Вепбзаппп,
1982). Такой подход делает понятным и наблюдаемое повышение частот
использования таких кодонов в генах ДНК Е.соИ и 5. сег 1и1з1ае, обла-
дающих наиболее сильной экспрессией по сравнению с менее сильно экс-
прессируемыми генами.

Таким образом, альтернативная точка зрения на природу селекции
кодонов основывается на существовании корреляции характеристик се-
лекции кодонов с показателями эффективности механизма трансляции.

Новые аргументы в пользу этого представления вытекают из статис-
тического анализа первичных структур ДНК генома эубактерии Е.соИ
(Бородовский и др.,1986 а,Ь) и приводятся ниже.

Марковские модели функциональных областей генома. Рассмотрим по
отдельности кодирующие и некодирующие области генома Е.соИ. Практи-
чески для этой цели из выборки фрагментов ДНК Е.соИ длиной 135 тыс.
нуклеотидов были выделены две подвыборки длиной 80,0 и 42,5 тыс.
нуклеотидов, состоящие из белок-кодирующих и некодирующих областей
соответственно.

Прежде всего было отмечено что разные функциональные области раз-
личаются частотами встречаемости мононуклеотидов (табл.2.2).

Таблица 2.2

Частоты встречаемости нуклеотидов (1) и среднеквадратичные
ошибки определения этих величин (з) для различных выборок

Выборка	1	1	Г	!	1	1	3
Е.соИ в целом	0,243	0,243	0,252	0,262	0,0012
Области
кодирующие	0,231	0,251	0,246	0,272	0,0015
некодирующие	0,259	0,231	0,261	0,248	0,0020

Затем рассматривается вопрос, являются ли характеристики динукле-
отидных корреляций устойчивыми по всей длине генома Е.соИ, или же
они различаются в кодирующих и некодирующих областях. Для этого по
статистике динуклеотидов в общей выборке и двух функциональных под-
выборках определяются переходные вероятности для трех марковских мо-
делей первого порядка (табл.2.3).
Таблица 2.3

Значения переходных вероятностей

Пер-
вый
мухле
отвд

Общая выборка

(А)

Некодмруюцяе
области

(Б)

Кодирующие
области

(В)

Второй нуклеотид

т | С I й 1 6 I Т | С I й I 6 I Т | С | й | 6

Т	0,2Ь7	0,235	0,185	0,309	0,309	0,220	0,208	0,264	0,234	0,247	0,173	0,346

С	0,235	0,222	0,251	0,296	0,234	0,234	0,273	0,264	0,231	0,215	0,235	0,319

й	0,242	0,222	0,325	0,214	0,253	0,207	0,318	0,222	0,232	0,236	0,329	0,207

6	0,229	0,294	0,244	0,233	0,238	0,270	0,246	0,246	0,224	0,305	0,243	0,228

Заметим, что в каждом из этих трех случаев переходные вероятности
удовлетворяют системе уравнений

Е Р(Ь|а)Га = Гь, а,Ь = Т,С,А,С,	(2.2)

где Га, Гь - частоты мононуклеотидов в соответствующей выборке
(табл. 2.2).

Ясно, что величины Р(Ь|а), рассчитанные для общей выборки после-
довательностей Е.соИ (табл.2.ЗА), должны занимать некоторое проме-
жуточное положение по отношению к соответствующим величинам Р(Ь|а)
для кодирующих и некодирующих областей (табл.2.ЗБ,2.ЗВ), что, как
нетрудно убедиться, имеет место. Решить вопрос о возможности статис-
тически значимого совпадения параметров корреляции соседних нуклео-
тидов для кодирующих и некодирующих областей можно при помощи вычис-
ления статистических критериев.

Определим величины Фнк и Фкн (индекс к соответствует коди-
рующим областям, а индекс н - некодирующим) согласно формулам

Чх = 2 [И„(аЬ) - Нн(а),Рк(Ь|а)]/[Нн(а)"Рк(Ь|а)]1/2,
Чн = 2 [Ик(аЬ) - Нк(а)-Рн(Ь|а)]/[Нк(а)-Рн(Ыа)],/2.

Если характер корреляции соседних нуклеотидов в кодирующих и не-
кодир,тощих областях одинаков, то величины Фик и должны иметь
распре целение хи-квадрат с двенадцатью степенями свободы
(В1Г 1пйз1еу, 1961). Фактические значения Фик и Фкн равны 1556 и
1568 соответственно. Это позволяет отвергнуть гипотезу о совпадении
характеристик корреляции с уровнем значимости 10’4 и сделать вы-
вод, что в одном и том же организме различные функциональные области
первичной структуры ДНК должны описываться разными статистическими
моделями.

Далее стало ясно, что полученная марковская модель кодирующей об-
ласти не учитывает еще некоторые важные закономерности. Дело в том,
что частоты встречаемости моно- и динуклеотидов в кодирующих облас-
тях зависят от позиции, отсчитываемой относительно инициирующего ко-
дона. Остановимся на этом подробнее.

Множество всех возможных позиций сгруппируем по "рамкам". Позиции
1+Зк, к=0, 1,.., т.е. первые позиции кодонов, составляют первую рам-
ку. Позиции 2+Зк, к=0, 1,... образуют вторую рамку, а позиции З+Зк,
к=0,1,... - третью. Динуклеотиды будем относить к первой рамке, если
их первые нуклеотиды расположены в первой рамке и т.д.

Тогда частота встречаемости нуклеотида а в 1-й рамке Га -
это отношение числа нуклеотидов типа а к общему числу нуклеотидов -
Ы/3 из данной рамки. Значения Га, 1=1,2,3 представлены в
табл.2.4. Возможная случайная ошибка в определении этих частот оце-
нивается величиной 0,008. В табл.2.4 подчеркнуты те значения частот
Г‘а, которые наиболее отклоняются от среднего значения частоты
Га в кодирующих областях.

Таблица 2.4

Позиционные частоты нуклеотидов

Рамка	1 Т	1 с	1 А |	6
1	0,140	0,240	0,249	0,371
2	0,289	0,255	0,311	0,175
3	0,263	0,288	0,180	0,270
Е	0,231	0,251	0,246	0,272

Отмеченные отклонения могут быть связаны с различными факторами.
Так, уменьшение содержания Т в первой рамке и А в третьей обусловле-
но запретом на кодоны ТАА, ТСА и ТАО. Увеличение содержания 0 в пер-
вой рамке и С в третьей подтверждает указанное ранее (ЗЬерЬегб,
1981) предпочтительное использование кодонов типа ЙЛТ (й-пурин,
У-пиримидин), которое связывается с особенностями архаического гене-
тического кода. За относительное увеличение содержания Т во второй
рамке ответственны периодические серии синонимических кодонов, коди-
рующих неполярные аминокислотные остатки, входящие в состав аль-
фа-спиралей белковых молекул (2Ьигк1п,1981). Наконец, увеличение со-
держания А и уменьшение содержания С во второй рамке обусловлено
тем, что 14 кодонов, имеющих А во второй позиции, соответствуют 7
аминокислотам, в то время как 15 кодонов, содержащих во второй пози-
ции С, кодируют только 5 различных аминокислот.
Неравномерное распределение частот встречаемости нуклеотидов по
позициям противоречит модели белок-кодирующей нуклеотидной последо-
вательности в виде однородной марковской цепи, поскольку такая мо-
дель предсказывает одинаковые частоты появления нуклеотидов одного и
того же типа в любой позиции (см.табл.2.1). Отсюда вытекает, что
первоначальная модель может быть уточнена с помощью позиционно зави-
симых статистик.

Позиционные модели кодирующих областей. Обозначим число динук-
леотидов типа аЬ, которые встретились в 1-й рамке через Д/аЬ).
Рассмотрим простейшую позиционную (неоднородную) модель нуклеотидно-
го текста кодирующей области, в которой соседние нуклеотиды незави-
симы, но вероятности их появления различны в разных позициях относи-
тельно инициирующего кодона. Согласно этой модели, ожидаемое число
динуклеотидов типа аЬ, которое должно встретится в рамке с номером
1, будет равно Д'Г‘а’?‘*'ь/3 для 1=1,2 и Д'Р/Г'ь/З для 1=3.

Гипотезу об адекватности простейшей позиционной модели
можно проверить с помощью вычисления величин б,(аЬ)
[Д1(аЬ)-<Д1(аЬ)>]/С<Д1(аЬ)>,/2], для 1=1,2,3 соответственно. Если
эта модель справедлива, то величины

<;, = ^ [6/аЬ)]2, а,Ь = Т,С,А,С
должны иметь распределение хи-квадрат с девятью степенями свободы.
Реальные значения I, для 1=1,2,3 равны 1504, 3719 и 246 соответст-
венно. Отсюда следует, что предполагаемая модель с уровнем значимос-
ти 10’4 неточна и что опять-таки соседние нуклеотиды с вероят-
ностью 0,9999 не могут считаться независимыми.

Возникает естественный вопрос, зависят ли от позиции параметры
корреляции соседних нуклеотидов? Проведем исследование "от противно-
го", т.е. проверим противоположную гипотезу о совпадении параметров
корреляции. Зададим величины ф и 1; по формуле

= Е [Д,(аЬ) - Д,(а)-Р/Ь|а)]/[Д1(а)-Р/Ь|а)]'/2,

где 1 и з являются индексами рамок. Если характер зависимости со-
седних нуклеотидов в рамках 1 и а одинаков, то величины Ф и
Ф должны иметь распределение хи-квадрат с двенадцатью степенями
свободы. Поскольку	Ф12=20265,	Ф21=946, Ф23=7319,	Ф32=12230,

Ф31=11544, Ф13-9118, то с уровнем значимости 10‘4 можно утверждать,
что зависимость между соседними нуклеотидами в разных позици-
ях проявляется по-разному.

Для того чтобы учесть в новой модели зависимость от позиции пара-
метров корреляции соседних нуклеотидов, определим три матрицы пере-
ходных вероятностей Р.(Ь|а), по формулам

Р1(Ь|а) = Д/аЬ)/Д/а), а,Ь=Т,С,А,С, 1=1.2,3.
Реальные численные значения приводятся в табл.2.5 для 1 = 1,2,3 со-
ответственно.

Таблица 2.5

Позиционные переходные вероятности

Первый
иуялео	1=1	1=2	1=3

тид

Второй нуклеотид

Т1С|А)Б1Т|С|Й16|Т|С1А|6

Т	0,384	0,264	0,207	0,143	0,246	0,253	0,100	0,401	0,148	0,228	0,236	0,392

С	0,329	0,167	0,271	0,233	0,240	0,276	0,173	0,311	0,146	0,201	0,257	0,399

А	0,329	0,198	0,378	0,092	0,212	0,260	0,325	0,206	0,128	0,239	0,261	0,367

6	0,199	0,264	0,331	0,207	0,417	0,411	0,051	0,120	0,137	0,296	0,241	0,326

Еще раз обратившись к использованию критерия хи-квадрат, можно
показать, что во всех трех рамках параметры корреляции значимо отли-
чаютя от параметров корреляции соседних нуклеотидов в некодирующих
областях (на уровне значимости 10’* 4 * 6 * В). Этот факт довольно интере-
сен, так как свидетельствует о том, что структура кодирующей облас-
ти, адаптированная эволюцией к выполнению функции передачи генети-
ческой информации, во всех звеньях (позициях) испытывает специфичес-
кое селективное давление на подбор соседних нуклеотидов, и это дав-
ление проявляется с большей силой, чем наблюдавшиеся нами ранее тен-
денции предпочтения определенных соседей в некодирующих областях.

Отметим также, что между позиционными переходными вероятностями и
позиционными мононуклеотидными частотами существуют связи, аналогич-
ные уравнениям (2.2),

Е Г‘а»Р‘(Ь|а) = Г‘*'ь , 1 =1,2 , Е Га -РЭ(Ь|а) = Гь.

Таким образом, определена неоднородная марковскую цепь первого
порядка с периодически повторяющимися переходными матрицами
Р‘(Ь|а) (и позиционно-зависимыми финальными вероятностями Г‘а,
значения которых совпадают со значениями позиционных частот встреча-
емости нуклеотидов).

Следует подчеркнуть, что в классе неоднородных марковских моде-
лей, так же как в классе однородных, можно рассматривать марковские
Цепи различных порядков. Например, простейшая неоднородная цепь Мар-
кова нулевого порядка в данном случае будет задаваться тремя набора-
ми вероятностей появления нуклеотидов каждого типа (в трех позициях
кодона).

В работе Бородовского и др.(1986Ь) было показано, что распределе-
ние частот встречаемости кодонов может быть удовлетворительно предо-
казано на основе неоднородной модели первого порядка для кодирующей
области. В то же время попытка использовать для этой цели однородную
модель, описывающую геном в целом (А1та§ог,1983), не привела к успе-
ху. Этот результат является дополнительным аргументом в пользу того,
что динуклеотидные корреляции в кодирующих областях являются вторич-
ным признаком по отношению к явлению селекции кодонов, причины кото-
рого обусловлены особенностями механизма трансляции.

В ряде ситуаций представляют интерес неоднородные марковские мо-
дели и более высокого порядка. Например, неоднородные модели второго
порядка используются в алгоритме распознавания кодирующих областей
(гл.З). Контекстная зависимость встречаемости третьего нуклеотида
кодона от нуклеотидов 5'-соседнего кодона, специфичная у генов с
разной степенью экспрессии (ЗНраег, 1986; Бородовский и др.,1988),
означает, что для моделирования первичных структур генов с высокой и
низкой экспрессией требуются неоднородные модели третьего порядка.

В заключение подчеркнем, что, разумеется, при увеличении порядка
марковской цепи и введении таких усовершенствований, как позиционные
переходные вероятности, точность моделей будет повышаться. Однако
ограниченность объема экспериментального материала делает практичес-
ки бессмысленными попытки применения моделей наивысших порядков,
т.е. в каждом конкретном случае необходимо выбрать приемлемый, с
точки зрения поставленной задачи, порядок и тип модели.

В следующем разделе мы остановимся на таких, активно обсуждаемых
в настоящее время вопросах, как использование марковских моделей ге-
нетических текстов для предсказания частот встречаемости слов и фор-
мирования "словарей".

2.3.	СЛОВАРИ ГЕНЕТИЧЕСКИХ ТЕКСТОВ

Как построить словарь генетического текста. Нуклеотидные после-
довательности морфологически являются непрерывными текстами без вся-
ких знаков препинания, поэтому выделение в них "слов" (строк симво-
лов, имеющих некоторый "биологический" смысл) - непростая задача.
Выделению значимых слов в генетических текстах посвящена книга Три-
фонова и Брендела (Тг11опоу,Вгепс1е11986), при этом отмечено, что из-
вестные в настоящее время несколько сотен таких слов представляют
лишь малую долю словаря, используемого Природой. Концепция "словаря"
генетического текста была введена в работе Брендела и др. (Вгепбе!
е! а1., 1986), при этом под словами понимались короткие последова-
тельности (1-граммы) с неожиданно высокой (или низкой) частотой
встречаемости в тексте. При предсказании частоты встречаемости слова
в тексте используется частота встречаемости подслов. Например, ожи-
даемую частоту встречаемости п-буквенного слова Вр-.-В,, можно вы-
числить через наблюдаемые частоты встречаемости (п-2) и (п-1) - под-
слов по формуле (марковская модель (п-2)-го порядка)

Е(В......В )=(Г(В.....В„ .)«Г(В2.....ВП))/Г(В2.....В ,) . (2.3)

Здесь через обозначена наблюдаемая частота встречаемости
комбинации символов IV.

Для оценки степени отклонения от ожидаемых значений можно исполь-
зовать величину зМ(^)=( Г(1)-Е(1))/(Е(1))1/2 и называть IV "словом",
если зФб(^) превышает некоторое пороговое значение, например 3,0.

В работе Брендела и др.(Вгепс!е1 е! а1.,1986) были построены гис-
тограммы распределения значений зМ(Ш) для всех 1-грамм при 1=3,6 на
выборке генов Е.соИ. Сравнение этих гистограмм с гистограммами,
построенными для случайных последовательностей, выявило значительные
отличия, особенно для 3- и 4-грамм. При этом слова для ко-
торых зМ(Ш)>3, составляют лишь небольшую долю от всего чис-
ла слов - именно эти слова и образуют словарь генетического текс-
та. В ряде работ (Вгепбе! еФ а1 1986; Весктапп еФ а1, 1986; и др.)
показано, что изучение словарей позволяет найти потенциальные регу-
ляторные сайты в последовательностях ДНК, а также выявить функцио-
нальное и эволюционное сходство последовательностей.

Так, например, словарь фага Т7 сильно отличается от словарей
Е.соИ и фага лямбда. Это может объясняться тем, что Т7 имеет собст-
венные ферменты, ответственные за репликацию и транскрипцию: разли-
чие словарей может отражать особенности генетических текстов, свя-
занные с работой именно этих ферментов.

Следует сказать, что к построению и особенно к трактовке словарей
генетических текстов следует подходить осторожно. Дело в том, что
остается неясным вопрос, при каких отклонениях от ожидаемых значений
частот встречаемости слов можно делать выводы об их биологической
значимости.

Для оценки значимости отклонений встречаемости слов от средних
значений необходимо знать дисперсию распределения встречаемости сло-
ва в тексте. В большинстве работ по лингвистике ДНК вопрос об уровне
значимости либо вообще обходят, либо считают, что среднеквадратичное
отклонение равно Е1/2, где Е - ожидаемое число встреч слова в тек-
сте.

Вопрос о частоте встречаемости слова в тексте(даже в случае прос-
тейшей модели независимого порождения букв) математически является
довольно сложным и требует привлечения аппарата производящих функции
и теории функций комплексного переменного. Этот вопрос был всесто-
ронне исследован в работах Гоулдена и Джексона, Гуибаса и Одлыжко
(СоиЫеп,Даскзоп, 1979; Си1Ьаз,Об1угко, 1981). Там же подчеркнуто, что
вероятностные характеристики частот встречаемости слова в тексте за-
К.тат=1+0'х+1 "х2+О’х3
АТ АТ

Кдтдт(1/4)=1+1/16

Р и с.2.3. Процедура вычисления автокорреляционного многочлена

К в точке 1/4

Коэффициенты многочлена Кж=к0+к1х' + ...+кп 1хп'1 слова V,
состоящего из п букв определяются по правилу:

I 1, если первые п-1 букв и последние п-1 букв
к = -I слова IV совпадают

|_ 0, в противном случае

висят не только от вероятностей входящих в слово букв, но и от
структуры самопересечений слова, которая задается автокорреляционным
многочленом (рис.2.3).

Казалось бы все слова одной длины равноценны с точки зрения числа
их встреч в длинном тексте. Однако это не так: встреча слова АА 57С
раз в последовательности ДНК фага ФХ174 (5375 букв) - вполне нор-
мальное явление, а вот встреча АТ в такой последовательности 570, и
даже 540(!), раз - подозрительно частое событие. Таким образом, сло-
ва неравноценны и вероятность встретить слово в тексте к раз зависит
не только от числа букв в слове, но и от вида слова. Этот неожидан-
ный вывод, являющийся причиной целого ряда математических парадоксов
(Сагбпег,1974) до сих пор игнорируется во многих работах по статис-
тике ДНК. Ниже приводятся аналитические формулы для подсчета
дисперсии числа встреч слова при различных моделях порождения
генетических текстов.

Самопересечения слов и построение словарей генетических текстов.
Для оценки значимости отклонений от средних статистических характе-
ристик в генетических текстах необходимо получить выражение для дис-
персии числа встреч слова в тексте. При этом предполагается, что
фиксирована некоторая вероятностная модель порождения генетического
текста. Следует сказать,что в ряде работ (беШасМег, 1981;
БауЬоГГ,1984; Вгееп еф а1.,1985) получены довольно сложные аналити-
ческие формулы для вероятности к появлений фиксированного слова V в
случайном тексте, однако переход от этих формул к выражению для дис-
персии не представляется возможным. Рассмотрим сначала, как и в ра-
боте Бородовского и др.(1987), простейшую модель порождения текста
путем случайного независимого равновероятного появления букв
А,Т,С,С, а затем обобщим полученные результаты на случай более слож-
ных и адекватных моделей генетического текста (следует отметить, что
выявление аномально часто и редко встречающихся слов может произво-
диться и с помощью метода "случайного перемешивания", основанного на
перетасовке букв исходного текста (КагИп еФ а1.,1983)).

Рассматривается текст фиксированной длины п, в котором вероят
ности появления букв на произвольном месте I равны

1111

р =р =р =р = 0,25. Зафиксируем некоторое слово IV, например АТА. и
АТОС

1	2	3

рассмотрим распределение {р (п),р (п),...}, где р =р (п) - вероят-
V	'V	1 IV

ность встретить слово IV в тексте длиной п ровно 1 раз. Для вычисле-
ния дисперсии числа появлений слова IV в тексте длины п мы использо-
вали представление числа появлений слова IV в виде суммы случайных
величин (Речгпег еФ а1.,1989а).

Пусть X - случайная величина, характеризующая число появлений
слова V в тексте фиксированной длины п (для удобства вычислений рас-
сматривается кольцевая молекула длины п). Рассмотрим случайные вели-
чины (рис.2.4):

1~ 1, если на 1-м месте в тексте стоит слово IV
Х;=	- [

|_ 0, в противном случае

Р и с.2.4.Для слова 1=АТА и кольцевой	Т12 А,

молекулы длины 12, представленной на	Ам Т2

рисунке: х,,	х_, х =1, при этом	Т,„	А,

г(3,7)=4,	А	С

С8	А,

Т7 А6

п

Очевидно, что Х= Е х.. Математическое ожидание и дисперсия случайной
1=1

величины х, легко вычисляются

М(х,) = р{Х;=1}*1 + р{х1=0},0 = 1/5* ,

Б(Х; )=М(х.2 )-М(х.) "М(х( ) = р{х|2=1}'1-1/82* = (1/5* )•( 1-1/5* )

(здесь к - длина слова IV, а 5 - число букв в алфавите, в данном слу-
чае 5=4). Очевидно, что

п
МХ=М Е х,=п/5*.

1=1

Вывод формулы для ОХ достаточно сложен (Речгпег еФ а1.,1989а), и
мы не будем приводить его полностью. Конечная формула имеет вид
ОХ=п/зк (2К„(1/з)-1-(2к-1)/зк),	(2.4)

где К„(х) - автокорреляционный многочлен слова V.

Таким образом, при оценке значимости отклонений от средних значе-
ний к обычно используемому выражению для дисперсии п/зк следует
добавлять член

п/5к(2К„(1/5)-2-(2к-1)/5к),

который зависит от вида слова IV. Так, например, для двухбуквенных
слов

п	п

п	—	+	-(2-2-3/16)	=	(п/16)-(13/16),

АТ	16	16

п	п

О =	—	+	-(2.5-2-3/16)	=	(п/16)-( 21/16)

АА	16	16

(КАТ-1, Кдд=1,25).

Аналогично для трехбуквенных слов, в качестве дисперсии вместо
значения п/64 следует брать

Пдтс=(п/64)• (59/64), 0дтд=(п/64)*(67/64), 0ддд=(п/64)-(Ю7/64).

Из приведенных примеров видно, что при больших значениях автокор-
реляционного многочлена величина дисперсии распределения числа
встреч слова в тексте может значительно отличаться от величины его
математического ожидания. Таким образом, использование при оценке
значимости отклонений встречаемости слов величины МХ1/2 (Вгепбе! е!
а1.,1986; Весктапп е! а1.,1986) может приводить к смещенным резуль-
татам.

Для произвольных вероятностей появления букв {р(А),р(Т),р(С),р(С)},
таких, что р(А)+р(Т)+р(С)+р(С)=1 формула (2.4) переписывается в виде

ПХ=(п/рж)*(2Кж(р)-1-(2к-1)/р„) .	(2.5)

Здесь
к	к-1	1

р„= П р(»,), К„(р) = 1+ Е к/ П р(»|),	(2.6)

1=1	1=1	1=1

где 1»! - 1-я буква слова IV, к! - 1-й коэффициент автокорреляционно-
го многочлена.

Оказывается, что для марковских цепей дисперсия частоты встречае-
мости слова также описывается формулой, аналогичной (2.5). На осно-
вании формулы (2.5) для марковских цепей были сформированы словари
некоторых генетических текстов (Реугпег е! а1.,1989а). Показано, что
учет самопересечений слов меняет величину стандартного отклонения и
в некоторых случаях заставляет отказаться от утверждения о
значимости некоторых слов (или, наоборот, принять такое утвержде-
ние). Таким образом, учет самопересечений слов дает более точную
оценку значимости отклонений частот встречаемости слов от средних
значений.

Разнесенные 1-граммы и предсказания частот встречаемости слов.
При анализе генетических текстов функционально значимыми могут ока-
заться не только непрерывные, но и разнесенные слова (мы будем назы-
вать их разнесенными 1-граммами). В качестве примеров можно привести
сайт узнавания рестриктазы В^И: ССС----ССС (5 нуклеотидов между
разнесенными последовательностями ССС и ССС могут быть произвольны-
ми) или классические блоки Прибноу и Гильберта: ТТСАСА—...—ТАТААТ
(в этом случае расстояние между блоками может варьироваться). Возни-
кает вопрос о предсказании частот встречаемости разнесенных 1-грамм.

При предсказании частот встречаемости разнесенных 1-грамм можно
применять формулы, аналогичные формуле (2.3), например для предска-
зания частоты встречаемости слова А—С—С использовать частоты вст-
речаемости разнесенных подслов:

Е(А-С-С) = ША-О-ПС-СШНС). (2.7)

В работе Певзнера и др. (Реухпег еФ а1.,1989а) было показано, что
предсказания частот встречаемости для разнесенных 1-грамм оказывают-
ся значительно более надежными, чем для непрерывных 1-грамм; таким
образом словари для для разнесенных 1-грамм оказываются более ком-
пактными, чем для непрерывных.

Представляет интерес вопрос о размере "дырок" 1-граммы, при кото-
ром возможны надежные предсказания частот встречаемости(ведь и неп-
рерывную 1-грамму можно рассматривать как разнесенную с "дыркой" ну-
левого размера). Ответ на него представлен в табл. 2.6., где приво-
дятся оценки качества предсказаний на серии 1-грамм

1 1
(1=0,15) с дырками размера 1.

Анализ табл. 2.6 позволяет выявить интересную закономерность: ка-
чество предсказания частот встречаемости разнесенных 1-грамм сущест-
венно зависит от размера "дырки": при 1=2(тобЗ),т.е при расстоянии
между соседними буквами 1-граммы, кратном 3 (1-граммы вида *--*--*,
*-----*----* и т.д.) получаются значительные отклонения от наблю-
даемых частот(строки, соответствующие таким 1, выделены звездочкой в
табл.2.6), в то время как при расстоянии, не кратном 3, качество
предсказания оказывается очень высоким.

Следует заметить, что эта тенденция отчетливо проявляется даже
Таблица 2.6
Оценка качества предсказания частот встречаемости разнесенных
1--грамм вида	( 1-размер "дырки")

1	ЬАМВПА	Т7	АВ2	ЕВУ		ЬАМВПА	Т7	АВ2	ЕВУ
0	3,5	3,3	2,1	4,4		26	29	18	64
1	1,5	1,5	1,0	2,0		11	7	1	16
2*	1,1	2,1	2,0	4,1		2	17	14	36
3	1,0	1,1	0,8	2,4		0	1	1	23
4	0,8	1,0	0,7	2,3		0	1	1	17
5*	1.3	1,9	1,8	4,2		4	14	14	45
6	0,8	1,1	0,6	1,4		0	0	0	6
7	0,8	1,1	0,8	1,2		0	0	0	3
8*	1,3	1,1	1,8	3,3		3	1	7	36
9	0,8	1,1	0,7	1,6		0	4	1	9
10	0,8	0,9	0,7	1,5		0	1	1	4
И*	1,3	1,3	1,6	3,4		3	5	8	36
12	0,8	1,0	0,7	1,2		0	2	0	3
13	0,8	1,0	0,7	1,2		0	1	0	8
14*	1,5	1,1	1.5	3,8		3	3	3	38
15	0,7	1,0	0,6	1,5		0	0	0	6
16	0,9	0,8	0.7	1,2		0	0	0	2
17*	1,2	1,3	1,5	2,9		3	4	6	36

Примечание. В левой половине таблицы представлены средние
значения |з!,с1(Ю| по всем разнесенным 3-граммам IV. В правой
половине таблицы представлено число "плохих" предсказаний,
т.е. число разнесенных 3-грамм IV ,для которых зМ(Ю>3.0.
Строки, соответствующие 1=2(тос13), выделены звездочкой.

при больших размерах "дырок". Можно предположить, что аномально вы-
сокие расхождения, наблюдающиеся с периодом 3, связаны с зависимос-
тями, накладываемыми генетическим кодом, при этом "дальнодействие"
таких зависимостей довольно велико (Бородовский и др.,19866).

Для предсказания частот встречаемости слов было предложено
(Реухпег е! а1.,1989а) использовать статистические характеристики
разнесенных 1-грамм. Так, например, для трехбуквенных слов формулы

Е(АСС)-(Г(А_С)-Г(АС))/Г(А) и Г(АСС)=(Г(А_С)• Г(СС) )/Г(С) (2.8)

имеют ничуть не меньше "прав на существование", чем обычная формула
Е(АОС)=(1(АС)*Г(СС))/Г(С). Более того, ранее было отмечено, что для
разнесенных 1-грамм предсказание частот встречаемости оказывается
более надежным. Показано также (Реухпег е! а1.,1989а), что разнесен-
ные 1-граммы - более стационарные слова (см. п.2.4), чем соответ-
ствующие непрерывные 1- граммы. Учитывая эти соображения, можно
предположить, что включение в формулы предсказания статистических
характеристик разнесенных 1- грамм приведет к лучшим результатам,
чем обычно используемая формула (2.3).

Для трехбуквенных слов можно предложить формулу
Е(АСС)=[( Г(АП)2-Г(СС)2-Г(А_С)2 )/( Г( А) • Г(С) • Г(С) )]1/3, (2.9)
в которой все 2-граммы (как непрерывные, так и разнесенные), входя-
щие в слово АСС, представлены равноправно. Для четырехбуквенных слов
формула, учитывающая статистические характеристики разнесенных
1-грамм будет иметь вид

/ (Г(АСС)3-Г(АС Т)3-Г(А СТР-ПОСТ)3) \ 1/6

Е(АССТ)= -----------------=-------=-----------------Л .	(2.10)

\ (Г(АС)’Г(СС),Г(СТ)*Г(А_С),Г(С_Т)*Г(А__Т) /

Аналогичные формулы можно привести для 1-грамм любой длины.

В работе Певзнера и др.(Речгпег е! а!.,1989а) было показано, что
формулы (2.9) и (2.10) дают лучшие предсказания, чем формула (2.3).
В качестве критерия качества предсказания можно использовать коли-
чество 1-грамм со стандартными отклонениями от ожидаемых значений,
большими некоторого фиксированного числа (т.е. количество "плохих"
предсказаний). Например, для фага лямбда предсказание трехбуквенных
слов по формуле (2.3) дает 26 "плохих" предсказаний (Вгепбе! еГ
а!.,1986), а предсказание по формуле (2.9) - только 22.

2.4.	АНАЛИЗ ЗОННОЙ СТРУКТУРЫ ГЕНОМОВ

Неравномерное распределение слов в генетических текстах. При
предсказании частоты встречаемости слова в тексте используется сред-
няя частота встречаемости подслов. Например, (Вгепбе! е! а!.,1986)
предсказание ожидаемой частоты встреч Е(АСС) слова АСС опирается на
формулу (однородная марковская модель 1-го порядка)

Е( АСС)=Г( АС) • Г(СС)/Г(С),	(2.11)

использующую наблюдаемые частоты встреч подслов АС,ОС и С слова АСС.
При этом не учитывается, что подслова АС, СС и С могут быть неравно-
мерно распределены по генетическому тексту и подстановка их средних
частот в формулу (2.11) может привести к систематической ошибке. Та-
ким образом, однородные марковские модели (даже больших порядков)
далеко не всегда являются адекватной моделью генетического текста, и
иногда без учета неоднородности нельзя получить надежного предсказа-
ния числа встреч слова в тексте.

Еще в 1977 г. (Машко и др., 1977) расхождение теоретических и
экспериментальных данных о частоте встречаемости рестрикционных сай-
тов пытались объяснить неоднородностью исследовавшихся геномов. Для
описания неоднородных генетических текстов, т.е. текстов с различны-
ми статистическими характеристиками разных частей, можно предложить
общую модель неоднородной марковской цепи (Бородовский и др.,19866).
При введении неоднородной марковской цепи генетический текст разби-
вается на зоны, при этом каждая зона характеризуется своими переход-
ными вероятностями, которые определяются статистическими характерис-
тиками только этой зоны. Таким образом, при переходе к неоднородной
модели вместо рассмотрения одной (общей для всего текста) матрицы
переходных вероятностей (рн) приходится рассматривать Т матриц
переходных вероятностей, где I - число частей, на которые разбивает-
ся генетический текст. Такой подход позволяет показать, что для ряда
слов большие отклонения от ожидаемых частот встречаемости объясняют-
ся не "биологическим" смыслом, а неоднородностью генетического текс-
та (другой подход к неоднородности генетических текстов может быть
развит на основе анализа информационных профилей (С1ауег1е,
Вои^иеТегеФ,1986). Так, например, для фага лямбда, если не учитывать
неоднородность, слова ААА и ТТТ оказываются значимыми (стандартные
отклонения 4,75 и 4,78), в то время как при расчетах на неоднородной
марковской модели с длиной блока 360 стандартные отклонения для этих
слов оказываются меньше 3 (в дальнейшем будет показано, что ААА и
ТТТ - нестационарные слова в ДНК фага лямбда). По-видимому, в сло-
варь (Вгепбе! еф а1.,1986) значимых слов следует вводить лишь те
слова с большими отклонениями от ожидаемых значений, число появлений
которых не может быть предсказано и неоднородной моделью генетичес-
кого текста.

Стационарные и нестационарные слова в генетических текстах. Для
анализа неоднородных генетических текстов введем понятие стационар-
ных и нестационарных слов. Зафиксируем слово IV и размер окна Ь.
Обозначим через Г*(1), 1=1,Ы-Ь+1 - число появлений слова V в окне
размера Ь, начинающемся в позиции 1 (таким образом, Г„(1) -число
появлений слова V в позициях 1.....1+Ь-1).

Пусть ^(к) ~ количество позиций 1, для которых Гж(1)=к. Фун-
кция ё„(к) характеризует равномерность распределения слова IV в ге-
нетическом тексте: если IV относительно равномерно распределено по
тексту, то имеет четко выраженный "пик", в противном случае
2„(к) скорее похоже на "плато". В работе Певзнера и др.(Реухпег е!
а1.,1989Ь) анализировались функции е„(к) для различных слов IV. Для
всех рассматривавшихся текстов оказалось, что вид функции §ж(к)
существенно зависит от слова IV: функции ё„(к) для IV, состоящего
как из слабых, так и из сильных нуклеотидов, имели, как правило,
явно выраженный пик, а функции 2„(к) для IV, являющегося ро1у^- или
ро1уЗ-трактом, имели, как правило, вид плато ("слабыми" нуклеотидами
(^еак) мы называем А,Т, а "сильными" (З^гоп^) - С,С, ро1у^(ро1уЗ)-
58
Р и с.2.5. Графики функций ч (к)
(пунктирная кривая) и еАС(к) (непрерывная
кривая), характеризующие равномерность
распределения слов АА и АС в ДНК фага
лямбда. Функция ёАС(к) имеет четко
выраженный пик" (АС-стационарное слово) в
отличие от функции §дд(к) (АА - неста-
ционарное слово)

тракт - последовательность из слабых (сильных) нуклеотидов ). На
рис.2.5 в качестве примера приводятся функции §дд(к) и едс(к)).

Можно ввести среднее значение и среднеквадратичное отклонение для
распределения 1^(1):

Ы-Ь+1
м=1/(н-ь+1) Е г„(1) ,
1=1

Ы-Ь+1

6= (1/(Ы-Ь+1) Е (1*( 1 )-Е)2)1/2.
1=1

(2.12)

(2.13)

В большинстве работ по лингвистике ДНК среднеквадратичное откло-
нение для числа встреч слова в окне оценивается как М1/2 (ранее
было показано, что если пренебречь самопересечениями слов, то этот
вывод остается верен для марковских моделей порождения генетического
текста). Таким образом, увеличение б по сравнению с М|/2 свиде-
тельствует о неравномерности распределения слова в тексте. В качест-
ве меры нестационарное™ слова IV можно ввести отношение к=б/Е1/2:
для слова, относительно равномерно распределенного по тексту, к не-
велико (такие слова, т.е. слова с к<кгр , где кгр - пороговое откло-
нение, мы будем называть стационарными), в противном случае слово
называется нестационарным ( к>кгр ).

В табл. 2.7 представлены значения коэффициента неоднородности к
для двухбуквенных слов в исследовавшихся нами генетических текстах
(длина окна равна 1000). Если задать некоторый уровень значимости
(например, кгр=2), то окажется, что во всех случаях нестационарные
слова - ро1у)К- и ро1у5-тракты (единственное исключение - слово ТС в
геноме вируса Эпштейна-Барр,для которого к=2,3).

Таблица 2.7

Значения коэффициента неоднородности к
для двухбуквенных слов

1	|ЬАМВПА|	Т7 1	АС2 |	ЕВУ	|ВРЬВРО|Е.СОЫ
АА	3,1*	1,4*	3, 0*	2, 8*	1,4*	1,6*
АТ	2,3*	1,1	2,3*	2,9*	0,7	1,3
АС	1,2	0,9	1,2	1,7	1,1	1,5
АС	1,1	1,0	2,0	2,0	1,1	1,1
ТА	2,9*	1,2*	2,4*	2,8*	0,8	1,3
тг	2,9*	1,3*	2,9*	2,8*	2,0*	2,5*
тс	1,4	1,0	1,7	2,3	1,0	1,3
тс	1,0	0,9	2,0	1,7	1,1	1,3
СА	1,3	1,0	1,6	1,9	.0,9	1,3
СТ	1,8	1,1	1,9	1,9	1,1	1,3
СС	2,7*	1,2*	2,7*	2,6*	1,2*	1,6*
сс	2,6*	1,6*	2,6*	1,9	1,1	1,5*
СА	1,3	1,2	1,9	1,7	0,7	1,5
СТ	1,0	1,0	1,3	1,6	1,2	1,3
СС	2,8*	1,1	3,5*	2,5*	1,4*	1,4
СС	1,9*	1,2*	2,0*	3,5*	1,2*	1,5*
кг₽	1,87	1,17	2,02	2, 54	1,23	1,55

В табл.2.7 звездочками отмечены значения к>кгр, при этом все
отмеченные 2-граммы являются ро1у8- или ро1у1^-трактами (значения
кгр выбраны произвольно, длина окна равна 1000).

На рис.2.6 приведены графики коэффициентов неоднородности динук-
леотидов (динуклеотиды расположены в порядке убывания коэффициента
неоднородности), а на рис.2.7 - тринуклеотидов. ро1у!К- и ро1у8-трак-
там (выделены кружочками) соответствуют большие значения коэффициен-
тов неоднородности при этом видно, что геном фага Т7 и выборка
Е.со И - однородные генетические тексты (единственный нестационарный
Р и с.2.6. Графики коэффициентов неоднородности для динуклеотидов
в различных генетических текстах

Значения коэффициента неоднородности для динуклеотидов
к(1),1=1,16 упорядочены по убыванию и представлены на графике для
фага лямбда, аденовируса, вируса Эпштейна-Барр, фага Т7, выборки
генов Е.Со11. Значения к, соответствующие динуклеотидам АА,АТ, ТА,ТТ,
СС,СС,СС,СС (ро1у5- и ро1у!АГ-тракты) , представлены кружочками. Во
всех случаях кружочки сосредоточены в левой части графиков
(большие значения коэффициента неоднородности), т.е. ро!уЗ- и ро!уТ-
тракты - нестационарные слова в рассматриваемых генетических текстах
Р и с.2.7. Графики коэффициентов неоднородности для тринуклеотидов
в различных генетических текстах

Значения коэффициента неоднородности для тринуклеотидов
к(1), 1=1,64 упорядочены по убыванию и представлены на графике для
фага лямбда, аденовируса и вируса Эпштейна-Барр. Значения к,соответ-
ствующие тринуклеотидам ААА, ААТ, АТА, АТТ, ТАА, ТАТ, ТТА, ТТТ, ССС,
ОСС, ОСС, ССС, ССС, ССС, ССС, ССС (ро1уЗ-и ро 1 уV-тракты),выделены
маркерами. Видно, что во всех случаях маркеры сосредоточены в левой
части графиков (большие значения коэффициента неоднородности),т.е.
ро1уЗ- и ро1уТ-тракты - нестационарные слова в рассматриваемых гене-
тических текстах

динуклеотид в этих текстах - ТТ в выборке Е.соИ) в то время как ге-
ном фага лямбда, аденовируса и вируса Эпштейна-Барр состоят из бло-
ков различной статистической природы (однородность фага Т7 по нук-
леотидному составу была обнаружена довольно давно при помощи физико-
химических методов (Дэвидсон, Сцибальский,1975). Недавно Блейки
Ерли (В1аке,Еаг1еу,1986) провели компьютерный анализ нуклеотидных
последовательностей из Е.соИ и обнаружили высокую однородность по
динуклеотидному составу). Учет информации о нестационарных ро1у!»- и
ро1у5-трактах позволяет подойти к вопросу о зонной структуре ДНК и
предложить метод разбиения ДНК на зоны (следует отметить, что анома-
лии в распределении ро1у!К- и ро1у5-трактов в эукариотических ДНК
изучались в работах Блейсдела (В1а1зс1еН, 1983а,Ь)).

Зонная структура генома фага лямбда. Еще в 70-х годах (До-
ув,1975) была предложена гипотеза о модульной структуре геномов бак-
териофагов (в дальнейшем она была значительно развита Кемпбеллом и
Ботштейном(СатрЬе11,1977; СатрЬе11,ВоФзФе1п,1983)), при этом модуль
понимается как "дифференцированный сегмент, детерминирующий опреде-
ленные функции". Можно считать, что модуль - это последовательность
генов, способная к осуществлению определенной функции и обладающая
способностью к соединению с другими модулями при построении структур
более высокой иерархии - плазмид, фагов и т.д. Позднее Крылов
(1985) распространил понятие модуля и на субгенный уровень (см. так-
же СМ Поп еФ а1.,1982).

Анализ генома фага лямбда свидетельствует, что гены, обладающие
определенными функциями, расположены в нем не случайно, а сгруппиро-
ваны в блоки - группирование генов может иметь эволюционный смысл,
предотвращая разделение в ходе рекомбинации функционально связанных
генов и специфических регуляторных сайтов. Один из основных выводов
модульной гипотезы: наличие в природных популяциях фагов, возникших
как следствие почти свободного обмена отдельными модулями. Проверка
этого вывода для лямбдоидных фагов проводилась в серии работ (Кры-
лов, Цыганков,1976; Крылов и др.,1977; Кгу1оу,1981). Сускинд и Ботш-
тейн (Зиззк1пс1,Во1з1е1п, 1978) предположили, что негомологичные смеж-
ные модули должны быть ограничены по краям последовательностями нук-
леотидов, допускающими рекомбинацию, ведущую к обмену модулями.

В работе Певзнера и др. (Реугпег еФ а!.,1989Ь) была предпринята
попытка компьютерного анализа зонной структуры генома фага лямбда и
интерпретации ее в рамках модульной гипотезы. При этом предполага-
лось, что модули, имеющие разное происхождение, должны быть по-раз-
ному устроены статистически. Конечно, эти статистические различия
могут оказаться довольно тонкими и не выявляться на уровне примитив-
ного сравнения А,Т,С,С составов - ведь все модули одного генома ис-
пытывали уже в составе этого генома продолжительное эволюционное
давление, которое могло привести к сглаживанию исходных различий.
Поэтому при статистическом анализе использовалось различие частот
встречаемости стационарных 1-грамм, которые были введены в предыду-
щем разделе.

Ранее было показано, что генетические тексты не всегда можно
адекватно описать моделью однородной марковской цепи - возникает не-
обходимость выявления блочной структуры ДНК, т.е. разбиения ДНК на
некоторые блоки, удовлетворяющие условию: при переходе границы между
блоками статистические характеристики генетического текста меняются.
При определении блочной структуры ДНК (Реузпег е! а1,1989Ь) исполь-
зовались стационарные и нестационарные слова в генетических текстах.
Дело в том, что при определении границ между предполагаемыми блоками
необходимо определять разность 1-граммного состава между окном слева
от точки границы и справа от нее. Таким образом, позиция 1 рассмат-
ривается как потенциальная граница блоков, если разность 1- граммных
составов в окне слева (1-1,1-6) и справа от нее (1+1,1+6) велика.

Для определения разности 1-граммных составов, например при 1=2,
можно положить
г = 1/16 ё а2,
1=1 1

(2.14)

при этом в сумме будут учитываться все 1-граммы, как стационарные,
1г	1г

так и нестационарные ( здесь <1 =11 -11 , где 11 (11 ) - количество
111	11

2-грамм 1-го вида в левом(правом) окне). Поскольку распределение
нестационарных 1-грамм в тексте крайне неравномерно, учет их в фор-
муле (2.14) приведет к высокому уровню "шума" и появлению случайных
границ блоков. Более адекватным является подход, когда суммирование
в (2.14) идет не по всем, а лишь по стационарным 1- граммам, распре-
деление которых в тексте испытывает случайные Флуктуации в значи-
тельно меньшей степени, чем распределение нестационарных 1-грамм.
Таким образом, формула (2.14) переписывается в виде

т 2

г = 1/|5| Е б ,	(2.15)

1е5 1

где 5 - множество стационарных 1-грамм (выше было показано, что в
качестве 5 для 2-грамм можно рассматривать 8 динуклеотидов
АС,АС,ТС,ТС,СА,СТ,СА, СТ в качестве 3-грамм - 48 тринуклеотидов и
т.д.).

По критерию (2.15) была построена функция г (г вычислялось для
каждой позиции ДНК) фага лямбда(рис.2.8), при этом положение пиков
на графике соответствует предполагаемым границам между модулями. Со-
поставим эти графики и современные представления о модульной струк-
туре ДНК фага лямбда. На рис.2.8 функция г для фага лямбда сопостав-
лена с его генетической картой (5ап§ег е! а!.,1982). Можно выделить
семь пиков функции г (длина окна равна 1000, конкретные значения г
при изменении длины окна могут меняться,однако общая форма и положе-
ние пиков сохраняются), при этом положение пиков 3-7 соответствует
следующим элементам функциональной организации фага лямбда.

1.	Пик 3 - отделяет правый конец области структурных генов от лево-
го конца Ь-области (правая транскрипция). Функции генов
Ь-области неизвестны.

2.	Пик 4 - точка окончания основных правого и левого оперонов (в
работе (Запрет е! а1.,1982) точка 22 500 обозначена как
точка изменения направления транскрипции - в области пика
4 сталкиваются правая транскрипция с промотора рр и
левая транскрипция с промотора рь).

3.	Пик 5 - отделяет Ъ-область (левая транскрипция) от модуля генов
сайт-специфической рекомбинации, ответственного за ин-
теграцию и исключение фага.
зтаистикАЬ сеыез кестои __________________________

	ЗТКПСТОКАЬ СЕЫЕЗ КЕС10Ы *****-------------*
-------------------------------------------------Б=КЕсТОЯ-----
игхдЬР *

Ргапзсгхрйхоп* ЪгапзсгхрМоп

*

Р и с.2.8. Функция г для ДНК фага лямбда,сопоставленная с генетичес-
кой картой и современными представлениями о модульной структуре фага
лямбда

Положение пиков г обозначено крестиками хххх, а предполагаемые
границы модулей - звездочками ****.

3 Заказ И» 4327

65
5

б

7

40 I

30 I

20

10


24	25	26	27

Еа59 I

28

хх---

11пЪ I

29	30

- I -х— I

31	32	33	34	35	36

- I---I-----I----I -хх- I---|

I __ I
Еа31

Х13

Ёа Еа
85 22

I е| 6

I х|____

1Т1 1з|I
I П1з| I
|_|11Ы '

I г,
I

К11+С111

ш

Ь-КЕСЮЫ ******	**	**	**

1еЕС	81ТЕ-	—СЕНЕ? ------ПЕЕЕКХЕ--- ------

ЬгапасгхрМоп ЗРЕС1Р1С Н1ТН	КЕСОМВ1-

КЕсомв!- иыкноны ЫАТЮЛ'З
ЫАТ1О1ГЗ РОНСТЮМЗ СЕЫЕЗ
ОЕЫЕЗ	+

кП,сПХ,га1

40 1
I

136	37	38	39	4	41	42	43	44	45	46	47	48

I __I___I___I____I___I___I___I___ I _____ I_I_

'I|гех||с|||II	6	I	Р	11111	|'	I Н221101II'18|к|кг|

I 1_А_|	III I I	I I_I	||14|_|	I ||	|_|||	|_| |_|

_1	1_|с	II	I___I 161	II I___I I I	|_|

гех	г	г 290	207	64

Во	е

сП	п	68

* НЕРЫСАТЮЫ СЕЫЕЗ

"ГНИЛЕЕ--------+

КЕСХОЫ	П1П-КЕО1ОЫ

ЬАТЕ ОЕЫЕЗ___________
4.	Пик 6 - конец области сайт-специфической рекомбинации. Начало
области с неизвестными функциями.

5.	Пик 7 - отделяют гены общей рекомбинации (ехо,с,у) и Ш,сШ,
га1 (функции неизвестны) от области иммунитета в широ-
ком смысле.

Остались нерассмотренными два пика 1 и 2. Пик 2 попадает внутрь
гена И. Ген И фага лямбда контролирует два признака: реакцию фага на
специфические инактивирующие антитела и специфичность адсорбции. В
работах Крылова, Цыганкова и Диллона (Крылов, Цыганков,1976; ВЫ Поп
еФ а1.,1982) получены результаты, позволяющие предположить, что спо-
собность белка 1 к связыванию инактивирущего антитела и специфич-
ность адсорбции - два разделимых признака. Именно эти результаты, а
также работа Шоу и др. (ЗПатг еф а1. ,1977) привели к расширению мо-
дульной гипотезы до субгенного уровня (Крылов,1985). Таким образом,
пик в области гена Д может отражать наличие такого субгенного моду-
ля.

Анализ пиков функции г позволяет в ряде случаев попытаться уточ-
нить современные представления о модульной структуре фага лямбда.
Так, например, в настоящее время неизвестно точное положение границы
модуля структурных генов: до или после гена 1ош. Положение пика 3
(справа от 1от) позволяет высказать предположение о том, что модуль
структурных генов включает 1от.Положение пика 5 (левая граница гена
1пФ) позволяет предположить,что линкерная последовательность между
Ъ-областыо и генами сайт-специфической рекомбинации, локализована
ближе к левой границе гена 1пф.

Следует отметить, что при анализе функции г мы не имели теорети-
ческого обоснования для уровня порога, при котором пик можно рас-
сматривать как значимый. Для "строгого" выбора порога необходимо оце-
нивать параметры распределения "статистического расстояния" между
генетическими текстами (Миронов и Александров,1988). Эта задача воз-
никает при анализе алгоритмов "быстрого" поиска гомологий и является
довольно сложной - в настоящее время предприняты лишь первые попытки
ее решения (Певзнер,19886).

2.5.	СТАТИСТИЧЕСКАЯ ЗНАЧИМОСТЬ ГОМОЛОГИЙ

Для анализа статистической значимости гомологий необходимо решить
следующие вопросы:

-	выбрать модель порождения генетического текста;

-	определить понятие сходства (гомологии) генетических текстов;

-	оценить статистические параметры распределения уровня гомологии в
рамках выбранной модели.
Модели порождения текстов и значимость гомологий. В первых ра-
ботах по анализу статистической значимости гомологий использовалась
простейшая модель: буквы в последовательностях X и У порождаются не-
зависимо с вероятностями рд, рт, рс, рс для X и дд, дт, яо, рс для У.
Липман и др. (Ыршап ер а1.,1984) впервые обратили внимание на не-
адекватность такого подхода в связи с некоторыми особенностями
(асимметрия в распределении динуклеотидов (Пиззтпоч,1980а), А-сбло-
ченность (Пизз1поу,1980Ъ), АТ-богатые области (Могеаи е! а!.,1982))
нуклеотидных последовательностей, не укладывающимися в рамки модели
независимого появления букв.

Липман и др. (Ыртап е1 а1.,1984), выбрав 100 последовательностей
из банка нуклеотидных последовательностей СЕЛВАЫК, построили гистог-
рамму распределения уровня гомологии (различные подходы к определе-
нию уровня гомологии рассматриваются в следующем разделе) и сравнили
ее с гистограммами распределения уровня гомологии, построенными для
трех различных моделей:

-	случайное перемешивание с сохранением нуклеотидного состава;

-	случайное перемешивание с сохранением динуклеотидного состава
(Е11x11,1983);

-	случайное перемешивание с сохранением локального нуклеотидного
состава.

Было показано, что вид гистограмм может значительно меняться в зави-
симости от типа рассматриваемой модели. Таким образом выводы о зна-
чимости гомологий могут существенно зависеть от модели порождения
текста. В случаях, когда уровень сходства последовательностей оказы-
вается значимым в одной модели и незначимым в другой, становится яс-
но, какие статистические свойства нуклеотидных последовательностей
(например, динуклеотидная ассиметрия) привели к возникновению "лож-
ной" гомологии.

Различные подходы к понятию сходства генетических текстов.
В этом разделе задачи поиска гомологий рассматриваются, в отличие от
гл. "Поиск гомологий" как задачи поиска подпоследовательностей спе-
циального вида ( такой подход удобнее при анализе статистической
значимости гомологий).

Фиксированное выравнивание. Если рассмат-
риваются две последовательности одной и той же длины п
Х=(х,,...,хп ) и У=(у; ,...,уп),то уровень и фиксированного вырав-
нивания между ними определяется, как количество индексов 1, для
которых х^у,. Вероятность события х,=у( равна (через рв(пв) обозна-
чена вероятность появления буквы В в последовательности Х(У))

Р = РЛд+РтЧт+РаОс+РсПс-

Статистические характеристики уровня сходства и как случайной
величины в модели фиксированного выравнивания легко подсчитываются:
68
к к п-к

Р{и=к} = С -р -(1-р) ,
п

т=р-п ,
5=р*(1~р)*п

(здесь т и 5 - математическое ожидание и дисперсия для величины и в
модели фиксированного выравнивания).

Максимальные общие подпоследова-
тельности и подслова. Фиксированное выравнивание,
как правило, не рассматривается в качестве меры сходства, поскольку
оно не допускает "сдвигов" между сравниваемыми последовательностями.

АТССАТОА
а I II

АССТСАСА

АТССАТОА

б 17/\Н

АССТСАСА

АТССАТОА	АТССАТОА

В /// Г /////

АССТСАСА	АССТСАСА

Р и с. 2.9.Различные подходы к понятию сходства

а - фиксированное выравнивание; б - максимальная общая подпоследо-
вательность; в - максимальное общее подслово; г - максимальное об-
щее подслово с одним дефектом

При анализе генетических текстов иногда ищут максимальные общие под-
последовательности и подслова. Последовательности Х=АТССАТСА и
Х=АССТСАСА имеют при фиксированном выравнивании уровень гомологии 2.
в то время как длина максимальной общей подпоследовательности для

них равна 6 , а длина максимального

Общая подпоследовательность для
Х=у(,...,ук - это набор индексов
удовлетворяющий условиям

1,< ... <1г
1,< ••• <7

общего подслова - 3 (рис.2.9).
последовательностей Х=х,,..., хп и

....^,<7 )......

и x1=у^ для любого 1=1, ш.

Общее подслово -это набор индексов

(1+1,1+1)......(1+1,1+1),....(1+т,1+т),

удовлетворяющий условию х1Ф1=уне при 1=1,т. Число т называется дли-
ной общей подпоследовательности(подслова).

Таким образом, общее подслово - это общая подпоследовательность с
дополнительным условием: буквы в ней расположены подряд. Если "осла-
бить" определение максимальных общих подслов и рассмотреть макси-
мальные общие слова с одним допустимым дефектом в каждой из последо-
вательностей X и X на рис.2.9, то получится, что длина такого макси-
мального общего подслова равна 5 (на рис.2.9,д подчеркнутая буква А
в X образует "дефект").
Если разрешить два удаления, то мы придем к тому же результату,
что и при рассмотрении максимальных общих подслов (рис.2.96, буквы,
образующие "дефекты" выделены подчеркиванием).

Таким образом, понятия максимального общего подслова с к дефекта-
ми и максимальной общей подпоследовательности при достаточно больших
к совпадают. Вероятностные распределения для длины максимальных об-
щих подпоследовательностей и подслов рассматриваются ниже (см. "Тео-
ретические оценки для длины максимальной общей подпоследовательности
и максимального общего подслова.").

Оптимальное выравнивание. Выравнивание пос-
ледовательностей Х=х,,... ,хп и Х=У!,... ,ук - это последовательность
пар индексов (11,Л1),...<11,Зг),...(1т,Зт),удовлетворяющая условию

1,< ... <1г <....<1т,
31<	<<‘ • • • <

(в отличие от определения общей подпоследовательности, для выравни-
вания не требуется выполнения условияи х1 =у. для любого 1=1,ш).

Пары (1,э), для которых, х^у^ называются совпадениями, а пары,
для которых х,/уи- заменами. Элементы последовательности Х(Х), не
вошедшие ни в одну пару, называются удалениями в X (в X). Удаления в
X иногда называют также вставками. Такое определение выравнивания
эквивалентно введенному в главе "Поиск гомологий".

Под весом выравнивания, как и в гл. "Поиск гомологий", понимается
число Vткт-Vск<.-Vс|кс|, где ут - премия за совпадение (таФсЬ); уо -
штраф за замену (сЬап§е); - штраф за удаление (сЫеМоп); ^.к^,
кл - количество совпадений, замен и вставок соответственно.

Под оптимальным выравниванием понимается выравнивание с макси-
мальным весом, а под уровнем сходства последовательностей X и X (в
модели с штрафами) - вес оптимального выравнивания X и X .

Если принять штрафы за замены и делеции равными нулю
(ус,у<1=0), то мы придем к простейшему варианту задачи о выравни-
вании, когда поиск оптимального выравнивания эквивалентен поиску
максимальной общей подпоследовательности. При поиске оптимальных вы-
равниваний случайных последовательностей с этими параметрами обычно
оказывается, что 60% приходится на совпадения, 20% - на замены и 20%
на делеции. Если мы будем увеличивать от 0 до «= , то большие
штрафы за делеции приведут к тому, что число замен в оптимальном вы-
равнивании возрастет, а число делеций уменьшиться. При Уа=« и п=к
мы приходим к модели фиксированного выравнивания. Нас интересует
вопрос о том, какой уровень оптимального выравнивания между последо-
вательностями следует считать значимым, т.е. при каком уровне опти-
мального выравнивания можно делать выводы об эволюционной или функ-
циональной близости рассматриваемых фрагментов.
В гл. "Поиск гомологий" описаны алгоритмы поиска выравниваний
максимального веса. Получить аналитические формулы для статистичес-
ких характеристик оптимального выравнивания довольно сложно в связи
с большим числом потенциальных выравниваний. Этот вопрос рассматри-
вается ниже (см. "Статистическая значимость оптимального выравнива-
ния" ).

Точечные матрицы. Сходство между двумя нуклеотид-
ными последовательностями можно визуализовать на точечной матрице
(боФ- шаЕМх) (рис.1.1 гл. "Поиск гомологий"). При построении точеч-
ной матрицы фиксируется размер окна VI и рассматриваются пары окон,
одно из которых начинается в позиции 1 последовательности X, а дру-
гое - в позиции з последовательности X. Если последовательности X и
У, попавшие в выбранные окна похожи (например, уровень сходства меж-
ду ними превышает 0,75111 в модели фиксированного выравнивания), то на
пересечении 1-й строки и ^-го столбца точечной матрицы ставится точ-
ка. В результате гомологичным участком в X и X будут соответствовать
некоторые (идущие параллельно диагонали) линии из точек в точечной
матрице. Вопросы выбора параметров при построении точечных матриц и
связанные с ними вопросы статистической значимости гомологий обсуж-
даются ниже (см. "Гомологии и точечные матрицы.").

Теоретические оценки для длины максимальной общей подпоследова-
тельности и максимального общего подслова. Изучение статистических
характеристик для длины максимальной общей подпоследовательности на-
чалось в работе Хватала и Санкоффа (С1пгаШ,БапкоГГ, 1975), где были
Ьп
получены нижние и верхние оценки для величины 11т — (через Е
п-->~ п
обозначено математическое ожидание длины максимальной общей подпос-
ледовательности последовательностей Х=х1.....хп и Х=у(,..,уп). Легко

показать, что функция Ь супераддитивна, т.е. Ек+т > Ек+Ьт. Отсюда
следует, что

Е	к

11т —	= зир — = 5 .

п—>•» п	п п

Нижние оценки для 5 были получены с помощью построения простых
алгоритмов нахождения общих (не обязательно максимальных) подпосле-
доательностей. Хваталу, Санкоффу и Декену (СЬуа1;а1,5апкоП,1975;
Секеп,1979) удалось оценить вероятностное поведение этих алгоритмов
и в качестве нижней оценки использовать длину получающихся последо-
вательностей. При построении верхних оценок для 5 рассматриваются
оценки для числа пар последовательностей X и X, содержащих общую
последовательность 2 длины т (т=<п), и проводится усреднение по все-
возможным последовательностям 2.

С помощью этой техники показано, что для 4-буквенного алфавита
0,5454 < 3 < 0,7181 .

В дальнейшем Стил.,.{-31ее1е, 1982) показал, что дисперсия распределения
длины максимальной общей подпоследовательности невелика и оценивает-
ся как 0(п). Вопрос о более точных оценках для описания параметров
распределения длины максимальной общей подпоследовательности остает-
ся открытым, однако уже приведенные результаты могут быть использо-
ваны для оценки статистической значимости длины максимальных общих
подпоследовательностей.

Если длина максимальной общей подпоследовательности оценивается
как 0(п), то длина максимального общего подслова имеет порядок
О(1оеп). Арратиа и Ватерман (ИаФегшап,1984; АггаНаДаФегтап, 1985;
^аФегтап,1986) показали (тот же результат в несколько другой форме
был получен Каг11п е! а1.,1983), что математическое ожидание М(п,ш)
длины максимального общего подслова двух слов длины пит оценивает-
ся как

М(п,ш)=1ое( (1-р)пш) + а/р - 1/2 +г1(п,ш) + 0(1) ,

а дисперсия В(п,т) как

В(п,т)= гс2/(6р2) + 1/12 + г2(п,т) + 0(1).

Здесь логарифм берется по основанию 1/р (р - вероятность совпадения
двух произвольно взятых нуклеотидов в рассматриваемых последователь-
ностях), а=0,577... - константа Эйлера-Машерони, р=1п(1/р), а
величины г, и г2 относительно невелики. Для случая максимальных
общих подслов с к дефектами эти оценки имеют вид

М(п,ш)=1ое(пт) + к1о21ое(пт) + (к+1)1о§(1-р) - 1о§(к!) + к
+ а/р - 1/2 +г,(п,т) + 0(1),

В(п,т)= п2/(6р2) + 1/12 + г2(п,т) + 0(1).

Интересно отметить, что изучение статистических характеристик
уровня локальной гомологии (см. гл. "Поиск гомологий"), проведенное
с помощью метода Монте-Карло, также дало логарифмическую оценку
(5тШ1 еФ а1. ,1985).

Статистическая значимость оптимального выравнивания. В работах
Хватала, Санхоффа и Райха с соавт. ( СЬуаФа!, ЗапкоИ, 1975; КетсЬ. еф
а!.,1984) для п<8 с помощью перебора на ЭВМ были получены гисто-
граммы распределения уровня гомологии. Оказалось, что математическое
ожидание ш уровня оптимального выравнивания лежит в пределах 50-60%
(при нулевых штрафах за замены и удаления), а дисперсия з относи-
тельно мала (т.е. распределение имеет вид пика).
Известны попытки анализа статистических характеристик уровня го-
мологии методом статистического моделирования. Райх и др. (Ке1сй е!
а!.,1984) предлагают следующие эмпирические формулы, полученные пос-
ле аппроксимации результатов моделирования уровня гомологии с по-
мощью метода Монте-Карло (уа,7с=0):

т=ап1-01-Ь ,

5=сп°-3-с1 ,

(2.16)

(2.17)

где а=0,605, Ь=1,04, с=0,61, (1=0,23 для 12<п<1000. Эти формулы могут
быть использованы для грубой оценки статистической значимости гомо-
логий. Например, если нас интересуют гомологии 20-членных зондов, то
в соответствии с формулами (2.16) и (2.17) (ш=11.86, 5=1,27) уро-
вень гомологии до 15,67 можно считать фоновым (при стандартном отк-
лонении большем 3).

Формулы (2.16) и (2.17) находятся в хорошем соответствии с гипо-
тезой (Сй7а1а1,5апкоИ, 1975), согласно которой з=0(п1/3), и приво-
ь„
лившимися ранее оценками для 11т —•
п—->» п

Если ввести штраф за делеции Уа>0, то математическое ожидание ш
уровня оптимального выравнивания снизится. Райх и др. (Йе!ей еЬ
а1.,1984), учитывая, что при изменении Уа от 0 до «> мы переходим
от поиска максимальной общей последовательности к фиксированному вы-
равниванию, предложили формулы, позволяющие рассчитать статисти-
стическую значимость гомологий для моделей с штрафами за делеции.

Гомологии и точечные матрицы. Часть точек при построении точеч-
ной матрицы может появиться вследствие случайных причин. Ясно,что
такой "фон" является помехой для биолога, анализирующего точечную
матрицу. Если задаться некоторым уровнем значимости (например,
0,99), то можно поставить вопрос: как выбрать параметры построения
точечной матрицы (т.е. при каком уровне гомологии в окне следует
ставить точку), для того чтобы вероятность появления "случайной"
точки не превышала 1-0,99? Иными словами, биологу нужно выбирать та-
кие параметры построения точечных матриц, которые исключают (при не-
котором уровне значимости) "случайные" точки.

Если мы сравниваем две последовательности длины 1000, то вероят-
ность р проставления точки в произвольном месте должна быть дос-
таточно низкой: 10'6 или менее - в противном случае вся точечная
матрица будет испещрена случайными точками. Какой должна быть р,
для того чтобы с вероятностью 0,99 в точечной матрице для двух слу-
чайных последовательностей отсутствовали точки? К сожалению, для ре-
шения этого вопроса нельзя привлечь модель испытаний Бернулли: дело
в том, что хотя проставления точек в точечной матрице - редкие собы-
тия, однако они сильно коррелированы. Например, вероятность простав-
ления точки может быть очень маленькой - 10'6 и ниже, тем не менее
условная вероятность V может становиться очень высокой, если вблизи
от рассматриваемой позиции уже имелась точка. Поэтому оценка статис-
тических характеристик для заполненности точечных матриц представля-
ет довольно сложную проблему. При выборе параметров точечных матриц
важную роль играет вероятность V появления точки для анализируемого
окна при условии, что в смежных окнах точки отсутствуют. По значению
V можно оценить вероятность 5 того, что диагональ в точечной матрице
размера п окажется свободной от штрихов:

О, = (1-у)" = е~уп .

Если положить 5=0,95, то следует выбирать у=0,05/п . Формулы для V
(Ке1сЬ,Ме1зке, 1987) позволяют выбрать параметры при построении то-
чечных матриц. Так, например, если мы хотим оценить уровень фиксиро-
ванного выравнивания икрит в окне размера при котором следует
ставить точку (5=0,95), то можно использовать грубую оценку

икРит “ р^+[2р( 1-р)‘V’1п(п)]1/2.

Если оценивать вероятность Р гибридизации зонда длины V в геномной
библиотеке длины п, полагая, что зонд гибридизуется при наличии не
менее Ь совпадений, то можно воспользоваться формулой

{(р/з)8 [ (1-р)/( 1-5 ) ] 1 ’5}* • 5* (1 -р )

р ,	------------------------------------- ,

(2кз(1~з)^ )1/2(з-р)
где з=Ь/Ш.

Методы, предложенные Райхом и Майске (Ее1сЬ,Ме1зке, 1987), позво-
ляют оценить статистическую значимость заполненности точечной матри-
цы. Эмпирические формулы для выбора параметров, при которых снимает-
ся "случайный шум" при построении точечных матриц получены также в
работе Канехиса (КапеМза, 1984). Там же приводится анализ статисти-
ческой значимости так называемых локальных гомологий (Соаб, КапеЫ-
за, 1982).

2.6.	ДНК: ИНФОРМАЦИЯ И ЭНТРОПИЯ

Определение понятий. Понятие информации (от латинского
1п?огтаНо - разъяснение, изложение) в своем первоначальном смысле
означало - сведения, передаваемые людьми устным или письменным спо-
собом. Затем (с середины XX в.) оно стало общенаучным понятием,
включающим сведения, которыми обмениваются не только люди между со-
74
бой, но люди и автоматы (ЭВМ), автоматы и автоматы; включающим сиг-
налы в животном и растительном мире, в том числе признаки, передава-
емые от клетки к клетке, от организма к организму.

Теория передачи сообщений, развитая Шенноном, рассматривает поня-
тия информации и энтропии в узком смысле - применительно к анализу
символьных последовательностей.

Текстовая запись первичной структуры ДНК, как уже говорилось, вы-
зывает невольную ассоциацию с языковым, лингвистическим сообщением.
В этой связи возникает вопрос, могут ли названные понятия теории пе-
редачи сообщений, подобно ее методу 1-граммного анализа, оказаться
полезными для изучения генетических текстов. По-видимому, ясно, что
шенноновские информация и энтропия не эквивалентны по смыслу поняти-
ям генетической информации и физической энтропии. Введем формальные
определения. Рассмотрим эксперимент с п возможными исходами, имеющи-
ми вероятности осуществления Р1 = 1, 2, ...,п. Информация, которую
приносит сообщение о том, что реализовался определенный исход 1, по-
лагается равной

I = -1оё2Р,.	(2.18)

В частности, сообщение о выпадении орла или решки несет единичную
информацию.

Энтропия характеризует неопределенность в исходе эксперимента в
целом. По определению

8 = <1> = - Е Р11ое2Р1,	(2.19)

т.е. величина 8 тем больше, чем меньше априорная возможность пред-
сказания исхода эксперимента. 8 максимальна, если нет исходов более
вероятных, чем другие и, таким образом, все имеют одинаковую вероят-
ность 1/п. Тогда 8тах = 1о§2п.

Случай символьных последовательностей. Представим себе алфавит
из М знаков и последовательность из них длины П. Прежде всего, каж-
дый из символов можно интерпретировать как результат очередного экс-
перимента по выбору символа. Определив вероятности выпадения симво-
лов в эксперименте (Р,), можно вычислить величины I* и 8*, приходя-
щиеся на одну позицию текста по формулам (2.18), (2.19).

С другой стороны, можно говорить о последовательности в целом как
об исходе эксперимента по генерации текста из П символов. Это позво-
ляет ввести величины и 8М, характеризующие информацию и энт-
ропию, "сложного" эксперимента, включающего И "простых”. Ясно, что в
случае независимости "простых" экспериментов 1н = Е1‘(, так
как Рм -ПРГ

Если текст состоит из зависимых символов и представляется марков-
ской цепью, то информация на один символ (и энтропия) уменьшаются.
Например, для цепи первого порядка с известными переходными вероят-
ностями Р.р 1, з=1, п энтропия на символ

З1 = - ЕР/Е Рн-1о§2Р1Г (2.20)

Подобные формулы существуют для моделей текстов в виде марковских
цепей более высоких порядков.

Кроме энтропии, удобно ввести показатель избыточности текста

с;

Е = 1--------- . (2.21)
пах

Чем ближе величина 3 к максимальной, соответствующей полностью
случайному тексту, тем Е ближе к нулю, и наоборот, чем более корре-
лированы символы и "предсказуем" текст, чем легче восстанавливать в
нем пропуски, тем меньше 8 и тем ближе Е к 1. В текстах на современ-
ных языках - русском, английском, немецком - величина Е составляет
около 0,7.

Энтропия и избыточность нуклеотидных последовательностей. Фак-
тически, энтропия последовательности ДНК является компактной харак-
теристикой, отражающей степень сходства последовательности нуклеоти-
дов с последовательностью моделируемой серией равновероятных исхо-
дов. При вычислении энтропии некоторой, последовательности значения
частот употребления символов рассчитываются по этой же последова-
тельности. Это приводит к некоторым примечательным выводам.

Для бесконечной последовательности, состоящей из одинаковых сим-
волов, например ТТ...Т..., имеем Рт=1. Р1=0, 1=А,С,С. Значит
3*=0 и, кроме того, 1м=0, т.е. эта последовательность имеет ну-
левую шенноновскую информацию.

Используя результаты, полученные для ДНК Е.соИ в предыдущем раз-
деле, мы обнаруживаем, что кодирующие и некодирующие последователь-
ности ДНК имеют разную энтропию (см.табл. 2.8)

Таблица 2.8

Значения удельной энтропии и избыточности ДНК Е.соИ,
рассчитанные по разным моделям

Тип ДНК |	3°	1 3’ 1	3р1	| Е°	1 К1 1	КР‘
Области кодирующие некодирующие	1,9975  1,9978	1,9769  1,9878	1,778?	1,3-10*3  1,1-Ю'3	1,2-10'2  6,1-Ю'3	1,1-Ю'1
Здесь верхние индексы 0 и 1 обозначают величины, вычисленные по
однородным марковским цепям нулевого и первого порядка, а индекс
р1, соответственно - по позиционной марковской модели первого поряд-
ка (см. Бородовский и др.,1986а).

Приведенные данные показывают, что кодирующие области характери-
зуются большей избыточностью, и, следовательно, большей коррелиро-
ванностью расположенных рядом нуклеотидов по сравнению с некодирую-
щими областями. Интересно, что увеличение избыточности как характе-
ристики "ансамбля" текстов означает, что встречаемость текстов с оп-
ределенными правилами чередования символов будет преобладать над
другими. Шенноном было доказано утверждение, что если энтропия текс-
та на символ равна 5, то среди фрагментов длины И, выбранных из дан-
ного текста, с вероятностью, близкой к единице, встретятся не все
2М1О8ГМ возможных вариантов, а только 2м5 различных последователь-
ностей. Применительно к кодирующим областям, где 5Р|кодир=1,7787,
это означает, что если, например, рассматривать фрагменты длиной 100
нуклеотидов, то разнообразие фрагментов, реально встречающихся в ко-
дирующих областях Е.соИ в 4,6'106 раз меньше по сравнению с 4100
возможными последовательностями. Таким образом, в среднем только од-
на из 4,6'106 случайных нуклеотидных последовательностей имеет
такую же статистическую структуру, как и реальная кодирующая об-
ласть.

Энтропия и эволюционные связи генетических текстов. Величины
энтропии и избыточности различаются не только для различных функцио-
нальных областей ДНК, но и для ДНК разных организмов. Например, в
табл. 2.9 приведены значения Зий (определенные по марковским моде-
лям второго порядка) для геномов вирусов и плазмиды РВЕ322 (Гусев и
др.,1980).

Видно, что увеличение избыточности и одновременно уменьшение энт-
ропии происходит в ряду от М82 к 8У40. У генома М52, избыточность
которого минимальна, гены практически не перекрываются друг с дру-
гом. Геномы вирусов 04, ФХ174, 8740 имеют зоны перекрытия функцио-
нальных единиц иногда весьма обширные. Такого рода наложения увели-
чивают число ограничений, которым должна удовлетворять нуклеотидная
последовательность, и повышают ее избыточность.

Таблица 2.9

Значения функций энтропии и избыточности

Функция	| М82 |	РВЕ322	1- С4 |	ФХ174	1 ко 1	8У40
8	1,985	1,974	1,937	1,932	1,928	1,880
К	0,007	0,013	0,031	0,033	0,036	0,055
Полезными характеристиками генетических текстов являются вели-
чины:

О, = 5тах- 5.

В2 = 5 - 51,

Значение В, можно интерпретировать как меру отклонения рассматри-
ваемой последовательности от случайной, описываемой равновероятной
моделью. В свою очередь, величина В2 может служить мерой отклоне-
ния от модели, предусматривющей независимое порождение символов, но,
возможно, с неравными вероятностями (СаФ11п,1975). Заметим, что име-
ет место соотношение КЧое2М = О^Ог-

Например, было установлено (Ыртап,Ма1ге1,1982), что кодирующие
области внехромосомной ДНК эукариот имеют (при фиксированной величи-
не В) большее значение В1 и меньшее В2, чем кодирующие области ДНК
прокариот, бактериофагов, вирусов и хромосом эукариот. Это говорит о
том, что внехромосомные гены менее сбалансированы по нуклеотидному
составу, и соседние нуклеотиды в них менее з.ависимы, чем в генах
других типов ДНК. Другой результат, отмеченный теми же авторами,
заключается в том, что эукариотические кодирующие последовательнос-
ти, не содержащие интронов имеют (также при фиксированном значении
К) большую величину В1 и меньшую величину В2, чем кодирующие после-
довательности эукариот, включающие интроны. Это в известной мере яв-
ляется неожиданным, так как свидетельствует о том, что в интронах
наблюдаются корреляции соседних нуклеотидов, причем более сильные,
чем в экзонах.

Интересно, что на больших выборках кодирующих последовательностей
ДНК, величина П2 в ряду митохондрии, прокариоты, эукариоты - при-
нимает значения 0,019, 0,042 и 0,087 соответственно, что свидетель-
ствует об увеличении корреляции между соседними нуклеотидами молекул
ДНК в данном таксономическом ряду. Показано (Ыртап,1ШЬиг, 1983),
что этот эффект связан в первую очередь с увеличением коррелирован-
ное™ типов соседних нуклеотидов на границах кодонов.

В связи с тем, что в кодирующих областях ДНК возможно несколько
биологически обоснованных кодировок структуры молекул, возникает ес-
тественный вопрос - как это отразится на значениях информационных
характеристик.

Представим кодирующую область ДНК в виде последовательности кодо-
нов, т.е. в виде последовательности в алфавите из 64 символов. Вели-
чина энтропии на один символ здесь будет определяться по формуле
(2.19), в которой М=64, а величины Р( будут равны частотам встре-
чаемости кодонов 1=1, 2,.....64. Аналогично (при М=20) подсчитывает-
ся и энтропия аминокислотных последовательностей. Как уже говори-
лось, энтропия есть величина математического ожидания информации об
исходе эксперимента (см.2.19), поэтому энтропия на символ (удельная
энтропия) характеризует среднее посимвольное информационное содержа-
78
ние (в смысле Шеннона). Ясно, что величина удельной информации для
последовательности кодонов, будет превышать величину удельной инфор-
мации для той же последовательности, записанной в алфавите аминокис-
.лот, поскольку первая из них может рассматриваться как результат вы-
бора из большего числа возможных вариантов (в силу большей мощности
алфавита). Значения удельной энтропии кодоновых и аминокислотных
последовательностей реальных организмов приводятся в табл.2.10
(Копорка,1984).

Таблица 2.10

Значения удельной энтропии матричных РНК и белков

Группа организмов	Энтропия мРНК	Энтропия белка
РНК-вирусы	5,810	4,133
ДНК-вирусы	5,757	4,194
Бактерии	5,631	4,133
Позвоночные	5,600	4,090
Человек	5,522	4,155

Здесь видна интересная особенность: удельная энтропия кодоновых
последовательностей уменьшается по мере перехода к более высоким
ступеням эволюционной лестницы, хотя удельная энтропия аминокислот-
ных структур, кодируемых этими последовательностями кодонов, остает-
ся примерно постоянной. Таким образом, информационное содержание на
символ в кодоновых последовательностях в ходе эволюции уменьшается
(при одновременном увеличении длины генома) и увеличивается избыточ-
ность К, характеризующая помехоустойчивость генетического текста.
Такое развитие событий на уровне мРНК представляется вполне естест-
венным. С другой стороны, постоянство удельной энтропии первичных
структур белковых молекул (не претерпевших, в среднем, увеличения в
размерах по сравнению с низшими формами) говорит об их статистичес-
кой однородности в таксономическом ряду и достаточном "функциональ-
ном" совершенстве уже на начальной стадии эволюции. Указанная интер-
претация, по-видимому, находится в соответствии и с представлениями
теории '' нейтральности" (Кимура, 1985).

Используя марковские модели второго, третьего и т.д. порядков
можно определить и соответствующие величины удельных энтропий -
32,83 и т.д. Эти характеристики отражают корреляции в три-, тетра-
и т.д. нуклеотидах. Как можно использовать эти данные? Рассмот-
рим последовательность приращений Б, = Зтах - 5, П2 =3 -8',
Б3 = 81 - 82 и т.д. Значение Пк пропорционально доле инфор-
мации, которая содержится в 1-граммах порядка к относительно
1-грамм большего порядка. Анализ значений В2, и т.д. позво-
ляет обосновать выбор марковской модели данного генетического текс-
та, которая затем может быть использована, например, в компьютерных
процедурах распознавания (см. гл. 3,4).

2.7.ЗАКЛЮЧЕНИЕ

Исследование генетических текстов методами теории вероятностей и
математической статистики уже сегодня привело к установлению большо-
го количества закономерностей. Некоторые из них - закономерности
встречаемости ди- и тринуклеотидов - послужили основой для углубле-
ния представлении о физико-химическом строении ДНК, деталях механиз-
ма переноса генетической информации и т.д. Другие обнаруженные зако-
номерности, отраженные в значениях энтропии и избыточности текстов
ДНК, интересны с точки зрения исследования путей молекулярной эволю-
ции. Статистические особенности, свойственные нуклеотидным последо-
вательностям функциональных областей и отраженные в теоретических
(феноменологических) моделях, позволяют создавать компьютерные сред-
ства (программы) типа искусственного интеллекта для быстрой разметки
генетических текстов на функциональные единицы. Чрезвычайно интерес-
ным является вопрос поиска новых возможных молекулярно-генетических
систем регуляции. Можно надеяться, что изучение значимых слов и сос-
тавление словарей окажется полезным для этой области исследований.

Конечно, изложенные в данной главе методы и результаты - это
самые первые шаги в изучении статистических закономерностей
в генетических текстах. Перспективы развития такого направления
весьма обширны. Это связано и со стремительным увеличением числа
изучаемых объектов, и с привлечением и созданием новых методов ана-
лиза. Главная задача исследователя здесь, по-видимому, состоит в
том, чтобы, критически переосмыслив имеющийся опыт, определить сово-
купность надежно установленных фактов, усовершенствовать критерии
корректности постановок задач и интерпретации результатов.
Глава 3. РАСПОЗНАВАНИЕ КОДИРУЮЩИХ ОБЛАСТЕЙ
В НУКЛЕОТИДНЫХ ПОСЛЕДОВАТЕЛЬНОСТЯХ

3.1.	ВВЕДЕНИЕ

Транслируемые области прокариотического и эукариотического типа.

Понятие транслируемой (белок-кодирующей) области ДНК возникло в
результате уточнения и углубления представлений о единице наследствен-
ной информации - гене. Сегодня считается, что понятия гена и трансли-
руемой области тождественны, если речь идет о прокариотах (Льюин,
1987). В случае эукариот (и архебактерий) часть генов имеет прерывис-
тую структуру и включает в себя как транслируемые, так и нетранслиру-
емые области. Мы не будем пояснять детали механизма белкового синтеза
в про- и эукариотах. Заметим лишь следующее.

В прокариотах нуклеотидная последовательность транслируемой об-
ласти начинается с инициирующего кодона (АТС, реже СТС и очень редко
других триплетов) и заканчивается одним из терминирующих кодонов: ТСА,
ТАА или ТАС. Инициирующему кодону предшествует так называемый инициир-
ующий сигнал, обеспечивающий правильное прикрепление матричной РНК к
рибосоме. Эта сигнальная последовательность длиной 6-8 нуклеотидов
состоит преимущественно из А и С и узнается частично комплементарной
ей последовательностью 165-рРНК 305 субъединицы. Инициирующий и терми-
нирующий кодоны лежат в одной "рамке считывания", т.е. число нуклеоти-
дов в разделяющем их фрагменте кратно трем. Каждый из последовательно
считываемых за инициирующим кодоном триплетов нуклеотидов (вплоть до
терминирующего) определяет, согласно таблице генетического кода, оче-
редной аминокислотный остаток синтезируемой полипептидной цепи.

В эукариотах (и архебактериях) большая часть областей ДНК, коди-
рующих одну полипептидную цепь, имеет прерывистую структуру. За первым
кодирующим фрагментом, который всегда начинается с АТС, следует неко-
дирующий участок - интрон. Далее кодирующие и некодирующие участки че-
редуются и последний кодирующий фрагмент заканчивается терминирующим
кодоном. При этом выполняются следующие условия: 1) на границе кодиру-
ющего и некодирующего участка имеется каноническая, хотя и довольно
короткая последовательность, а именно - интрон начинается с динуклео-
тида СТ и заканчивается динуклеотидом АС; 2) если вырезать кодирующие
фрагменты и состыковать их, то полученный нуклеотидный текст будет
иметь вид непрерывной кодирующей области (подобно описанной выше в
случае прокариот).

Транслируемые области наиболее плотно размещены в вирусах и фа-
гах. Например, в 60 генах фага лямбда достаточно часто наблюдается
сопряжение терминирующего кодона предыдущего гена с инициирующим кодо-
ном последующего гена -ТСАТС-. В геноме фага ФХ174 были впервые обна-
ружены перекрывающиеся кодирующие области. Здесь в разных рамках счи-
тывания •одного и того же нуклеотидного текста содержится информация о
двух различных полипептидах, которые были идентифицированы 1п у!уо.
Хотя подобные случаи наблюдались в митохондриях и у млекопитающих, в
целом процент кодирующих областей в составе генома при. переходе от
низших форм к высшим резко уменьшается.

Постановка и подходы к решению задачи.' Поскольку методы секве-
нирования позволяют получать большое число нуклеотидных последователь-
ностей природных ДНК за короткое время, возникает проблема быстрого
выяснения функций расшифрованных первичных структур. Обычный экспери-
ментальный путь включает в себя картирование информационной РНК, про-
моторов, сайтов сплайсинга и других регуляторных участков. В итоге
возникает полная и точная картина структурно-функциональной организа-
ции данного участка ДНК. Компьютерные методы не столь, точны, но быст-
рее приводят к результатам.

Когда говорят о задаче компьютерного распознавания или идентифи-
кации кодирующих областей на известной последовательности ДНК, имеют в
виду следующее. По исходной нуклеотидной последовательности необходимо
определить, содержит ли этот фрагмент ДНК (по прямой или комплементар-
ной нити) белок-кодирующие участки, и указать их точные границы. Кроме
того, необходимо дать оценку надежности предсказания. Методы, алгорит-
мы и программы, предложенные для решения этой задачи, пока еще не дос-
тигли исчерпывающего уровня надежности, и полученные с их помощью ва-
рианты предсказания разметки нуклеотидного текста на кодирующие и не-
кодирующие области требуют дополнительного анализа (ЗФогшо,1987).

Известные методы идентификации можно условно разделить на
два класса: распознавание "по сигналу" и распознавание " по содержа-
нию" (ЗФабеп, 1985). В методах распознавания по сигналу используются
специфические закономерности в растановке нуклеотидов, окружающих ини-
циирующий кодон, и экзон-интронные границы. Эти методы описаны в гл.4
в числе других методов распознавания сравнительно коротких сигналов,
или сайтов. Методы распознавания по содержанию, которым посвящена нас-
тоящая глава, основаны на том, что внутри кодирующих областей на всем
их протяжении наблюдаются особенности в порядке чередования нуклеоти-
дов, обусловленные целым рядом функциональных ограничений.

Одно из . очевидных ограничений заключается в том, что нуклеотидный
текст кодирующей области должен допускать представление в виде после-
довательности триплетов (кодонов), не содержащих терминирующих троек
ТАА, ТАС, ТСА. В этой последовательности частоты встречаемости синони-
мических кодонов должны соответствовать аминокислотному составу
белковой молекулы.
Посмотрим, как это ограничение влияет на распределение нуклеоти-
дов в кодирующей области. Данные о среднем аминокислотном составе бел-
ков из 314 семейств ( ВауНоГГ,1972) свидетельствуют о том, что частоты
встречаемости аминокислот достаточно сильно варьируют, например алани-
на в среднем содержится в 6,6 раза больше, чем триптофана. Можно сфор-
мировать модельную кодирующую нуклеотидную последовательность таким
образом, чтобы выполнялись ограничения на средний аминокислотный сос-
тав. При этом синонимические кодоны будем использовать с равной веро-
ятностью (внутри своей группы). В табл.3.1 указано, какое количество
(из 1000 остатков) приходится на долю каждой из 20 аминокислот во всех
трех возможных рамках считывания. Заметим, что значения для первой
рамки соответствуют цифрам Дайхоф. В табл.3.2 также для трех возможных
рамок представлены частоты кодонов. Наконец, в табл.3.3 приводятся
частоты встречаемости нуклеотидов в трех позициях кодонов, вычисленные
для модельной последовательности.

Таблица 3.1

Встречаемость аминокислотных остатков

Номер рамки	А	С	0	Е	Е	С	Н	I	К	Ь
1	86	29	55	60	36	84	20	45	66	74
2	54	21	13	23	22	48	22	47	51	96
3	47	37	30	37	26	37	30	33	34	62
	М	Д	р	Ч	к	5	Т	V	V	У
1	17	43	52	39	49	70	61	66	13	34
2	26	30	59	37	110	89	73	54	20	20
3	9	28	48	37	133	83	44	44	21	30

Во всех случаях (табл.З.1-3.3) можно увидеть значительные разли-
чия между частотами, относящимися к разным рамкам. Таким образом, яс-
но, что триплетность и конкретный вид генетического кода, а также дис-
пропорции в аминокислотном составе приводят к вполне ощутимым особен-
ностям в статистических характеристиках белок-кодирующих нуклеотидных
последовательностей. Эти особенности в природных ДНК существенно уси-
ливаются вследствие известного явления "селекции кодонов", которое
заключается в том, что синонимические кодоны используются в геноме в
неодинаковых пропорциях, специфических для каждого организма (СгапФНаш
еФ а1., 1980а).

В случае прокариот поставленную задачу в значительной степени уп-
рощает поиск достаточно длинных "открытых рамок считывания" (ОРС),
т.е. последовательностей триплетов, которые начинаются инициирующим
кодоном и заканчиваются сигналом терминации. Действительно, например,
вероятность возникновения ОРС длиной 100 нуклеотидов в случайной пос
ледовательности с равновероятным включением четырех нуклеотидов - ме-
нее 1%. Однако известны кодирующие области существенно меньшей длины.
И наоборот, не любая длинная открытая рамка является кодирующей. До-
вольно часто встречаются и ситуации, когда кодирующая область является
частью открытой рамки, т.е. первый кодон АТС (СТС) не является иниции-
рующим.

Поэтому остановимся на утверждении, что наличие ОРС является
необходимым, но недостаточным условием для идентификации кодиру-
ющей области в прокариотах. Для повышения надежности предсказания

Таблица 3.2
Встречаемость кодонов в трех рамках

Кодон	Номер рамки			Кодон	Номер рамки			Кодон	Номер рамки			Кодон	Номер рамки
	1	1 2	3		1	1 2	3		1 1 2 |		3		1	1 2 | 3
ттт	18	И	15	ТСТ	12	И	13	ТАТ	1 7	10	16	ТСТ	15	И	17
ттс,	18	12	12	ТСС	12	12	13	ТАС	17	11	16	ТСС	15	11	22
ТТА	12	17	9	ТСА	12	17	15	ТАА	0	15	28	ТСА	0	16
ТТС	12	22	И	ТСС	12	22	8	ТАС	0	20	10	ТСС	13	20	21
СТТ	12	И	15	ССТ	13	И	13	САТ	10	11	16	ССТ	8	И	17
СТС	12	12	12	ССС	13	12	13	САС	10	12	16	ССС	8	12	22
СТА	12	17	9	ССА	13	17	15	САА	20	17	28	ССА	8	12	22
СТС	12	22	И	ССС»	13	22	8	САС	20	22	10	ССС	8	22	21
АТТ	15	14	14	АСТ	15	14	12	АТТ	22	15	15	АСТ	12	15	16
АТС	15	15	И	АСС	15	15	12	АСС	22	16	15	АСС	12	16	20
АТА	15	21	8	АСА	15	21	14	ААА	33	22	26	АСА	8	22	27
АТС	17	27	10	АСС	15	27	8	ААС	33	29	9	АСС	8	29	20
СТТ	17	10	15	ССТ	22	10	12	САТ	28	7	16	ССТ	21	9	17
СТС	17	И	12	ССС	22	1 1 Л 1	13	САС	28	7	15	ССС	21	10	22
СТА	17	15	9	ССА	22	15	15	САА	30	10	28	ССА	21	14	29
СТС	17	19	И	ССС	22	19	8	САС	30	13	10	ССС	21	18	21

нужно привлечь результаты поисков сигнальных последовательностей на
предполагаемых 5' границах или данные о статистических закономерностях
внутри ОРС, т.е. по существу надо использовать метод поиска по сигна-
лу или метод поиска по содержанию, или их комбинацию, ориентируясь на
ОРС как на нулевое приближение для разметки последовательности ДНК. В
случае эукариот роль ОРС еще меньше. Здесь методы поиска по сигналу и
по содержанию применяются в комбинации - отыскиваются возможные эк-
зон-интронные границы и проводится статистический анализ возможных
транслируемых экзонов.

Далее, в разделе 3.2 мы остановимся на методах универсального
типа, пригодных для поиска кодирующих областей любых организмов. Они
основаны на том предположении, что некоторые общие черты первичной
структуры кодирующих областей можно описать простой моделью. Эти мето-
84
ды хронологически появились раньше других (511и1тап еФ а1., 1981;
дЬер^егй, 1981) и продолжают развиваться (ПсЬапФ, СаиФ1ег, 1987). Зна-
чительное достоинство этих подходов в том, что их использование не
требует предварительного изучения так называемой обучающей выборки из
последовательностей ДНК рассматриваемой таксономической группы.

В разделе 3.3 будут рассмотрены методы, связанные с особенностя-
ми триплетной структуры кодирующих областей в разных организмах и
использованием феноменологических моделей.

Таблица 3.3
Встречаемость нуклеотидов в трех рамках

Номер рамки	1 т	1 с	1 А |	С
1	18,35	19,32	27,19	35.14
2	23,82	24,59	31,73	19,85
3	25,48	25,48	23,77	25,27
Ср.значение	22,55	23,13	27,56	26,75

Наконец, в разделе 3.4 говорится о методах распознавания, в кото-
рых используются модели кодирующих и некодирующих участков в виде
марковских цепей специального вида.

3.2.	РАСПОЗНАВАНИЕ КОДИРУЮЩИХ ОБЛАСТЕЙ НА ОСНОВЕ УНИВЕРСАЛЬНЫХ
МОДЕЛЕЙ

Использование статистик моно-,ди- и тринуклеотидов. В первых
работах по распознаванию кодирующих областей (51ш1тап еФ а1.,1981;
ЗйерНегб,1981) преследовалась ограниченная цель - предложить компь-
ютерную процедуру для определения рамки считывания генетического кода
в известной кодирующей области. Вопрос этот скорее теоретический, так
как практически определение рамки считывания может вызывать некоторые
затруднения только в случае эукариотического генома. Но интересно, что
уже здесь в значительной степени был очерчен круг понятий и подходов,
которые получили развитие в дальнейших исследованиях.

В упомянутой выше работе Шульмана было предложено три способа оп-
ределения истинной кодирующей рамки. В первом из них использовалось
предположение, что наблюдаемые в этой рамке частоты кодонов наиболее
уклоняются от равновероятного распределения по сравнению с двумя дру-
гими рамками. В качестве меры уклонения использовалась величина

64

В = Е ( Г. -ш. )2/т,.

1=1 ‘ 1

Здесь 1. и т1 - наблюдаемая и ожидаемая частота 1-го кодона
соответственно. Второй способ был связан с предположением, что распре-
деления частот динуклеотидов в различных рамках различаются своими
свойствами. А именно считалось, что распределение динуклеотидов, рас-
положенных в третьей рамке, т.е. объединяющих нуклеотид в третьей по-
зиции предыдущего кодона и нуклеотид в первой позиции последующего ко-
дона, более близко к равновероятному, чем распределение нуклеотидов
двух других рамках. Наконец, третий способ предусматривал определение
частот встречаемости гуанина в трех позициях кодона, имея в виду, что
в первой рамке он должен встречаться чаще, чем в двух других (см.
табл. 3.3).

Из вышесказанного ясно, что каждый из этих способов опирался на
простые представления о структуре кодирующих последовательностей, вы-
текающие из свойств таблицы генетического кода, и не требовал специ-
ального предварительного статистического анализа известных кодирующих
областей.

ЕЛУ-закономерности. В работе Шефферда (ЗНерНегб, 1981) для оп-
ределения рамки считывания в кодирующей области были впервые использо-
ваны результаты анализа статистических характеристик белок-кодирующих

Рис. 3.1. Частоты встречаемости
структуре ДНК

а - для ФХ174; б - для кластера
для гистоновых генов морского ежа

комбинаций УЕ(Д)кУУ в первичной
генов рибосомных белков Е.соИ; в -

последовательностей ДНК. Материалом для предварительного анализа пос-
лужили расшифрованные в 1978г. геномы вирусов ФХ174, С4, Гб, 5У4С,
М82, ДНК плазмиды рВЕ322, гены рибосомальных белков Е.соИ и гистоно-
вые гены морского ежа. На постановку задачи существенно повлиял кон-
такт автора с М.Эйгеном, который активно разрабатывал проблему возник-
новения генетического кода (Е1йеп,1978). Поэтому цель работы была тес-
но связана с проверкой гипотезы Эйгена о происхождении современного
генетического кода от архаического кодового правила, в соответствии с
которым первичная структура кодирующего участка ДНК должна была состо-
ять из периодически повторяющихся триплетов ЕЫУ ЕДУ ЕМУ...ЕЫУ...
(Е-пурин,У-пиримидин).
Использовалась весьма простая техника статистического анализа.
Последовательность ДНК записывалась в алфавите В,?. Затем определялись
численности "разнесенных" на к позиций динуклеотидов УК- -УУ. Напри-
мер, если величина промежутка составляла К нуклеотидов, то такой тет-
рануклеотид записывается как УК(ЮкУУ. Из результатов, представленных
на рис.3.1, видно, что встречаемость пар УУ увеличивается периодически
через 0,3,6 и т.д. оснований после пары УК. Выраженность этой законо-
мерности убывает в ряду: вирусы, прокариоты, эукариоты.

Рис. 3.2. Предсказание кодирующих рамок в первичных структурах ДНК
для разных организмов

а - вирусы; б - прокариоты; в - эукариоты

Основанный на этом наблюдении метод предсказания заключается в
следующем. Берется фрагмент последовательности ДНК определенной длины
(например, 62 нуклеотида) и записывается в коде - К,У. Затем фрагмент
анализируется в трех возможных рамках считывания: в первой рамке - от
позиции 1 до позиции 60, во второй рамке - от 2 до 61, в третьей рамке
- от 3 до 62. В каждом случае подсчитывается число замен (мутаций) К в
I и У и К, необходимых для того, чтобы представить К,У-текст в виде
серии триплетов КЫУ. Записывается номер рамки, которому соответст-
вует минимальное число замен. Для анализа длинной последовательности
ее разбивают на непересекающиеся фрагменты и поочередно анализируют
их, отмечая номер рамки как функцию на графике в центре каждого фраг-
мента (рис. 3.2).

Ясно, что метод симметричен относительно инвертирования последо-
вательности. Таким образом, если отсутсвует априорная информация, тс
остается неопределенность, по какой из нитей ДНК считывается генети-
ческая информация в найденной рамке.

Работа Шефферда интересна в нескольких отношениях. Во-первых,
она, как и работа Шульмана, использует достаточно простую модель коди-
рующей области, но выбору модели предшествует статистический анализ
известных кодирующих областей, совокупность которых можно было бы рас-
сматривать как обучающую выборку. Заметим, однако, что мы считаем не-
целесообразным использовать здесь понятие обучающей выборки, так как
полученная модель имеет универсальный характер и не зависит от таксо-
номической группы природной ДНК, взятой для исследования. Во-вторых,
весьма важной является попытка глубокого эволюционного и биологическо-
го обоснования модели.

Работа Шефферда, конечно, не была лишена недостатков. На наш взг-
ляд, более соответствовало бы постановке задачи исследование встречае-
мости тетрануклеотидов та(Н)кТВ и доказательство, что имеется перио-
дическое увеличение их численности при к=1,4,7 (ср. рис.3.1). Не было
строго показано, что отклонения частот встречаемости тетрануклеотидов
УВ(Д)кУУ от ожидаемых величин являются статистически значимыми. Кро-
ме того, контрольный пример, демонстрирующий визуализацию белок-коди-
рующих областей ряда ДНК (см. рис.3.2), сам по себе не дает информации
о надежности предсказания. Наконец, Стаден обнаружил (ЗФабеп, 1985),
что метод Шефферда хорошо работает на модельной кодирующей последова-
тельности, построенной только с ограничением на средний аминокислотный
состав белка (см.п.З.1). Это означает, что метод Шефферда слабо чувст-
вителен к отсутствию селекции кодонов и отбирает кодирующую рамку, в
которой проявляется типичный аминокислотный состав, кодируемый преиму-
щественно кодонами типа ЕНУ. Следовательно, вопрос о первоисточнике
эффективности метода Шефферда - будь то структура архаического или
современного генетического кода - остается открытым.

Метод Фиккетта. Следующим шагом в развитии методов распознавания
универсального типа явилась работа Фиккетта (Р1скеИ,1982), в которой
был предложен способ вычисления количественного критерия для ответа на
вопрос, являтся ли обнаруженная в нуклеотидном тексте ОРС истинной ко-
дирующей областью. Здесь впервые были исследованы как выборки кодирую-
щих, так и выборки некодирующих областей ДНК различных организмов.
Первая из них содержала 230 тыс. нуклеотидов, а вторая - 159 тыс. нук-
леотидов. Основная идея близка к методу линейного дискриминантного
анализа и заключается в поиске таких, достаточно простых, признаков
рассматриваемых объектов (последовательностей ДНК), разбитых на два
класса, по которым можно было бы построить линейную разделяющую функ-
цию, пригодную для любых таксономических групп. Было показано, что в
кодирующих областях присутствуют автокорреляционные закономерности в
распределении нуклеотидов. Например (см. рис.3.3), в кодирующих об-
ластях число нуклеотидов, разделяющих два тимина, с гораздо большей

Рис. 3.3. График автокорреляций встречаемости тимина

а - для 321 кодирующих; б - 249 некодирующих фрагментов длиной бо-
лее 200 нуклеотидов из БД "СепВапк"

вероятностью будет равно 2+Зи, п=1,2,....., чем Зп или 1+Зп. То же са-

мое выполняется и для других типов нуклеотидов.

Можно показать, что это наблюдение непосредственно указывает на
то, что в кодирующих областях частоты нуклеотидов в разных позициях
кодона неодинаковы. Пусть вероятности появления, например тимина, в
разных позициях кодона равны Р1,Р2,Р3. Тогда ожидаемая частота встре-
чаемости двух тиминов, разнесенных на (2+Зп) оснований, будет равна
Р,2+Р22+Р32. В случаях, когда расстояние между тиминами Зп и 1+Зп,
ожидаемые частоты встречаемости - Р1Р2+Р2Р3+Р3Р1 и Р1Р3+Р2Р1+Р3Р2
соответственно, причем эти две величины равны друг другу. Отражение
этого факта нетрудно заметить на рис.3.4, где периодические выбросы
разделены парами близких точек.

Далее можно показать, что Р12+Р22+Р32 > Р1Р2+Р2Р3+Р3Р1 и знак
равенства имеет место только при Р1=Р2=Р3. Таким образом, исследование
частот разнесенных динуклеотидов позволяет установить позиционные
частотные неравномерности, и рис. 3.3 свидетельствует о том, что в
кодирующих областях позиционные частоты нуклеотидов различны в трех
позициях кодона и что в некодирующих областях позиционные частотные
различия отсутствуют.

Поставив перед собой цель выбрать наиболее простые признаки, Фик-
кетт остановился на следующих восьми признаках - четырех позиционных
параметрах Т , Ср, Ар и Ср и четырех частотах мононуклеотидов
89
Тг, Сг, А, и Сг. Вычисление позиционных параметров, например Т ,
производится следующим образом.

Пусть ?! - число тиминов в позициях 1,4,7..............., Зп-2; Т2 -числе
тиминов в позициях 2,5,8,....,Зп-1; Т3 - число тиминов в позициях
3,6,9,....,3п рассматриваемой ОРС. Тогда

шах (Т,,Т,,Т3)

Т _ 1 2----------------“------- --
₽ пип (Т,,Т2,Т3) + 1

Достоинство такого определения позиционных параметров в том, что
все позиции кодона здесь равноправны и величина Тр характеризует
лишь факт различия позиционных частот. Кроме того, было показано, что
величины позиционных параметров оказались независящими от особенностей
правил селекции кодонов, свойственных различным организмам.

Частотные параметры Тг, Сг, Аг и Сг являются частотами встречае-
мости мононуклеотидов. Ясно, что, например, Т = 41+42+43. За крите-
рий при идентификации кодирующей области было принято значение функции

Е=0,334 +0.18С +0.26А +0.31Й +0,144 +0,12С +0, ПА+0,15С .
рт Р Р Р г * г г

На реальных нуклеотидных последовательностях функция Е принимает
значения от 0,32 до 1,37.Правило принятия решения в зависимости от ве-
личины функции Е задается в табл. 3.4.

Для проверки предложенного метода было проведено следующее испы-
тание. Каждая из обучающих выборок (кодирующая и некодирующая) была
разбита случайным образом на две равных выборки и образованы две пары.
Одну из них использовали как обучающую для определения функции Е, дру-
гую - для контроля. В результате 6% кодирующих фрагментов были ошибоч-
но отнесены к некодирующим, 3% некодирующих - к кодирующим и в 18%
случаев определенного ответа не было дано. Необходимо заметить, что
все зти операции выполнялись с последовательностями длиной не менее
200 нуклеотидов. Для ОРС меньшей длины, например от 100 до 200, коли-
чество ошибок возрастало до 13%, а число случаев без определенного от-
вета до 29%.

В 1982г. появилась первая из цикла работ Стадена, посвященных
распознаванию кодирующих областей (5Фас1еп, МсЬасЫап, 1982). Стаден
разработал несколько методов, два из которых можно отнести к числу
универсальных: 1) метод, в котором используется статистика частот ко-
донов для модельной последовательности с усредненным аминокислотным
составом (см. табл.3.2); 2) метод, который идентифицирует присут-
ствие характерных различий в позиционных частотах нуклеотидов (см.
ЗЪабеп, 1985).

Следует сказать, что несовпадение позиционных частот мононуклео-
тидов в разных рамках анализируемой последовательности служит призна-
ком кодирующей области и в двух других методах универсального типа
(В1ЬЬ е1 а1.,1984; А1та§ог,1985).
Таблица 3.4

Правила предсказания кодирующих свойств по функции Фиккетта

	Значение	|	Вероятность кодирования	Предсказания
От	0,32 до 0,43	0,00	Не кодирует
	0,43 " 0,53	0,04	11
и	0,53 " 0,64	0,07	И
п	0,64 " 0,74	0,29	11
н	0,74 " 0,84	0,40	Не ясно
II	0,84 " 0,95	0,77
II	0,95 " 1,05	0,92	Кодирует
II	1,05 " 1,16	0,98
II	1,16 " 1,26	1,00	• 1
II	1,26 " 1,37	1,00	И

Использование информационных свойств кодонов. Оригинальный под-
ход к рассматриваемой задаче (ТгатопЪапо, МассЫаФо,1986) связан с ин-
формационными характеристиками кодонов. Эти величины определяется по
формуле

3 Пл

Г =>1 ( Р1’^‘)/П^

где п, - число "осмысленных" мутаций для основания находящегося
в 3-й позиции данного кодона (т.е без учета мутаций приводящих к тер-
минирующим кодонам); Р; - относительная частота мутаций, вычислен-
ная исходя из анализа гомологичных генов родственных организмов;

- величина, отражающая различие в гидрофобностях аминокислоты, которую
кодирует данный кодон, и аминокислоты, в которую транслируется мутиро-
вавший кодон. Значения Г были определены для всех смысловых кодонов
(см.табл.3.5). При анализе нуклеотидной последовательности для состав-
ляющих ее кодонов вычислялась средняя величина <Г>. Исследование выбо-
рок кодирующих и некодирующих областей позволило найти распределения
значений <1> на объектах каждого класса и аппроксимировать зти эмпири-
ческие распределения кривыми гауссовского типа с параметрами
(1^=2,25, 51=0,15) и (ш2=2, 5, з2=0,25) соответственно.

Теперь при исследовании нового объекта - открытой рамки с неиз-
вестными свойствами - вероятность ее принадлежности к числу коди-
кодирующих областей определяется по формуле

______________(1/з,)»ехр[-(< Г >-гп1) 2/з,2 ~1________
(1/з,) *ехр[-( < Ь-т, )2/з,2] + ( 1/з2)’ехр[-( < Ь-т2)2/з22]

Область возможных значений р рекомендуется разбить на три диапа-
зона. Первый - 0 < Р < Рп = т,-з,/3 - соответствует предсказанию о
том, что последовательность обладает кодирующими свойствами, второй -
Рп < Р < Рк = ш2-52/3 - оставляет вопрос открытым и третий - Р > Рк
- дает предсказание, что последовательность не является кодирующей.
Исследование надежности предсказаний на контрольной выборке показало,
что в 13% случаев кодирующие последовательности были приняты за
некодирующие и в 21% случаев - наоборот, некодирующие последодователь-
носТи были приняты за кодирующие, причем по 15% тех и других

Таблица 3.5

Информационные значения для смысловых кодонов

2-й нуклеотид

1-й нуклео- тид	А	С	С	Т	3-й нуклео-  тид
А	2,9	1,3	1,5	3,9	А
	3,4	1,2	1,0	4,3	С
	2,3	1,3	1,7	3,0	С
	2,8	1,2	1,1	4,4	Т
С	3,5	4,2	1,4	1,9	А
	3,4	3,5	1,6	1,5	С
	2,0	4,2	1,6	2,2	С
	3,0	3,5	1,6	1,5	т
0	1,4	1,0	1,4	2,4	А
	1,2	1,0	0,8	2,4	С
	1,4	1,0	1,5	1,8	С
	1,2	1,0	0,8	2,4	т
Т		3,0	—	2,9	А
	4,1	3,2	4,1	2,5	С
	—	4,1	5,6	1,7	С
	4,1	3,2	3,5	2,5	т

функциональных зон были неопознаны. Эти цифры явно уступают аналогичн-
ым показателям для метода Фиккетта. По-видимому, существует лишь огра-
ниченное число ситуаций, когда можно предвидеть искажение статистичес
кой структуры кодирующей области (перекрывание нескольких открытых ра-
мок на одной нити или на комплементарных нитях) и использовать преиму-
щества метода Трамонтано - Мачиато, связанного в большей степени не с
анализом статистических характеристик собственно нуклеотидной последо-
вательности, а со свойствами гипотетического белка.

3.3,РАСПОЗНАВАНИЕ КОДИРУЮЩИХ ОБЛАСТЕЙ ПО ОСОБЕННОСТЯМ
ТРИПЛЕТНОЙ СТРУКТУРЫ. ОБУЧАЮЩИЕ ВЫБОРКИ

Использование статистики синонимических кодонов. Олигонуклеотид-
ные статистики кодирующих областей, т.е. частоты встречаемости
1-грамм, специфичны для таксономических групп и даже для отдельных
92
организмов внутри групп (Мизз1поу,1980; 1кешига,1981,1982). Поэтому
возможности универсальных методов распознавания по содержанию оказыва-
ются неодинаковыми для первичных структур ДНК разных организмов и, бо-
лее того, заранее непредсказуемыми. Естественно, возникает вопрос о
том, нельзя ли "настроить" механизм распознавания так, чтобы были уч-
тены статистические особенности данного генома (или группы геномов).
Эту цель можно достичь, например, путем использования так называемой
феноменологической модели кодирующей области, параметры которой опре-
деляются из результатов анализа известных кодирующих областей данного
генома.

В ряде работ (ЗЬабеп, МсЬасЫап, 1982; Сг1Ьзкоу еЬ а1.,1984;
Н1пбз, В1аке,1985) в качестве параметров модели берутся частоты встре-
чаемости кодонов. Метод Стадена и Маклачлан, названный впоследствии
"методом селекции кодонов", состоит в следующем.

Предположим, что мы рассматриваем фрагмент первичной структуры
ДНК некоторого организма (обозначаемый далее через 2), состоящий из
3(п+1) нуклеотидов. Текст фрагмента 2 может быть записан как цепочка
триплетов

а.в.с.а^с, ........ап+1вп + 1сп4!. (3.1)

Представим себе, что нам известны частоты встречаемости кодонов,
характерные для кодирующих областей этого организма - Г(аЬс),
а,Ь,с=Т,С,А,С. Кроме того, будем считать, что в полном геноме выделены
три условные сквозные рамки считывания триплетов и что доля кодирующих
областей, располагающихся в первой рамке - <3,, во второй - и в
третьей - С3.

Попробуем определить величину вероятности, с которой нам встре-
тится последовательность (3.1), если извлекать случайным образом фраг-
менты длины п+1 из длинной кодирующей нуклеотидной последовательности.
Величина этой вероятности будет принимать три разных значения в зави-
симости от расположения рамки считывания, т.е. первую позицию кодона
занимает либо нуклеотид а,, либо нуклеотид Ь,, либо нуклеотид
с,. Вероятности каждого из этих случаев определяются следующими вы-
ражениями:

рамка 1	рг	(Э/Ка.Ь.с,)*......-Г(апЬпсп),

рамка 2	р2=	р2Т(Ь1с,а2)’......’Г(Ьпспап<.,),	(3.2)

рамка 3	р3=	<Э3-Г(с,а2Ь2)'....'Пспап + 1Ьп + 1).

Напомним, что нас интересует противоположная по смыслу величина
Р - вероятность того, что фрагмент 2 является кодирующим. Случаи, ког-
да нуклеотид а! занимает первое, второе или третье положение в кодо-
не, могут вносить существенно различный вклад в величину Р. Поэтому
Рис. 3.4. Применение "метода селекции кодонов" к а!р(ипс)-оперону Е.
соИ

Отмечены гены: а - аФр1; б - а!рВ; в - а!рЕ; г - а!рЕ; д - аФрН;
е - а!рА; ж -а!рС; з - аЪрТ); и - аФрС; 1,2,3 - номера рамок

рассмотрим эти случаи по отдельности и определим их вероятности исходя
из известных значений р1? р2, р3, используя формулу Байеса:

Р, = р,/(р,+р2+р3),

Р2 = Р2/( Р1+Р2+Рэ) ’	(3.3)

Р3 = РзА Р 1 +Р2+Рз) •

Теперь, как уже ясно, Р = Р1+Р2+Р3. Заметим, что при прак-
тической реализации алгоритма удобно использовать логарифмы частот.
Полученные значения Р),Р2,Р3 ставятся в соответствие центральной
позиции окна. Таким образом, при сканировании последовательности воз-
никают три функции, которые могут быть изображены графически
(рис. 3.4).

Следует заметить, что полученные значения вероятности являются в
определенном смысле условными, так как в данном методе байесовский
формализм проведен недостаточно строго, например не рассматривается
возможность попадания фрагмента 2 в некодирующие области. Кроме того,
сама феноменологическая модель кодирующей области как последователь-
ности из независимо чередующихся кодонов не является полностью соот-
ветствующей реальности.

Поэтому полученные величины вероятности кодирования Р. в трех
рамках не являются вполне адекватными. Этот факт отражается в наблюда-
емых на рис.3.4 выбросах за 50%-ный уровень в некодирующих участках и
провалах в кодирующих областях, количество которых превышает ожидае-
мое.

Тем не менее практическое значение метода было несомненно боль-
щим. Достаточно сказать о работе Сэнгера и соавт. (Запрет еФ а!.,
1982), которые при анализе расшифрованного ими генома фага лямбда ак-
тивно использовали метод селекции кодонов для картирования кодирующих
участков и оценки вероятности того, что наблюдаемые ОРС являются ре-
альными кодирующими областями.

К методу Стадена - Маклачлан близок метод Грибскова и соавт.
(СгхЬзкоч еФ а1.,1984). Основное отличие состоит в том, что для опре-
деления вероятности принадлежности рассматриваемого фрагмента ДНК к
кодирующей области берутся частоты использования синонимических кодо-
нов (нормированные на единицу в каждой группе), определенные заранее
для данного генома.

Этот выбор в какой-то степени уменьшает чувствительность метода
по сравнению с методом Стадена - Маклачлан, так как учитывается только
одна из двух составляющих абсолютной частоты встречаемости кодонов, а
вторая составляющая - частота встречаемости аминокислот - оказывается
отброшенной. С другой стороны, возникают два преимущества. Во-первых,
увеличиваются* возможности распознавания генов, кодирующих белки с
произвольным аминокислотным составом. Во-вторых, получаемый результат
несет одновременно некоторую информацию об использовании наиболее или
наименее распространенных в данном геноме синонимических кодонов, что
позволяет предполагать определенный уровень экспрессии гена (см.гл.2).

Методы, связанные со статистикой нуклеотидов в третьей позиции
кодона. В нуклеотидных последовательностях кодирующих областей особая
роль принадлежит нуклеотидам, занимающим третью позицию кодона. Они
испытывают наименьшее селективное давление со стороны эволюционного
отбора на уровне белковых структур. В то же время они сильно коррели-
рованы с первыми двумя нуклеотидами кодона (селекция кодонов), что
связано с давлением отбора на уровне трансляции (см.гл.2). Обнаружена
также корреляция третьего нуклеотида кодона с нуклеотидами 3'-сосед-
него кодона.

Как уже говорилось, в качестве методов распознавания универсаль-
ного типа были предложены подходы, предусматривающие вычисление функ-
ций-индикаторов кодирующих областей исходя из частот встречаемости мо-
нонуклеотидов в трех рамках, рассчитанных внутри окна наблюдения V
(ЗЬи1тап еФ а1.,1981; ЗФабеп, 1984а; В1ЬЬ еФ а!., 1984; АГта^ог,1985).
Два из этих методов (В1ЬЬ и А1таеог) предусматривают выявление кодиру-
ющей области и рамки считывания по различиям в позиционных частотах
мононуклеотидов. В частности, Алмагор предполагал, что частоты нуклео-
тидов в третьей позиции более чем в двух других уклоняются от равнове-
роятного распределения. Бибб с соавт. показал, что ОС содержание (час-
тоты 0 и С нуклеотидов) в третьей позиции кодона сильнее, чем в двух
Других позициях, скоррелировано с СС содержанием кодирующей области в
Целом. Работоспособность этих методов была подтверждена примерами (для
генов Е.соИ, митохондрий дрожжей).
Более детально закономерности в распределении частот нуклеотидов
в третьем положении кодона были исследованы позднее на выборках генов
Е.соИ (Бородовский и др., 1988). Здесь было показано, что частоты нук-
леотидов в этой позиции статистически значимо изменяются в зависимости
от типа нуклеотида, расположенного с 3' стороны от кодона. Кроме того,
характер изменений неодинаков в сильно и слабо экспрессируемых генах.
Данные о контекстно зависимых частотах нуклеотидов в третьем положении
кодона, полученные на обучающей выборке, могут быть использованы для
локализации кодирующих областей.

Идеология метода так же, как и в п.З.3, связана с байесовским под-
ходом. Задача состоит в том, чтобы определить вероятности принадлеж-
ности фрагмента заданного вида - (а,,а2, ... а3п43), а,= Т, С, А, С -
кодирующей или некодирующей областям.

Допустим, что нам известны частоты нуклеотидов в третьем положе-
нии кодонов 1к(а), а=Т,С,А,С - и частоты нуклеотидов в некодирующей
области - Гп(а), а=Т,С,А,С (которые не зависят от позиции). Тогда,
если рассматриваемый фрагмент 2 является кодирующим, то вероятность
того, что он считывается в 1-й, 2-й или в 3-й рамке, равна

Р< =гЛаз)‘гк(а6)-...-Гк(а3п),

р2 -Гк(а4)-Гк(а7)-...-Гк(а3п„),	(3.4)

Рз =тк(а5)'^(а8)-...-Гк(а3п,2).

С другой стороны, вероятность встретить фрагмент 2 в некодирующей
области равна

Р„ =^(а5)Чп(а8)-...Чп(а3п,2).	(3.5)

Теперь нетрудно определить искомую вероятность того, что фрагмент
2 принадлежит кодирующей области и что при этом первый нуклеотид фраг-
мента находится в определенной (1-Й, 1=1,2,3) позиции кодона

Р, = Р/^РЛ^Рг+ОэРэ +$пРЛ <3-6)

Здесь 5п - доля некодирующих областей в рассматриваемом геноме.
При отсутствии априорной информации обычно полагается (^=1/2,
<гп-1/б.

Только что изложенный подход обобщается на те случаи, когда в ка-
честве позиционных частот Гк(а) - частот нуклеотидов в третьем поло-
жении кодона - используются так называемые контекстные (условные) час-
тоты. Поясним это понятие. Контекстной частотой третьего нуклеотида
при задании одного нуклеотида с 3' стороны Г(с|Ь) является частота
встречаемости нуклеотида с при условии, что вторым нуклеотидом кодона
является Ь. Контекстная частота Г(с|аЬ) определяется при условии, что
96
нуклеотиды а и Ь занимают первую и вторую позиции кодона соответствен-
но. Наконец, Г(с|аЬ*й) есть частота встречаемости с при условии, что
первые две позиции кодона занимают нуклеотиды а и Ь, ив первой пози-
ции Б'-соседнего кодона находится нуклеотид типа й (звездочка соответ-
ствует позиции, . в которой находится нуклеотид с). Все введенные кон-
текстные частоты могут быть определены исходя из позиционных частот
моно-, ди-, три- и тетрануклеотидов (Ы(а), Ы(аЬ), Ы(аЬс), Ы(аЬсй)) на
обучающей выборке кодирующих областей, а именно:

Гк1(с) = Г(с|Ь) = Ы(Ьс)/Ы(с),

Гк2(с) = Г(с|аЬ) = Ы(аЬс)/Н(аЬ),	(3.7)

Гк3(с) = Г(с|аЬ*б) = Ы(аЬс(1)/Е Ы(аЬп<1).
п

Определенные здесь частоты 11к(а), 1=1,2,3 могут быть непосред-
ственно подставлены в формулу (3.4) вместо Гк(а), которые логично
переобозначить как Гк0(а). Значения р,, 1 = 1,2,3 для скользящего

200	МО	600	800

ЕС1.Е XX

Рис. 3.5. Графики функций-индикаторов кодирующих областей для шести
рамок считывания последовательности ЕСЬЕХХ

1,2,3,-1,-2,-3 - номера рамок, У=(4,15)

вдоль последовательности фрагмента являются функциями-индикаторами ко-
дирующих областей. Кроме того, инвертирование рассматриваемой последо-
вательности позволяет применить тот же алгоритм для обнаружения коди-
рующих областей на комплементарной нити ДНК. Таким образом, исследова-
ние нуклеотидной последовательности может происходить сразу в шести
возможных рамках считывания генетического кода.

На рис.3.5 представлены графики величин Р(К|2),1=1,2,3, получен-
ных для последовательности ЕСЬЕХХ (обозначение, принятое в базе данных
ЕМВЬ) в том случае, когда размер контекста равен 3, а ширина окна - 15
кодонам. Известно, что фрагмент (102,707) последовательности ЕСЬЕХХ
является умеренно экспрессируемым геном белка 1ехА.

Числа, стоящие по горизонтали, указывают количество нуклеотидов
от начала последовательности. Масштаб вертикальной оси соответствует
интервалу (0,1). Здесь и на последующих рисунках на уровне 0,5 сплош-
4 Заказ № 4327 О?
ными линиями отмечены цепочки триплетов, не содержащие терминирующих
кодонов. Они начинаются от длинных или коротких вертикальных штрихов,
которые означают триплеты АТО или СТС соответственно, и заканчиваются
смещенными вниз длинными штрихами, которые указывают положения терми-
нирующих триплетов.

Таблица 3.6

Значения эмпирической вероятности кодирования
для известных генов Е.соИ

Ген	Число кодонов	Значение индикатора	Название	Число кодонов	Значение индикатора
а1а 5	Высокоэкспрессируемые гены  874	0,867	гр1 К			141	0,922
асе Е	629	0,909	гр1 Ь	120	0,881
асе Р	474	0,928	про В	1341	0,915
аФр А	512	0,909	про С	1406	0,948
аФр Е	78	0,955	грз А	555	0,939
аФр Б	459	0,916	грз В	240	0,939
с1па К	637	0,924	грз С	79	0,922
еш з	550	0,921	грз С	132	0,832
$1у 5	302	0,928	грз С	80	0,912
Трр	377	0,914	грз 1	102	0,910
отр А	345	0,949	грз Ь	123	0,887
отр Р	361	0,907	грз Т	86	0,820
гее А	352	0,919	грз и	70	0,921
гр1 А	233	0,908	15 Г	282	0,942
гр1 Т	164	0,873
ага С	Низкоэкспрессируемые гены  291	0,697	Гас 2			1021	0,837
аго Р	355	0,827	1ех А	201	0,777
азп Б	366	0,813	та1 Р	513	0,847
азп А	329	0,866	те! В	468	0,612
баш	277	0,691	те! Ь	808	0,903
бео К	250	0,695	раЬ В	452	0,750
бпа С	579	0,589	рГк В	307	0,647
<3x1	332	0,831	риг Р	503	0,861
Го1	158	0,828	руг В	310	0,814
Гит А	547	0,825	гпГ1	154	0,739
еа1 Е	342	0,689	ЪЬг А	819	0,725
куг в	356	0,679	1гр 5	333	0,909
Тас I	359	0,768	1зг	535	0,823

Изложенный подход не дает пока ответа на два естественных вопро-
са: во-первых, следует ли стремиться использовать контекстные вероят-
ности максимально возможного порядка, или же за счет "эффекта насы-
щения" увеличение контекста выше определенного предела практически
теряет смысл; во-вторых, существует ли более компактная, чем график
функции, характеристика, которая позволила бы судить о том, является
ли данная открытая рамка белок-кодирующей или нет.

Сравнительное исследование распределений значений величин
Рк.(К|2), 1=0,1,2,3 для выборок кодирующих и некодирующих областей
показало следующее. Плотности бк.1(Р|К) и <1к1(Р|Н) этих распределе-
ний (в случае 1=П) в значительной степени перекрывались, что свиде-
тельствовало о нецелесообразности использования величин Рк0(К|2) в
качестве индикатора в алгоритме распознавания. В случае 1=1 указанные
плотности концентрировались вблизи 1 и 0 соответственно. При 1=2 зти
функции еще более стягивались к краям области определения. В случае
1=3 поведение функций плотности незначительно улучшалось (приближаясь
к идеалу - двум дельта-функциям в единице и в нуле) по сравнению со
случаем 1=2. Таким образом, в последовательности функций плотностей
наблюдался эффект насыщения и следовало предполагать, что алгоритмы
распознавания, использующие контекстные частоты с параметрами 1=2 и
1=3, будут давать практически одинаковые результаты (что и имело место
в действительности).

Таблица 3.7
Эмпирические вероятности кодирования
для неидентифицированных ОРС

Последовательность	От Д	I До Д |	Вероятность
ЕСАСЕЕ	186	893	0,690
ЕСАТРХ	177	566	0,493
ЕСЕНОВ	42	434	0,870
ЕСЕНОВ	448	804	0,929
ЕСЬАМВА	1682	2074	0,785
ЕСОМРА	172	666	0,636
ЕСРНОЕ	1572	1970	0,469
ЕСРН6К	1486	1938	0,368
ЕСННДВ2	275	1141	0,525

Для решения второго вопроса можно использовать функции плотности
<1к1(Р|К), 1>0. Определим эмпирическую вероятность кодирования для
фрагмента 2 следующим образом:

V (К|2)=	---------------------

Пк1(Р|К)+бк1 (Р|Н)	•

Для отдельно взятой ОРС длины Ь, разбитой на непересекающиеся
Фрагменты 2гз=1,....Д, можно определить величину

Д

У,(Ь) = Е1 V,(К|2}) .
Величина У,(Ь) характеризует вероятность наличия кодирующих
свойств у открытой рамки. Значения У3(Ь) для известных кодирующих
областей представлены в табл.3.6. При этом использовались фрагменту
2 длиной 45 нуклеотидов.

Видно, что во всех случаях значения вероятности кодирования пре-
восходят величину 0,5, которая принимается в качестве пороговой при
рассмотрении неидентифицированных ОРС.

Нуклеотидные последовательности ЕСАСЕЕ, ЕСАТРХ, ЕСЕНОВ, ЕСОМРА
ЕСРАР1, ЕСРНОЕ, ЕСРВ6К, ЕСВЕДВ2 (обозначения приводятся согласно опи
санию базы данных ЕМВЬ) имеют открытые рамки с неизвестной функцией.
Для этих ОРС были определены значения У3(Ь), которые приводятся в
табл. 3.7.

Величины, превосходящие 0,5, позволяют предсказывать белок-кодиру-
щие свойства для соответствующих ОРС. Диапазон 0,4-0,5 является поло-
сой неопределенности. Если же У3(Ь) < 0,4, то делается вывод, что
данная ОРС не обладает кодирующими свойствами.

3.4.ИСПОЛЬЗОВАНИЕ ПРЕДСТАВЛЕНИЙ КОДИРУЮЩИХ ОБЛАСТЕЙ
МАРКОВСКИМИ ЦЕПЯМИ

Модели двух классов объектов. В гл. 2 при обсуждении общей за-
дачи статистического моделирования нуклеотидных последовательностей
было отмечено, что генетический текст нестационарен и что не существу-
ет единой модели, одинаково хорошо описывающей первичную структуру ге-
нома на всем его протяжении. В связи с этим для описания кодирующих и
некодирующих областей ДНК были предложены марковские модели разного
типа. Представления, изложенные в гл.2, могут быть использованы в ме-
тоде распознавания кодирующих областей. На первом этапе производится
1-граммный анализ выборок известных кодирующих и некодирующих областей
(обучающих выборок). В результате этого анализа определяются переход-
ные вероятности неоднородной и однородной цепей Маркова, которые слу-
жат моделями кодирующих и некодирующих областей соответственно. Далее
задача заключается в том, чтобы разметить предъявленный генетический
текст на чередующиеся зоны, одни из которых статистически наиболее
близки к модели кодирующей области, а другие модели некодирующей об-
ласти.

Наиболее простой способ реализации этой процедуры связан, как и
п.З.3, с использованием движущегося окна и последовательного принятия
решений о принадлежности фрагментов первичной структуры ДНК (в просве-
те окна) к классу кодирующих или некодирующих. Недостатком такого спо-
соба, как и других методов распознавания по содержанию, являются зат-
руднения при анализе фрагментов, содержащих внутри себя граничную по-
зицию, т.е. частично принадлежащих к тому и другому классу одновремен-
100
но, что в итоге приводит к недостаточно точному определению положения
границ.

Марковский алгоритм распознавания. Вернемся к нашему основному
Объекту - фрагменту последовательности ДНК - 2, состоящему из п нукле-
отидов, т.е. 2 = а,,а2.......ап, а,=Т,С,А,(к Напомним, что выбрано
п, кратное трем. Речь по-прежнему будет идти о вероятностях Р(К|2)
и Р(Ы|2) того, что участок 2 принадлежит кодирующей и некодирующей об-
ласти соответственно. Нам удобно повторить уже рассматривавшиеся этапы
вывода байесовского алгоритма, которые при использовании марковских
моделей приобретают большую степень общности.

Как мы уже знаем, величину Р(К|2) можно представить как сумму
трех величин - Р(К,|2), Р(К2|2), Р(К3|2), которые есть вероятности
того, что фрагмент 2 принадлежит кодирующей области и в то же время
нуклеотид а1 занимает 1-ю позицию некоторого кодона. Вычисление
вероятностей Р(Ы|2) и Р(К1|2), 1=1,2,3 можно выполнить, зная параметры
математических моделей кодирующих и некодирующих областей.

Модель некодирующей области задается однородной марковской цепью
первого порядка. Вектор начального распределения вероятностей (соглас-
но табл.2.2,гл.2) имеет четыре компоненты: Р(Т)=0,231, Р(С)=0,259,
Р(А)=О,261, Р(С)=0,248. Матрица переходных вероятностей для этой це-
пи приведена в табл.2.3 гл.2. В качестве модели кодирующей области
могут быть использованы неоднородные марковские цепи трех разных по-
рядков - г=0,1,2. Чем больше г, тем ближе статистические характеристи-
ки модели к реальной последовательности. Однако за это приходится пла-
тить введением дополнительных параметров. Поэтому в зависимости от си-
туации может быть выбрана любая модель. Ниже мы приводим результаты
для всех трех.

Для пояснения существа алгоритма тип модели не имеет значения.
Возьмем (для определенности) неоднородную марковскую цепь первого по-
рядка. Такая цепь задается тремя векторами начальных вероятностей
Р‘(а), а=Т,С,А,С и тремя матрицами переходных вероятностей размера
4x4 Р1 (Ь|а), а,Ь = Т,С,А,С, 1=1,2,3. Численные значения составляю-
щих векторов и элементов матриц приведены в табл.2.2 и 2.3 гл.2.

Первым шагом алгоритма является вычисление четырех вспомогатель-
ных величин-статистик для фрагмента 2. Одна из них - Р(2|Н) - опреде-
ляет вероятность случайного обнаружения фрагмента, идентичного 2 в не-
кодирующей области, и вычисляется по формуле

Р(2|Н) = Р(а1)-Р(а2|а1)-...-Р(ап|ап_1). (3.8)

Три других величины обозначим через Р(2|к1), Р(2|к2) и Р(2|кЗ).
Р(2|к1) есть вероятность случайного обнаружения фрагмента в кодирующей
области и в таком положении, что нуклеотид а! оказывается в первой
позиции некоторого кодона. Р(2|к2) и Р(2|кЗ) определяют вероятности
обнаружения фрагмента 2 в кодирующей области и в положении, когда нук-
леотид а, занимает вторую или третью позиции некоторого кодона соот-
ветственно. Имеем

Р(2|к1) = Р’(а1)-Р1(а2|а,)-Р2(а3|а2)-...-Р3(ап|ап_1),

Р(2|к2) = Р2(а])"Р1 (а2 |а, )'Р3(а3 |а2)•... *Р3(ап |ап_1),	(3.9)

Р(2|кЗ) = Р3(а,)-Р3(а21а,)•Р,(а3 |а2)•...-Р'(ап |а„.,).

Теперь можно вычислить представляющие главный интерес значения
вероятностей Р(Н|2) и Р(к1|2), 1=1,2,3, дающие предсказания о том, на-
ходимся ли мы в кодирующей или некодирующей области. Причем достаточно

Рис. 3.6. Графики функций-индикаторов кодирующих областей для после-
довательности ЕСНЕСА в трех рамках считывания (а-в)

Применение метода марковских цепей с параметрами У=(1,16)

будет определить величины Р(к1|2), так как с большой степенью точности
можно принять, что Р(Н|2)=1- Р(к1|2) - Р(к2|2) - Р(кЗ|2). Исходя из
формулы Байеса получим

р(]С |2) = __________--------------------

П 11 1 X) Р(2|к,)-Р(\)+Р(2|Н)Р(Н)

(3.10)
Здесь Р(Н) и Р(к.), 1=1,2,3 являются так называемыми априорными
вероятностями событий Н и К, . Эти величины дают оценку вероятности
принадлежности фрагмента к некодирующей или кодирующей области еще до
того, как становится известна конкретная первичная структура фрагмента
2. Естественно принять, что Р(Н)= 1/2, Р(к. )=1/6, 1=1,2,3. Аналогами
этих величин в п.3.3 являются величины Щ., 1=1,2,3 и Чн.

Подобным же образом определяются величины Р(к1|2), 1=1,2,3 и
Р(Н|2) в тех случаях, когда моделью кодирующей области является неод-
нородная марковская цепь нулевого или второго порядка. В частности,

200	ЧОО	600	800

’ и с. 3.7. Графики функций-индикаторов кодирующих областей для после-
довательности ЕСЬЕХХ в трех рамках считывания (а-в)

Применение метода марковских цепей с параметрами У=(1,16)

для г=0 в формулах (3.9) появляется произведение позиционных вероят-
ностей встречаемости нуклеотидов (см. табл.2.1 гл.2). Для случая г=2
данные берутся из табл. 2.3 гл. 2.

Таким образом,Формальная сторона метода сводится к вычислению по
ормулам (3.8-3.10) значений Р(к, |2), 1=1,2,3 для множества фрагмен-
тов, которое генерируется окном, скользящим по рассматриваемой после-
довательности ДНК.
Обсуждение возможностей метода. Изложенный выше метод был реали-
зован на микроЭВМ "Искра-226" таким образом, что допускалось использо-
вание любой из трех марковских моделей кодирующей области. Параметр к
- ширину окна сканирования последовательности - можно было принять
равным 16, 2 или 48 кодонам. Окно последовательно сдвигалось на два
кодона и в каждом положении вычислялись вероятности Р(к,|2) 1=1,2,3
для фрагмента, попадавшего в просвет окна. Эти значения ставились в
соответствие центру полученного фрагмента. Далее для сокращенного
обозначения варианта расчета будем использовать запись У=(г,«), указы-
вающую порядок кодирующей области г и значение параметра V.

Рис. 3.8. Графики функций-индикаторов кодирующих областей для после-
довательности ЕСАКАС в трех рамках считывания (а-в)

Применение метода марковских цепей с параметрами 7=(1,16)

Для иллюстрации возможностей алгоритма были взяты последователь-
ности ЕСНЕСА, ЕСЬЕХХ и ЕСАКАС (обозначения из описания банка ЕМВЬ),
длиной 1390, 943 и 1246 нуклеотидов соответственно.

Последовательность ЕСКЕСА на участке (238, 1296) содержит ген
гесА регуляторного белка 508-системы Е.соН, обладающий способностью к
интенсивной экспрессии. Фрагмент (102, 707) последовательности ЕСЬЕХХ
является умеренно экспрессируемым геном белка 1ехА, который репресси-
рует синтез белков 503-системы. Последовательность ЕСАНАС содержит
низкоэкспрессируемый ген агаС (270, 1145), который кодирует бе-
лок-репрессор арабинозного оперона.

Для пояснения выбора объектов для анализа напомним, что законо-
мерности неслучайного использования синонимических кодонов в бактери-
альных генах могут быть связаны со степенью их экспрессии в клетке. С
другой стороны, выбор кодонов отражается и на статистических характе-
ристиках нуклеотидных последовательностей кодирующих областей. Поэтому
представляет интерес сопоставление результатов применения алгоритма
для кодирующих последовательностей со значительными различиями в пра-
вилах выбора синонимических кодонов.

На рис.3.6 представлены графики величин Р(к,|2), 1=1,2,3, полу-
ченных для последовательности ЕСВЕСА при У=(1,32). Рис. 3.6, а,б,в со-
ответствуют первой, второй и третьей рамкам считывания. Числа, стоя-
щие по горизонтали, дают отсчет количества нуклеотидов от начала пос-
ледовательности. Вертикальный масштаб соответствует интервалу (0,1).

Таблица 3.8

Значения риз, полученные для генов агаС, 1ехА, гесА

		1	агаС			1ехА			гесА
Порядок марковской модели	Пара- метр			Число		кодонов в		окне
		16	32	48	16	32	48	16	32	48
0	р 3	0,52 0,31	0,64  0,33	0,70 0,33	0,76  0,22	0,94  0,08	0,95 0,13	0,79  0,20	0,93 0,15	0,96 0,15
1	р 3	0,51 0,36	0,53 0,40	0,51  0,42	0,86 0,21	0,96  0,13	0,97 0,12	0,95 0,09	0,99 0,07	0,99 0,09
2	р 3	0,61 0,34	0,69 0,33	0,76 0,30	0,90 0,22	0,94 0,22	0,90 0,28	0,98 0,14	0,96 0,18	0,97 0,16

На уровне 0,5, так же как и в п.3.3, сплошными линиями отмечены цепоч-
ки триплетов, не содержащие терминирующих кодонов.

На рис.3.7и3.8 даны графики величин Р(к1|2), 1=1,2,3, полу-
ченных в случае У=(1,16) для последовательностей ЕСЬЕХХ и ЕСАНАС. Нет-
рудно видеть, что кодирующие области регистрируются на рис. 3.6,а,
3.7,в и 3.8,в, причем поведение функций-индикаторов имеет неодинаковый
характер. Качество предсказания кодирующей области как единого целого
ухудшается от ЕСКЕСА к ЕСАНАС. В случае ЕСНЕСА значения индикатора в
кодирующей области почти везде не менее 0,75. Функция для ЕСЬЕХХ на
рис.3,7,в имеет один провал ниже уровня 0,5. Подсказка в виде инфор-
мации об открытой рамке в значительной степени спасает положение на
рис. 3.8,в, так как индикатор имеет многократные провалы до уровня
0,3 и даже до 0,1.
Из рис. 3.6-3.8 видно, что если бы в расшифровке ДНК возникла
ошибка типа делеции или вставки некоторого числа нуклеотидов, не-
кратного трем, то она проявилась бы в перескоке индикатора области иг-
одной рамки в другую.

Формально качество предсказания кодирующей области в целом можн<
отразить при помощи средних значений - <р> , величин Р(К|2), взятых I

Нис. 3.9. График функции-индикатора кодирующих областей для после-
довательности ЕСАКАС в третьей рамке считывания

Использование алгоритма с параметрами У=(2,48)

В данном случае для гена гесА <р>=0,95, з1=0,09, для гена 1ех;
<р>=0,86, з=0,21 и для гена агаС <р>=0,51, з=0,36. Те же величины
рассчитанные по другим вариантам алгоритма, приводятся в табл. 3.8 -
<р> в числителе, а з в знаменателе.

Рис. 3.10. График функции-индикатора кодирующей области для последо-
вательности ЕСККНВ2

Последовательность содержит "открытую рамку", используется алгоритт.
с параметрами У=(2,32)

Согласно этой таблице, наибольшая степень разрешения для генг
агаС достигается в случае У=(2,48). На рис.3.9 приводится график соот-
106
ветствующей функции индикатора. Из табл.3.8 также видно, что если для
генов 1ехА и гесА использовать алгоритм с «=16, то степень разрешения
увеличивается с увеличением г. Причем для гесА уже 7=(1,16) дает ре-
зультат, который не удается существенно улучшить при больших V и всех
других г. Аналогичный результат имеет место в случае 1ехА, если
У=(2,16).

Рис. 3.11. Плотности распределения значений байесовской вероятности
кодирования

а - для кодирующих; б - для некодирующих областей

Вариация величины <р> для разных генов (для модели одного и того
же порядка) говорит о неоднородности статистических закономерностей в
первичной структуре генов Е.соН. Представляется достаточно очевидным,
что природа этой неоднородности связана с различными стратегиями ис-
пользования кодонов в сильно, умеренно и слабо экспрессируемых генах.
Полученные результаты демонстрируют вполне отчетливую тендецию измене-
ния величин <р> и з с ослаблением экспрессии гена и свидетельствуют о
том, что при фиксированных параметрах алгоритма степень разрешения ко-
дирующей области будет тем выше, чем сильнее экспрессия.

Трудности, подобно рассматривавшимся ранее случаям, возника-
ют в исследовании низкоэкспрессируемых генов. Здесь, как показы-
вает пример агаС, относительное улучшение результатов достигается.

Таблица 3.9

Значения показателя надежности предсказания

V	1	г	  1	0	1	1	|	2
48  72  96	0,82	0,84	0,91  0,87	0,89	0,92  0,90	0,91	0,96
Рис. 3.12. Применение метода марковских цепей для последовательности
ЕСАТРХ в случае У=(2,32)

Отмечены гены а - аЪр1; б - а!рВ; в - а1рЕ; г - а!рР; д - а!рН

если использовать максимальный порядок модели и максимальную ширин’
окна. Заметим, что принципиально этот вопрос может быть решен путег.
настройки параметров алгоритма на статистические особенности конкрет-
ной группы генов (Е1сЬап1, СаиЫег, 1987).
500	!000	1500	2000	2500

Рис. 3.13. Применение метода марковских цепей для последовательности
ЕСАТРХ в случае У=(0,32)

В связи с изложенным выше рассмотрим также еще не полностью функ-
ционально идентифицированную последовательность ЕСЕЛВ2, содержащую ри-
босомальный оперон. В этой последовательности зафиксирована открытая
рамка считывания на интервале (275,1141), но ее кодирующие свойства
экспериментально не установлены. На рис.3.10 приводится график функ-
ции-индикатора во второй рамке считывания данной последовательности
для У=(2,32). Значения <р>, з для интервала (275,1141) равны 0,73 и
0,34 соответственно. Это дает основание предполагать, что фрагмент
(275,1141) кодирует еще не обнаруженный белок Е.соИ с невысокой сте-
пенью экспрессии. Интересно, что в этом случае значение функции Фик-
кетта Е равно 0,98, а вероятность кодирования по методу контекстных
частот (см. табл.3.7) - 0,525, т.е. также предсказываются кодирую-
щие свойства.

0	500	1000	1500	2000

б

	I	1_
0	500	1000

Рис. 3.14. Применение методов 4-го (а) и 5-го (б) порядка для эука-
риотических ДНК

а - транскрибируемая последовательность гена леггемоглобина сок
длиной 1254 нуклеотида; б - транскрибируемая последовательность гена
бета-глобинового гена человека длиной 1615 нуклеотидов; е, - экзоны

Для "метода марковских цепей", так же как и в п.3.3, могут быть
определены при фиксированных г и «г плотности распределения значений
статистики Р(К|2) на выборках кодирующих и некодирующих областей -
а(р|к) и а(р|н).

Из рис. 3.11, где представлены эти функции для случая г=2, «=32,
видно, что они сосредоточены на концах области определения и в основ-
ном не перекрываются.

Введем показатель надежности предсказания К = 1 - (е1+е2)/Ы.
Здесь е1 - число ошибок первого рода - классификации кодирую-
ющих фрагментов как некодирующих; е2 - число ошибок второго рода -
классификации некодирующих фрагментов как кодирующих; Д - общее число
рассмотренных фрагментов. Величина К зависит от порядка модели, ширины
окна и выбранного порогового значения Р, функции-индикатора, которое
имеет следующий смысл: если Р(к|2) > Р. , то фрагмент относится к
кодирующим, если Р(К|2) < Р,, то - к некодирующим. Значение Р,
110
можно выбрать оптимальным в смысле максимума К, исходя из известного
вида плотностей распределений б(Р|К) и б(Р|Н). Величины К в зависимос-
ти от г и V приводятся в табл 3.9.

 Для сопоставления данного метода с методом Стадена (селекции ко-
донов) и методом контекстных частот, изложенным в п.З.3, обратимся к
последовательности ЕСАТРХ. На рис.3.12 и 3.13 приводятся графики функ-
ций индикаторов для У=(0,32) и У=(2,32). В случае У=(2,32) четыре хо-
рошо известных гена идентифицируются вполне удовлетворительно и лучше,
чем в варианте У=(0,32). Однако интересно, что кодирующая область
(177,566) дает в случае У=(0,32) более сильный сигнал, чем в
варианте У=(2,32).

Это свидетельствует об использовании здесь необычного для Е.соИ
набора и чередования кодонов, так как к этим факторам алгоритм
с моделью второго порядка более чувствителен, чем алгоритм с моделью
нулевого порядка. Заметим, что вероятность кодирования по методу кон-
текстных частот (п.3.3) для этой области, определенная при г=3 и ш=15,
равна 0,493. Таким образом, ОРС (177,566) в последовательности ЕСАТРХ
представляет как бы нечто среднее между кодирующими и некодирующими
областями и, по нашему мнению, является наглядным аргументом в пользу
того, что статистические характеристики кодирующих и некодирующих об-
ластей еще недостаточно исследованы. Иначе говоря, мы полагаем, что
рассмотренный метод распознавания еще недостаточно использует информа-
цию, содержащуюся в нуклеотидной последовательности для характеристики
ее функциональных свойств.

Одним из естественных шагов в этом направлении было бы увеличение
порядка марковской модели. Такая работа была предпринята Клаверье и
Бугельре (С1ачег1е, Вои§ие1еге1, 1986). Они использовали в методе рас-
познавания экзонов в первичной структуре ДНК эукариот результаты
1-граммного анализа обучающих выборок кодирующих и некодирующих облас-
тей при 1=5 и 1=6. Введенный ими индекс дискриминации
^ехоЛ^хоЛгигоп) полностью аналогичен байесовской вероятности в
формуле (3.10), если полагать, что в качестве фрагмента 2 рассматрива-
ется олигонуклеотид из 5 или 6 оснований (а цепь Маркова имеет порядок
4 или 5 соответственно). Таким образом, график значений индекса дис-
криминации, вычисляемых вдоль последовательности ДНК, является индика-
тором кодирующих и некодирующих областей и, как видно из рис.3.14, да-
ет весьма обнадеживающие результаты для эукариотических геномов.

3.5.ЗАКЛЮЧЕНИЕ

Рассмотренные методы и результаты, полученные с их помощью, гово-
рят о том, что компьютер в состоянии прочесть закодированные в статис-
тических характеристиках признаки функциональных областей и перевести
Их на понятный язык либо в виде индикаторов, осуществляющих визуали-
зацию кодирующей области непосредсвенно на тексте ДНК, либо в виде
прямых предсказаний функциональных свойств, выполняемых с вполне опре-
деленной степенью надежности.

Многочисленность методов такого рода отражает многообразие ста-
тистических особенностей кодирующих областей, иногда тесно связанных
между собой, как, например, позиционные частоты моно-, ди- и тринукле-
отидов.

Мы видели, что существует два типа методов: 1) универсальные -
для последовательностей ДНК любых организмов; 2) настраиваемые на
специфические особенности первичной структуры ДНК определенного орга-
низма (таксона) на основе обучающей выборки. Первые менее точны, но
быстрее дают результаты, вторые требуют для получения большей точности
дополнительных затрат на создание и анализ обучающей выборки.

Следует сказать, что корректного сравнительного анализа известных
методов распознавания кодирующих областей еще не производилось, что
связано, с одной стороны, с множественностью критериев (надежность
предсказания, скорость получения результатов, потребность в ресурсах
ЭВМ), а с другой - с неоднородностью предметной области (эффективность
разных методов неодинакова на таксономически разных ДНК). Исследова-
ния, которые ведутся по методам распознавания кодирующих областей эу-
кариот, должны суммировать приобретенный опыт, определить строгие кри-
терии для оценки получаемых результатов и внести ясность в иерархию
методов и моделей.
Глава 4. РАСПОЗНАВАНИЕ ФУНКЦИОНАЛЬНЫХ
СИГНАЛОВ

4.1.	СИГНАЛЫ В НУКЛЕИНОВЫХ КИСЛОТАХ

Наверное самые интересные события компьютерной генетики касаются
распознавания функциональных сигналов по последовательности нуклео-
тидов в ДНК. Эти работы были начаты практически одновременно с появ-
лением первых генетических текстов, но, кажется, им еще далеко до
завершения. Чем глубже вникают исследователи в суть проблемы, тем
сложнее представляется ее решение. До сих пор нет даже строгого об-
щепринятого определения терминов функциональный сигнал и сайт. Впро-
чем, примерно можно определить сайт как конкретный участок последо-
вательности минимальной длины, достаточный для выполнения определен-
ной функции. Функциональный сигнал - более общее понятие, соответст-
вующее классу последовательностей, выполняющих одинаковую функцию.

Прежде чем проследить за интригующим развитием идей и методов в
работах по распознаванию, мы сначала познакомимся с примерами функ-
циональных сигналов на нуклеотидных последовательностях. Наш микро-
обзор не охватит даже десятой доли интенсивно исследуемых в настоя-
щее время сигналов, однако в нем найдут свое отражение важные для
распознавания свойства сайтов и принципы их работы.

Сигналы, узнаваемые рестриктазами. Эти самые простые для рас-
познавания сигналы чрезвычайно важны для выполнения генноинженерных
работ. Из всего математического обеспечения, предназначенного для
анализа нуклеотидных последовательностей, чаще всего используется
программа рестриктазного картирования, определяющая положение рест-
риктазных сайтов на последовательности ДНК. Рестриктазы узнают некое
сочетание из 4-8 нуклеотидов и разрезают молекулу ДНК, как правило,
в каком-то месте этого слова или неподалеку от него.

В настоящее время известны сайты узнавания более 650 разных рест-
риктаз (Кезз1ег, НоИке, 1986). Несмотря на сравнительную легкость
локализации их по первичной структуре, на примере этих сайтов прос-
леживаются основные трудности общей проблемы распознавания.

Во-первых, сайт узнавания и место разрезания могут находиться на
значительном расстоянии: так, рестриктаза ТацП разрезает молекулу
на И нуклеотидов правее узнаваемого сайта, некоторые рестриктазы
расщепляют ДНК в еще более неожиданном месте: на 100-1000 нуклеоти-
дов правее своего сайта (считается, что последовательность ДНК запи-
сана в направлении 5'-3' и правее означает ближе к 3' концу). Зна-
чит, нам нужно определять положение узнаваемого сайта относительно
экспериментально найденных точек расщепления.

Во-вторых, сайт может содержать вырожденные нуклеотиды. Например,
сайт рестриктазы Н1пй11 выглядит так: СТУВАС, где У - это Т или С, а
К - А или 0. Поэтому наша задача значительно усложняется - ведь ря-
дом с местом разрезания может не быть одинаковых слов! В одном слу-
чае рестриктаза будет связываться с последовательностью СТТСАС , а в
другом, например, - с СТСААС.

В-третьих, узнаваемая последовательность зависит от условий, в
которых идет рестрикция. Рестриктаза ЕсоК1 в обычных условиях бакте-
риальной клетки расщепляет последовательность СААТТС. Однако при
низкой ионной силе и высоком значении рН специфичность воздействия
этой же рестриктазы, обозначаемой уже ЕсоКР, снижается: расщепле-
нию теперь подвергаются сайты ААТТ (РоИзку еФ а!., 1975). Рестрик-
таза ВатН1 (канонический сайт ССАТСС) при повышенном содержании гли-
церина воздействует также на сайты ССААСС, СССТСС, СССТСС и СААТСС
(Сеог§е, СММкрап, 1982). Таким образом, при распознавании сайтов
важно знать условия, в которых протекает реакция взаимодействия фер-
мента с молекулой ДНК.

В-четвертых, эффективность расщепления зависит от последователь-
ности, окружающей сайт (Сагитов и др., 1987).

В-пятых, нужно учитывать взаимодействие сайтов: близко располо-
женные участки узнавания могут экранироваться от посадки своей рест-
риктазы другими ферментами, подвергаться иным влияниям соседних сай-
тов (Теггу еФ а1., 1985).

Вот основные задачи, которые приходится решать при выведении ка-
нонической последовательности любого функционального сайта. Несмотря
на то, что для большинства сайтов многие из этих проблем представля-
ются чрезвычайно трудными, в некоторых случаях удается добиться неп-
лохих результатов. Подтверждением тому служит распознавание рестрик-
тазных сайтов.

Промоторы. Промоторы - это сигналы начала синтеза РНК, узнавае-
мые ферментом РНК-полимеразой, и определяющие место и эффективность
транскрипции. Вид промотора меняется в зависимости от организма,
сохраняя при этом некоторые общие черты. Больше всего известно про-
моторов РНК-полимеразы ЕзсЬег 1сМа соИ: последняя выборка их после-
довательностей содержит более 250 наименований (Наг1еу, КеупоИз,
1987). Сделаны выборки промоторов некоторых эукариот (Низз1по7,
1986а), дрожжей (БоЬзоп, еФ а1., 1982) и ряда других организмов. 3
каждом случае выделены характерные особенности этих регуляторных
участков. Из-за их большой биологической значимости промоторы предс-
тавляют собой наиболее хорошо изученный тип сигналов.

Устоявшимися признаками промоторов Е.соИ являются блоки нуклео-
тидов, расположенные в районах -35 и -10, считая от точки начала
114
синтеза РНК. Типичными последовательностями этих блоков, называемых
блоками Гильберта и Прибноу соответственно, являются ТТСАСА и
ТАТААТ. Считается, что расстояние между ними изменяется от 15 до 21
нуклеотида, а блок Прибноу может отстоять от начала транскрипции на
4-8 оснований.

РНК-полимераза Е. со11 состоит из пяти субъединиц, одна из кото-
рых (сигма) отвечает за специфичность связывания, а остальные,
по-видимому, выполняют структурную и неспецифически ДНК-связывающую
функции. Без сигма-субъединицы РНК-полимераза связывается со случай-
ными фрагментами ДНК и начинает транскрипцию в произвольном месте.
Для продолжения транскрипции сигма-субъединица не нужна и в норме
она отделяется от РНК-полимеразы после синтеза нескольких первых
нуклеотидов. Есть основания полагать, что в Е.соИ существует нес-
колько сигма-субъединиц, каждая из которых узнает свою последова-
тельность и игнорирует промоторы чужих сигма-субъединиц. Впервые это
было показано на транскрипции генов теплового шока (Сгоззшап е! а1.,
1984), затем на генах нитроголодания (НипФ, Ма§азап1к, 1985) и неко-
торых других генах. Биологический смысл этого понятен: клетке для
выживания в тяжелых условиях необходима экспрессия ограниченного на-
бора генов, синтез которых вовсе необязателен в норме; и всю мощь
синтезирующей машины она переключает на производство этих генов од-
ной лишь только заменой сигма-субъединицы.

В других организмах дело обстоит еще сложнее. Так, В.зийШз на
разных стадиях своего развития использует по крайней мере шесть сиг-
ма-субъединиц (Во!, ^ап§, 1986). В эукариотах работают три РНК-поли-
меразы, одна из которых транскрибирует рРНК, другая тРНК, а третья -
все остальные гены. Кроме такого разнообразия полимераз и их струк-
турных субъединиц, в транскрипции могут принимать участие разнооб-
разные репрессоры и активаторы, низкомолекулярные факторы (типа цАМФ
и ррСрр) и, по-видимому, еще что-то, чего мы пока не знаем. На эф-
фективность инициации большое влияние оказывает к тому же форма ДНК,
в частности степень ее сверхспирализации.

Однако, несмотря на такое обилие факторов, участвующих в транск-
рипции, есть достаточно оснований считать, что мы можем научиться
искать промоторы на молекуле ДНК, исходя только лишь из последова-
тельности нуклеотидов в ней. Ведь промоторы, узнаваемые ферментом
одного типа, имеют сходную первичную структуру, проблема заключается
в формализации этого сходс.тва.

Сайты связывания репрессоров и активаторов. То, что регуляторы
транскрипции должны присоединяться к выделенным местам на молекуле
ДНК стало понятно сразу после их открытия. Многие промоторы регули-
руются своими репрессорами, которые присоединяются к участку ДНК,
называемом оператором. Хброшо изученными примерами являются регуля-
торные области генов 1ас (СПЪегФ еФ а1., 1976), Фгр (ВеппеФФ,
УапоГзку, 1978) у Е.соИ и системы генов фага лямбда (РФазЬпе,
1978). Репрессор, связываясь с оператором, может закрывать част;,
промотора и стерически предотвращать инициацию транскрипции. У эука-
риот регуляторные элементы могут быть отделены несколькими сотнями
нуклеотидов от премоторной области и могут активировать (КЬоигу,
Сгизз, 1983) или подавлять (Вгапй е! а!., 1985) транскрипцию незави-
симо от их ориентации и расположения относительно точки начала син-
теза РНК. Недавно у Е.соИ тоже были обнаружены дополнительные регу-
ляторные последовательности, расположенные на значительном расстоя-
нии от промотора как до точки инициации транскрипции в ага (НаНп ег
а1., 1984) и бео (Уа1епИп-Напзеп е! а1., 1986), так и после нее =
§а1 (1гап1 е! а1., 1983) и 1ас (Е1зтапп е! а1., 1987) оперонах.

Терминаторы. Место, где заканчивается синтез РНК называется
терминатором. Для прокариотических терминаторов характерно наличие
шпильки, образованной С-С богатыми инвертированными повторами и сле-
дующий за ней поли-П последовательность. Наглядно представить себе
механизм терминации можно, например, так: РНК-полимераза проходит
инвертируемые повторы, только что синтезированный освободившийся от
полимеразы участок РНК собирается в стабильную шпильку и при этом
оставшийся кусок РНК как бы выдергивается из-под фермента. Наличие
поли-1) облегчает высвобождение РНК из транскрипционной машины благо-
даря слабому комплементарному взаимодействию.

Известен также механизм терминации с участием белкового ро-фактс-
ра. Здесь нет уже ярко выраженных признаков вторичной структуры, а
методы распознавания ро-зависимых терминаторов развиты слабее и ме-
нее эффективны.

Выборка прокариотических терминаторов на 1986 г. состояла из 49
независимых, 52 предположительно независимых и 20 ро-зависимых тер-
минаторов (Вгепбе! е! а!.,1986).

Сайты сплайсинга. Сплайсинг - это основной этап в созревании
эукариотической мРНК, в результате которого вырезаются некодирующие
куски молекулы РНК, называемые интронами, а оставшиеся кодирующие
фрагменты (экзоны) объединяются в одну непрерывную молекулу мРНК.
Поражает необыкновенная точность сплайсинга: вырезание происходит з
строго определенном месте, не допустима ошибка даже на один нуклео-
тид. Принято считать, что в сплайсинге участвуют некоторые белки и
малые ядерные РНК; однако показано, что сплайсинг может осуществ-
ляться и без участия внешних агентов (автосплайсинг) (Кги§ег е!
а1.,1982).

Сайты инициации трансляции. НВБ-сайты (г1Ьо5оше Ыпс11п§ зИез)
ответственны за прикрепление рибосом к молекулам мРНК в процессе
инициации трансляции. От эффективности связывания рибосом во многом
зависит экспрессия синтезируемого белка. Поэтому изучению этих сай-
116
тов било посвящено немало работ, а выборки гЬз-сайтов содержат около
200 последовательностей (ЗФогто еФ а1., 1982а).

В прокариотах участки мРНК, с которыми осуществляется связывание
рибосом, содержат, как правило, последовательность, частично компле-
ментарную 3'-концевому участку рибосомной 163 РНК и называемую пос-
ледовательностью Шайна - Дальгарно (5Ь1пе, Ва1§агпо, 1974). Наиболее
консервативным фрагментом этого участка является кластер пуринов
АССАСС.

После связывания с молекулой РНК рибосома должна найти инициирую-
щий кодон. Обычно он располагается в 3-10 нуклеотидах от последова-
тельности Шайна - Дальгарно и в подавляющем большинстве является
АИС, гораздо реже СПС и еще реже ЦСС триплетом.

По-видимому, большую роль в инициации трансляции играет вторичная
структура мРНК. Похоже, что функциональные области (последователь-
ность Шайна - Дальгарно и инициирующий кодон) предпочтительно нахо-
дятся в свободном, неструктурированном состоянии (Сапога, е! а1.,
1987).

Другие сигналы. Список всех известых функциональных сигналов
составляет на сегоднешний день более 200 наименований (Миззтпоч,
1986Ь). В этой же работе был проведен их статистический анализ, кор-
ректость которого вызывает сомнение и прежде всего из-за разнород-
ности выборки. Впрочем, можно считать, что все эти последовательнос-
ти выполняют функцию связывания с белками и что такой анализ позво-
лит выявить некоторые закономерности, отличающие подобные сайты от
других участков ДНК.

Важными сигналами являются места начала репликации (ог!-сайты),
сайты интеграции транспозонов, фагов и вирусов, места атаки топоизо-
мераз, "горячие" точки мутагенеза, а также многочисленные сайты свя-
зывания с разными белками.

В принципе, многие методы, применяемые для распознавания сигналов
на нуклеотидных последовательностях, могут быть использованы и для
распознавания сигнальных последовательностей в белках. Примерами
сигналов в белках являются места процессинга, антигенные детерминан-
ты, секреторные пептиды.

4.2.	СТРАТЕГИЯ РАСПОЗНАВАНИЯ

Постановка задачи. Приведенные выше и многие дру-
гие функциональные сигналы имеют между собой общее свойство: во всех
сигналах определяющую роль играет нуклеиново-белковое взаимодейст-
вие, узнавание ДНК или РНК отдельными белками и более сложными "фер-
ментативными машинами". Нуклеиново-белковое узнавание может изучать-
ся с разной степенью детальности. В последнее.время появляются дан-
ные о молекулярных структурах нуклеиново-бельевых комплексов, и пер-
спективность моделирования функционирования ДНК на молекулярном
уровне не вызывает сомнения. Однако для большинства функциональных
сигналов такое моделирование невозможно: слишком сложно устроены
ферментативные машины, к тому же во многих случаях неизвестны не
только последовательности белков, взаимодействующих с ДНК, но и сами
белки не идентифицированы. Поэтому выявлять общие черты последова-
тельностей, несущих функциональный сигнал, приходится на уровне
представления о нуклеиновой кислоте как о тексте, состоящем из букв
- нуклеотидов (генетическом тексте). В результате изучения функцио-
нальных сигналов складывается такое впечатление, что обычно для вы-
явления наиболее характерных для функционального сигнала черт оказы-
вается достаточно рассматривать нуклеиновую кислоту как последова-
тельность букв нуклеотидного алфавита.

Основной целью изучения функциональных сигналов является построе-
ние некоторого решающего правила, выделяющего сигналы на новой пос-
ледовательности. Для этого необходимо придумать алгоритм, на входе
которого будет нуклеотидная последовательность, а на выходе - ее
свойства, и реализовать его в программе для ЭВМ. Программа может вы-
давать, к примеру, число 1, если предъявлен функциональный сигнал, и
О, если предъявлена несигнальная последовательность. Такая постанов-
ка задачи типична для программ распознавания образов. Настоящая гла-
ва посвящена в основном описанию некоторых общих подходов к проекти-
рованию программ, распознающих функциональные сигналы.

Накопленный опыт исследования функциональных сигналов позволяет
говорить о сложившейся методологии построения их поискового образа,
проиллюстрированной на рис.4.1. (Термин "поисковый образ" введен
здесь для обозначения совокупности модели функционального сигнала и
конкретного значения параметров модели, речь о которых пойдет ниже.)
Начинается этот процесс со сбора информации о функциональных сигна-
лах - составления выборки.

СОСТАВЛЕНИЕ ВЫБОРКИ (НАЧАЛЬНОЕ ВЫРАВНИВАНИЕ)

V

> ВЫБОР МОДЕЛИ

V

у-> ВЫЧИСЛЕНИЕ ПАРАМЕТРОВ МОДЕЛИ
МНОЖЕСТВЕННОЕ ВЫРАВНИВАНИЕ

------------ СРАВНЕНИЕ С ДРУГИМИ МОДЕЛЯМИ
Рис. 4.1. Стратегия распознавания. Пояснения
118

в тексте
Составление выборки. Обычно последовательность
биополимера, несущая функциональный сигнал, исследуется рядом экспе-
риментальных методов, каждый из которых дает свою специфическую ин-
формацию. Для того чтобы понять, что же отличает последовательности,
несущие функциональный сигнал, от всех остальных, необходимо собрать
И систематизировать большое количество экспериментальных данных. Ис-
следование функциональных сигналов в качестве одного из своих этапов
содержит составление сборников, содержащих последовательности и дру-
гую информацию, существенную для исследователя. Такой сборник мы бу-
дем называть выборкой или компиляцией.

Модели функциональных сигналов. Вто-
рой этап - построение модели, - пожалуй, наиболее важный в процессе
исследования функционального сигнала. Построение начинается уже в
ходе накопления экспериментальной информации.

Как мы видели ранее, каждый функциональный сигнал характеризуется
некоторым набором признаков, например типом нуклеотидов в определен-
ных позициях на последовательности, инвертированными повторами, спо-
собными образовать шпильки в РНК, нуклеотидным составом участков ДНК
и др. Набор таких признаков, характерный для определенного функцио-
нального сигнала, и алгоритм их поиска мы будем называть поисковой
моделью (или просто моделью) функционального сигнала. Поисковая мо-
дель базируется на физической модели процесса. При разработке поис-
ковой модели необходимо учитывать схему процесса, в котором принима-
ет участие функциональный сигнал, предположения о важных участках
взаимодействия нуклеиновых кислот и белков, о структуре ДНК или РНК
в функционально активном комплексе и т.д. Некоторые примеры моделей
были приведены в разделе 4.1.

Вычисление параметров модели. Формули-
ровка поисковой модели включает определение набора характерных для
сигнала признаков и выбор алгоритма вычисления параметров модели.
Можно представить себе ситуацию таким образом, что параметры модели
используются для оценки конкретных констант взаимодействия в постро-
енной схеме процесса. В простейшем случае параметры служат для выяс-
нения того, лежит ли константа в диапазоне значений, позволяющих
сказать, что "сигнал есть", или же в диапазоне, означающем "сигнала
нет".

Для вычисления параметров модели применяются алгоритмы, типичные
Для программ распознавания образов. Это статистические алгоритмы,
описанные в гл. 2 и 3 и в разделе 4.3, алгоритмы дискриминантного
анализа, представленные в 4.4, получающие широкую популярность алго-
ритмы распознавания образов с использованием нейронных сетей
(НорПеИ, 1982). Процедуру выбора оптимальных параметров модели
Можно рассматривать как процесс обучения программы распознавания об-
Обычно на выходе программы распознавания бывает не два возможных
состояния - сигнал/несигнал, а число, называемое дискриминирующим
числом. На обучающей выборке сайтов это число принимает значения в
одном диапазоне величин, на выборке несайтов - в другом. Часто эти
диапазоны перекрываются, и тогда надежно отличить сайты от несайтов
не удается. Такое поведение программ, возможно, соответствует физи-
ческой реальности: количество сайтов с промежуточными между сайтами
и несайтами константами взаимодействия может оказаться велико (см.,
например, Вег§, Топ Н1рре1, 1987).

Множественное выравнивание. Третий этап
- множественное выравнивание - выявляет позиции, связанные с призна-
ками функционального сигнала. Напомним, что в гл. 1 выравниванием
называлась некоторая расстановка вставок и делеций на последователь-
ностях. В случае многих последовательностей, несущих функциональный
сигнал, выравнивание проводится с целью выстроить друг под другом
важные для функционирования последовательности участки, играющие
одинаковую роль в узнавании нуклеиновой кислоты белком. Если бы мы
знали детальную молекулярную картину взаимодействия в функциональном
комплексе, то не возникало бы сомнений в том, какие участки последо-
вательностей, несущих один и тот же функциональный сигнал, взаимо-
действуют с определенным участком белка или участвуют в других спе-
цифических взаимодействиях, и выравнивание могло бы быть проведено
однозначно. На практике имеющиеся экспериментальные сведения о сай-
тах ограничены, и иногда приходится выявлять аналогичные участки в
функциональных сигналах уже на основании самой последовательности.
Выравнивание при этом оказывается предположительным и зависит от мо-
дели и конкретных значений ее параметров. Изменение параметров может
привести к изменению выравнивания, что и отражено стрелкой на рис.
4.1. Задача выбора оптимальных параметров выбранной модели с очевид-
ностью относится к задачам оптимизации, и указанная стрелка отражает
то, что зачастую ищется не глобальный, а локальный оптимум и исполь-
зуются при этом итеративные алгоритмы.

Проверка модели. После вычисления оптимальных пара-
метров модели должна быть проведена оценка ее предсказательной силы.
Эта оценка включает в себя вычисление вероятностей ошибок разного
рода, а также сравнение вероятностей ошибок для альтернативных моде-
лей. Вычисления вероятностей ошибок могут быть проведены теоретичес-
ки, а может быть устроен экзамен моделей по распознаванию последова-
тельностей, не участвовавших в обучении.
4.3.	ВЫБОРКИ ФУНКЦИОНАЛЬНЫХ СИГНАЛОВ

Информация к размышлению о функциональных сигналах. Часто, гово-
ря о выборке последовательностей, подразумевают собрание только пос-
ледовательностей, однако следует иметь в виду, что сопутствующая ин-
формация тоже чрезвычайно важна, хотя иногда и не фигурирует явно. В
компиляции промоторов Е.соИ (Наг1еу, КеупоШз, 1987) помимо самих
последовательностей присутствует информация о системе транскрипции
(1п у1уо/1п у11го), о месте инициации транскрипции, о методах, кото-
рыми это место было установлено, об эффективности действия, о рефе-
ративных источниках. Вся совокупность систематизированных данных -
выборка - и составляет информацию для совместного размышления чело-
века и компьютера о функциональном сигнале.

Ниже перечислены основные соображения, которые принимаются в рас-
чет при построении выборки.

1.	Достоверность данных, зависящая от набора методов, примененных
при выявлении сайта и степени подтвержденности информации, получен-
ной разными методами. Для адекватной интерпретации данных необходимо
знание методов, применявшихся для ее исследования.

2.	Размеры участка нуклеотидной последовательности, содержащего
функциональный сигнал. Они выбираются исходя из экспериментальных
сведений о сигнале и его биологической природе с учетом требований
программ распознавания.

3.	Условия протекания процесса, в котором принимает участие сайт.
Эти условия должны быть по возможности одинаковы. Они включают в се-
бя организм или набор организмов, в которых выявлен изучаемый сиг-
нал, стадию развития, ткань, ферментативную систему и т.д. Лучше не
смешивать в одной выборке последовательности из разных организмов.
Пожалуй, единственный надежный критерий для выбора тех организмов, в
которых функциональные сигналы взаимозаменяемы, - возможность давать
полноценное потомство при скрещивании. В этом случае объединение
последовательностей в одной выборке может рассматриваться как обос-
нованное Природой. Во всех остальных случаях исследователю нужно
постараться обосновать решение об объединении последовательностей
самому.

4.	Особую ценность имеет информация о численном соотношении функ-
циональных активностей сайтов.

5.	Статистика набранных функциональных сигналов должна быть дос-
таточна для того, чтобы определить, какие же именно признаки превра-
щают последовательность в функциональный сигнал, а значит объем вы-
борки должен быть по возможности велик.

6.	При исследовании сигнала статистическими методами выборка не
должна содержать близкородственных последовательностей, т.е. должна
быть представительной. Если, к примеру, в выборке будут широко пред-
ставлены многочисленные мутанты некоторой последовательности, то ре-
зультирующий образ функционального сигнала может оказаться близок не
к сайту, типичному для генома в целом, а к тому сайту, который чаде
других встречался в компиляции. Некоторые методы, например дискрими-
нантный анализ, допускают работу и с непредставительными выборками.

7.	При исследовании позиционно-зависимой статистики последова-
тельности в выборке должны быть правильно выровнены друг относитель-
но друга. Основанием для выравнивания в первую очередь является экс-
периментальная информация о сигнале, такая как место инициации тран-
скрипции или трансляции, участок ДНК, защищаемый связанным с ним
белком от действия нуклеаз, два места разрезания РНК при вырезании
из нее интрона (одно соответствует 5х концу интрона, а другое 3'
концу) и т.д. В некоторых случаях выравнивание практически однознач-
но следует из экспериментальных данных, в других случаях его прихо-
дится искать с помощью программ.

Сайты и несайты. Существуют разные методы построения моделей
функциональных сигналов, для одних из них требуется выборка только
сайтов, для других дополнительно нужны несайты. К примеру, один из
путей исследования последовательностей, несущих функциональный сиг-
нал - это сайт-специфический мутагенез в сочетании с тестом на функ-
циональную активность. Логика рассуждений при рассмотрении результа-
тов такова: мы поменяли нуклеотид в определенном положении, произве-
ли делецию или вставку, и последовательность потеряла (или сохрани-
ла) свою функциональную активность. Фактически при этом исследова-
тель накапливает информацию не только о том, какие последовательнос-
ти несут функциональный сигнал, но и о том, какие последовательности
функционального сигнала не несут, и на этой основе делает свои выво-
ды. Следует отметить, что хотя на этапе построения модели выборка
несайтов нужна не всегда, для качественной проверки она бывает нужна
практически всегда. Построить удовлетворительную для этой цели вы-
борку несайтов иногда оказывается много труднее, чем создать выборку
сайтов. Подробнее на создании таких выборок мы остановимся в разделе
"Проверка программ распознавания".

Автоматизированное составление выборок. В настоящее время в свя-
зи с появлением баз данных нуклеотидных последовательностей расширя-
ется возможность автоматизированного составления выборок функцио-
нальных сигналов. Нет сомнения в том, что подобная практика будет
использоваться со временем все шире и шире. Однако неосторожное ис-
пользование таблиц особенностей баз данных СЕПВАМК (США), ЕМВЬ
(ФРГ), "Генэкспресс" (СССР) (см. гл. 7) может приводить к весьма
неприятным ошибкам. В качестве предостережения приведем пример, взя-
тьй из написанного Ф.Бучером и Э.Трифоновым "Письма к Редактору'
(ВисЬег, ТгИопоч, 1987).

Речь в этом письме идет о компиляции эукариотических последова-
тельностей, окружающих сайты инициации транскрипции, созданной
р.Нуссинов (Низз1поч, 1986а) при помощи программы, читающей таблицы
сайтов и особенностей базы данных ОЕКВАНК. Из 29 последовательнос-
тей, идентификаторы которых попали на одну из иллюстраций к статье,
авторы сочли 14 непригодными для статистического анализа, который
проводила Нуссинов, отмечая следующее: 1) в выборке много дубликатов
или близкородственных последовательностей; 2) выборка включает в се-
бя большое количество последовательностей кДНК, выровненных относи-
тельно случайного 5'конца клона кДНК, а не относительно настоящего
5'конца мРНК. Включение кДНК в компиляцию вообще выглядит проблема-
тичным, поскольку большинство генов содержит интрон на расстоянии
менее 200 нуклеотидов от начала мРНК. Более того, одна из упомянутых
14 последовательностей оказалось комплементарна мРНК и была выровне-
на относительно сайта полиаденилирования.

Даже если выборка составлена правильно, исследователь не застра-
хован от ошибок, имеющихся в базе данных. О наличии таких ошибок
свидетельствует анализ белок-кодирующих участков базы данных ЕМВЬ
(ФРГ), где встречаются одиночные делеции, вставки, приводящие к из-
менению кодирующей рамки и т.д. (БФиИсЬ, НоМе, 1989). Для выявле-
ния и устранения ошибок может применяться сопоставление записей, со-
ответствующих одной последовательности, в независимо заполняющихся
базах данных.

4.4.	ПРОСТЕЙШИЕ МЕТОДЫ РАСПОЗНАВАНИЯ СИГНАЛОВ

Что такое консенсус-последовательность? Составив выборки после-
довательностей, несущих функциональный синал, исследователь перехо-
дит к построению модели функционального сигнала. Правильное выравни-
вание во многих случаях известно из эксперимента, поэтому мы начнем
с рассмотрения такой ситуации, когда проблема выравнивания уже реше-
на.

Исторически первым методом описания общих черт многих последова-
тельностей стали консенсус-последовательности. Термин "консен-
сус-последовательность" отражает интуитивное представление исследо-
вателя о последовательности, характерной для определенного функцио-
нального участка. Обычно под консенсус-последовательностью понимает-
ся последовательность, на которую больше всего похож функциональный
Участок ДНК. Однако это определение настолько расплывчато и субъек-
тивно, что разные исследователи, глядя на один и тот же набор дан-
ных, могут написать разные консенсус-последовательности. Берг и Фон
Хиппель (Вег§, чоп Н1рре1, 1987) дают следующее определение консен-
сус-последовательности: "...последовательность, которая в каждой по-
зиции содержит нуклеотид, наиболее часто встречаемый в этой позиции
в наборе секвенированных природных последовательностей". Такое опре-
деление не лишено недостатков. Во-первых, исследователь пишет на
данном месте не просто наиболее часто встречаемый нуклеотид, он пи-
шет нуклеотид только в том случае, если его присутствие в данной по-
зиции кажется исследователю неслучайным. В противном случае он ста-
вит прочерк, означающий, что на данном месте может встретиться любой
нуклеотид. Во-вторых, в консенсус-последовательностях допускается
появление в одной позиции набора нуклеотидов, например пурина (А или
С) или пиримидина (Т или С), нуклеотида, образующего сильно связан-
ную пару нуклеотидов (С или С) или "слабую" пару (А или Т) и т.д.

С учетом высказанных замечаний определение консенсус-последова-
тельности можно переформулировать следующим образом: консенсус-пос-
ледовательность - это такая последовательность, которая в каждой по-
зиции содержит набор нуклеотидов, причем частота появления нуклеоти-
дов из набора в данной позиции в секвенированных природных последо-
вательностях значимо превосходит ожидаемую. При этом следует иметь в
виду, что иногда под консенсус-последовательностью понимают то, что
лучше называть строгим консенсусом, а именно последовательность, ко-
торая в каждой позиции содержит набор нуклеотидов, хотя бы один раз
встречающихся в данной позиции. Последовательность, сформированную
так, как предлагают Берг и Фон Хиппель, мы назовем наиболее вероят-
ной. Если следовать сформулированному нами определению консен-
сус-последовательности, то объяснить тот факт, что разные исследова-
тели пишут разные консенсусы, можно тем, что они пользуются разными
критериями статистической значимости наблюдаемых частот встречаемос-
ти нуклеотидов в определенной позиции.

Использование матрицы частот встречаемости для поиска функцио-
нальных сигналов. Написав консенсус, мы теряем значительную часть
информации о значимости присутствия на определенном месте того или
иного нуклеотида. Сохранить ее можно, записав информацию о частотах
встречаемости нуклеотидов в матрицу позиционных частот встречаемости
Е1Ь, где Ь принимает четыре значения, соответствующие четырем нук-
леотидам (А,Т,С,С), а 1 соответствует положению на последовательнос-
ти и изменяется от 1 до Ь, где Ь- полная длина участка последова-
тельности. Напимер, в ячейке Гза такой матрицы записано отношение
числа нуклеотидов С в положении 3 к числу последовательностей. При-
мер такой матрицы будет приведен ниже.

Принципы использования матрицы позиционных частот встречаемости
нуклеотидов мы продемонстрируем на примере работы Голованова и со-
авт. (&о1очапо7 еФ а1., 1982; Голованов, 1987). Здесь матрица частот
встречаемости используется для получения числа, характеризующего
конкретную последовательность как возможный функциональный сигнал по
слеДУЮЩемУ правилу: нуклеотиду Ь(1) в каждой позиции последователь-
ности соответствует один сомножитель, конкретное значение этого сом-
ножителя равно частоте встречаемости нуклеотида в матрице частот
встречаемости

3 = П Е1Ь(1) , (4.1)
1 = 1

где число 8 -это функция от нуклеотидной последовательности, назван-
ная авторами "СТАТСАЙТ". Записанную таким образом функцию можно пре-
образовать из мультипликативной в аддитивную

З1- = 1п(3) = Е 1п(Е1Ь(1)). (4.2)

Значения логарифмов частот встречаемости можно записать в отдель-
ную матрицу штрафов/премий (матрица весов, зсоге таЪгхх) 1К1Ь, в
которой записывается цена штрафа или премии, назначаемой (аддитивно)
в зависимости от того, какой нуклеотид встретился на данном месте.

В некоторых случаях вместо матрицы позиционных частот встречае-
мости мононуклеотидов используется аналогичная матрица для динуклео-
тидов. В ячейке Е1а динуклеотидной матрицы записана частота встре-
чаемости динуклеотида с! (6= АА, АТ, АС, АС, ТА, ...), начинающегося
в позиции 1. Функция 3 вычисляется аналогично формуле (4.1)

3 = П Р1а(1) , (4.3)
1 = 1

где Д(1)=Ь(1)Ь(1+1) - соответствующий динуклеотид.

Итеративное выравнивание. Функция "СТАТСАЙТ" была применена для
распознавания участков инициации трансляции системы Е.соИ (ЕВЗ).
Предположительно, для узнавания ЙВ5 существенны два района последо-
вательности мРНК: участок в районе инициирующего кодона (1С), и
участок Шайна - Дальгарно на расстоянии шести-девяти нуклеотидов от
инициирующего кодона (ЗБ). Размеры каждого участка (блока) выбира-
лись таким образом, чтобы он включал все позиции, в которых частоты
встречаемости нуклеотидов значимо (по критерию ХИ-квадрат) отлича-
лись от ожидаемых (1/4). Кроме того, авторы решили учесть участок,
обедненный С (СБ), в положении +11..+14 относительно точки инициации
трансляции (рис.4.2).

Начальное приближение матрицы частот встречаемости нуклеотидов в
каждом из блоков выбиралось исходя из первоначального выравнивания.
Затем вычислялось новое уточненное положение ЗБ блока в каждой пос-
ледовательности, по этим положениям строилось новое выравнивание и
составлялась новая матрица частот встречаемости моно- или динуклео-
тидов. Итерационный процесс проводился до тех пор, пока выравнивание
Не переставало меняться.
Для расстояний между 1С и 50 блоками составлялась своя матрица
частот встречаемости расстояний 8(Ь), которая мультипликативно учи-
тывалась при выборе правильного положения блоков на последователь-
ности. Наилучшим считалось такое положение блоков на последователь-
ности, при котором достигался максимум функции

8 = 8(1С)-8(8В)-8(Ь),

(4.4)

где 8(1С) вычислена по формуле (4.1) для участка 1С, 8(8Б) - для
участка 8Б. Тем самым алгоритм находил оптимальное выравнивание
каждой из последовательностей для сформировавшегося поискового
образа функционального сигнала.

	-15...-6		-5...+7			1-11. . .+14
А	80		1С			СО
5'			1		КОДИРУЮЩАЯ ОБЛАСТЬ
мРНК		АОС/СОС
Б	80	—	АОС/СОС	ЕКК=92%

В	80		АОС/СОС	ЕКК=62%

Г	80	—	АОС/СОС	(*)	ЕКК=77%

Д	80		АОС/СОС	(*)	ЕКК=64%

Е	80	-1 г	1С		ЕКК=44%

Ж	80		1С		—		СО	ЕКК=37%

(*) - динуклеотидная
матрица частот

Рис. 4.2. Построение и сравнение моделей сигналов инициации транс-
ляции системы Е.соИ (Со1очапоч еФ а1., 1982; Голованов, 1987)

А - статистически неслучайные области на выборке из 124 последо-
вательностей: 8Б - область сигнала Шайна - Дальгарно, 1С - область
вокруг инициирующего кодона, СБ - область в кодирующей части мРНК,
обедненная нуклеотидами С; Б - Ж - схемы шести моделей, использован-
ных при анализе, в моделях Б,В,Е,Ж рассчитывалась матрица частот мо-
нонуклеотидов; в моделях Г и Д - динуклеотидов. В моделях Б-Д в ра-
йоне инициирующего кодона рассматривались только три нуклеотида
(АОС/СОС), в Е и Ж - строилась матрица частот всей области -5. ..+7.
Прямая линия обозначает фиксированное расстояние между блоками, вол-
нистая - вариабельное. Справа указаны частоты ошибок при распознава-
нии контрольной выборки последовательностей, эти частоты использова-
лись для оценки качества моделей
Сравнение моделей ЕВЕ. Схематические изображения исследованных
моделей ЕВЕ приведены на рис.4.2. Разница между моделями состоит в
том, что в некоторых из них блоки считаются находящимися на фиксиро-
ванном расстоянии, в других - на переменном, в некоторых случаях
вместо частот мононуклеотидов используется матрица частот встречае-
мости динуклеотидов.

При вычислении частот, соответствующих каждой из моделей, исполь-
зовались 62 последовательности ЕВЕ, случайно выбранные из исходных
124 последовательностей (ЕФогшо еФ а1., 1982а). Для сравнения моде-
лей использовались два набора данных: 62 последовательности ЕВЕ, не
использованные при вычислении параметров модели, и последовательнос-
ти мРНК, из которых были вырезаны участки, содержащие известные сай-
ты инициации трансляции. Найденные в таких мРНК иницирующие кодоны
(независимо от рамки считывания) с прилегающими к ним участками пос-
ледовательностей мы в дальнейшем, следуя терминологии работы Стормо
(ЕФогшо еФ а1., 1982Ь), будем называть "не-ЕВЕ".

Для сравнения моделей был выбран критерий, основанный на качестве
распознавания выборок, содержащих экспериментально установленные
сигналы и инициирующие кодоны типа "не-КВЗ". Для распознавания сиг-
налов выбиралось некоторое пороговое значение функции, превышение
которого при анализе последовательности интерпретировалось как нали-
чие в данном месте функционального сигнала. При этом возможны ошибки

Область Шайна - Дальгарно

1		Г>с |	р,л	Р1С
-15	0,375	0,139	0,352	0,134
-14	0,177	0,157	0,432	0,235
-13	0,073	0,132	0,682	0,113
-12	0,040	0,018	0,138	0,804
-11	0,026	0,001	0,032	0,941
-10	0,079	0,058	0,704	0,159
-9	0,176	0,085	0,235	0,503
-8	0,246	0,102	0,385	0,267
-7	0,264	0,223	0,370	0,143
-б	0,339	0,132	0,489	0,039

Область инициирующего кодона

1	|	р.с	Р>л	р1с
-5	0,314	0,170	0,346	0,170
-4	0,282	0,162	0,459	0,097
-3	0,154	0, 194	0,555	0,097
-2	0,338	0,218	0,338	0,105
-1	0,338	0,178	0,378	0,105
+ 1	0,001	0,001	0,965	0,033
+ 2	0,997	0,001	0,001	0,001
+ 3	0,001	0,001	0,001	0,997
+ 4	0,164	0,091	0,389	0,356
+ 5	0,140	0,405	0,308	0,148
+ 6	0,389	0,140	0,381	0,091
+ 7	0,091	0,244	0,485	0,180

Область, обедненная 0

1		Р1С	|	Р1С
+ 11	0,445	0,236	0,236	0,083
+12	0,356	0,132	0,405	0,107
+13	0,140	0,204	0,477	0,180
+ 14	0,292	0,212	0,421	0,075

Расстояние между областью Шайна-
Дальгарно и инициирующим кодоном

Ь= 4	5	6	7	1 8
о,и	0,17	0,29	0,23	0,19

Рис. 4.3. Параметры матриц для расчета функции "СТАТСАЙТ" при рас-
познавании на последовательности сигналов инициации трансляции сис-
темы Е.соИ (СоИчапоч еФ а1., 1982? Голованов, 1987). Нулевые эле-
менты матриц частот встречаемости заменены малой величиной 0,001
двух типов: 1) ложная локализация функционального сигнала; 2) про-
пуск экспериментально установленного функционального сигнала.

Пороговое значение функции выбиралось так, чтобы частота ошибок
обоих типов (суммарная) была минимальной. Число ошибок нормировалось
на число анализируемых ВВЗ, а количественное соотношение не-ВВ8 и
НВЗ соответствовало их отношению для известных последовательностей
мРНК Е.соИ (ЗФогто еГ а1., 1982Ь). Из шести анализируемых моделей
на .рис.4.2 наилучшей была признана последняя. Значения параметров
функции, соответствующие этой модели, приведены на рис.4.3.

На рис.4.4 приведены гистограммы распределения значений функций,
полученных для моделей Б и Ж. Видно, что распределения для модели Ж
перекрываются существенно меньше, чем для модели Б. Возможны следую-
щие причины перекрывания распределений: 1) несовершенство модели,
наличие каких-либо факторов, не учтенных в модели, например вторич-
ная структура мРНК, препятствующая связыванию рибосомы, или конку-
рентное связывание какого-нибудь белка-регулятора; 2) наличие в вы-
борке несайтов неидентифицированных сайтов инициации трансляции, ко-
торое может быть вызвано их относительной слабостью, синтезом корот-
ких или нестабильных пептидов и другими причинами.

Способы вычисления матрицы весов. Большая часть алгоритмов поис-
ка сигналов на нуклеотидных последовательностях использует аддитив-
ный вариант вычисления дискриминирующего числа. Для этого составля-
ется таблица, описывающая, какую величину нужно добавить к дискрими-
нирующему числу, если встретился какой-либо признак на нуклеотидной
последовательности. Обычно в качестве признаков выступают наличие
определенного нуклеотида в данной позиции, реже - наличие динуклес-
тида (Вгепбе!, ТгИопоч, 1984), расстояние между консервативными

Рис. 4.4. Гистограммы распределений значения функции "СТАТСАЙТ”
для моделей Б и Ж с рис.4.2 (Со1очапоч е! а1., 1982; Голованов,
1987)

По оси абсцисс отложено округленное значение функции "СТАТСАЙТ" в
логарифмическом масштабе; по оси ординат вверх - в скольких последо-
вательностях из выборки 128 последовательностей КВЗ компиляции Стор-
мо (ЗФогшо е! а1., 1982а) встретилось данное значение функции; по
оси ординат вниз - в скольких последовательностях из выборки не-ВВо
встретилось данное значение функции
блоками нуклеотидов, можно вводить и другие признаки, например нали-
чие инвертированного повтора - последовательности, способной образо-
вать шпильку на РНК (Вгепбе! еФ а1., 1986) или А+Т содержание опре-
деленных участков ДНК.

В случае отдельных нуклеотидов-признаков матрица штрафов/премий
в ряде работ формировалась на основании матрицы частот встречаемости
нуклеотидов (6о1очапоч еФ а1., 1982; Нагг еФ а1., 1983; Ми111§ап еФ
а1., 1984; БФабеп, 1984Ь; СгоЬ, БФиЬег, 1988). Выдвигались различные
способы вычисленения вклада конкретных нуклеотидов в дискриминирую-
щее число, однако все методы отличались нюансами масштабирования и
давали в целом сходные результаты. Наибольший резонанс получила ра-
бота Маллигана и соавт. (Ми1Н§ап еФ а1., 1984), в которой была по-
казана корреляция между гомологическим индексом (Ьото1о§у зсоге) и
функциональной активностью промоторов 1п ч!Фго. Вклад каждой позиции
в гомологический индекс считался пропорциональным разнице между час-
тотой встречаемости данного и наиболее часто встречаемого нуклеотида
и нормировался на ожидаемое по статистике среднеквадратичное откло-
нение. Стаден (ЗФабеп, 1984Ф) использовал другую формулу (элемент
матрицы весов у него пропорционален логарифму частоты встречаемости
нуклеотида, что эквивалентно случаю ЗТАТ31ТЕ), однако, по свидетель-
ству Мак-Клура (МсС1иге, 1985), корреляция активности промоторов со
значением распознающей функции, подсчитанным по методу Стадена, име-
ет тот же порядок, что и полученная в работе Маллигана. Таким обра-
зом, на основании сравнения с экспериментом ни один из способов за-
полнения матриц не получил неоспоримого преимущества.

Функциональные сигналы и статистическая механика. В 1987 г. Берг
и Фон Хиппель (Вег§, чоп Н1рре1, 1987, 1988), исследовали вопрос о
том, какой формулой нужно пользоваться при вычислении элементов мат-
рицы штрафов/премий по матрице частот встречаемости нуклеотидов. Ав-
торы рассмотрели процесс ДНК-белкового связывания с точки зрения
статистической механики и показали, что при ряде предположений вклад
нуклеотида в дискриминирующее число можно оценить теоретически. Были
сделаны следующие предположения.

1.	Селекция индивидуальных белок-связывающих последовательностей
происходит таким образом, что энергия связывания находится в некото-
ром "полезном" для системы диапазоне значений. В зависимости от фун-
кциональной роли рассматриваемого ДНК-белкового взаимодействия этот
Диапазон может заметно варьировать от сайта к сайту.

2.	Число последовательностей в указанном диапазоне энергий связы-
вания, которые в принципе могут быть использованы, велико. Если се-
лекция происходит только на основе энергии связывания, мутационный
"нейтральный дрейф" последовательности в рамках этого селекционного
ограничения обеспечивает то, что все последовательности равновероят-
ны.

5 Заказ № 4327
3.	Каждое возможное основание Ь в позиции 1 вносит вклад Е1ькТ
в свободную энергию связывания с этим сайтом. Вклады отдельных пар
оснований предполагаются независимыми и потому аддитивными. Номер
наиболее сильно связывающего нуклеотида (пары) обозначим заглавной
буквой В; он задает нулевой энергетический уровень Е1В=0.

Таким образом, Е1Ь-это положительные числа, характеризующие
уменьшение свободной энергии связывания (в единицах кТ) в том слу-
чае, когда наиболее сильно связывающий нуклеотид в положении 1 заме-
няется на нуклеотид Ъ. Авторы назвали эту величину "локальной энер-
гией различения".

В этих предположениях наиболее сильно связывающая пара оказывает-
ся наиболее часто встречающейся, и вообще по частоте встречи можно
приблизительно определить энергию различения. Формула для оценки
энергий различения, выведенная Бергом и Фон Хиппелем, выглядит сле-
дующим образом:

Е1Ь= 1п(

п.в+1

П1Ь + 1

(4.5)

где п1В - это число встреч наиболее часто встречавшейся пары в по-
зиции 1; п1ь - число встречаемости пары Ь. Энергия различения пос-
ледовательности в целом вычисляется как сумма энергий различения от-
дельных нуклеотидов.

Формула (4.5) задает способ вычисления (аддитивного) штрафа в ве-
совой матрице на основании матрицы позиционных частот встречаемости.
Формулы заполнения весовой матрицы, предложенные Харром (Нагг еУ
а1., 1983), Маллиганом (МиШ^ап еФ а1., 1984) и Стаденом (ЗФабеп,
1984Р), могут быть получены из формулы (4.5) путем пренебрежения ма-
лыми членами и добавлением постоянных.

Описанный выше подход ведет к предположению, что последователь-
ность, составленная из наиболее вероятных нуклеотидов, окажется наи-
более сильным функциональным сигналом. Несколько последовательнос-
тей, близких к наиболее вероятной для промотора, были синтезированы
и испытаны на транскрипционную активность. Оказалось, что статисти-
чески "хороший" промотор обладает достаточно высокой функциональной
активностью как 1п у!уо, так и 1п уИго (МсС1иге, 1985). Среди при-
родных последовательностей промоторов Е.соИ не известно такой, у
которой одновременно имеются канонические -10 и -35 боксы, что сви-
детельствует о том, что клетка не максимизирует премоторную актив-
ность. Возможно, что оптимизация функциональных сигналов идет по пу-
ти, предположенном Бергом и Фон Хиппелем, - по пути минимизации вли-
яния мутаций на функциональную активность.
Использование информации об эффективности функционального сигнала
^едение количественной меры эффективности функционального сигнала
представляет собой достаточно большую проблему. Для многих функцио-
нальных сигналов используется несколько экспериментальных процедур -
тестов на функциональную активность, каждой процедуре соответствует
своя числовая величина - эффективность функционального сигнала, ха-
рактеризующая конкретную последовательность, предъявленную тест-сис-
теме. Если выстраивать сайты в порядке возрастания их эффективности
в одном тесте, то далеко не всегда порядок расположения сайтов будет
сохраняться при изменении теста или экспериментальных условий. Одна-
ко наличие таких данных побуждает исследователей каким-либо образом
учесть их при составлении программы распознавания функциональных
сигналов.

Описанные выше статистические методы не предполагали знания эф-
фективности функционального сигнала, а в том случае, когда эффектив-
ность была известна, она не могла быть адекватно учтена алгоритмом
построения матрицы весов. Оптимальное решение задачи определения
матрицы штрафов/премий при наличии достаточного количества данных об
эффективности функционального сигнала было продемонстрировано в ра-
боте Стормо и др. (ЗФогто е! а1., 1986). Предположение, выполнение
которого необходимо для построения матрицы при помощи метода множес-
твенной регрессии, состоит в том, что измеренная величина эффектив-
ности некоторого функционального сигнала является арифметической
суммой эффектов, связанных с отдельными признаками.

Выполнение указанного предположения требует очень тщательного вы-
бора шкалы эффективностей - ведь мы можем использовать как саму экс-
периментально измеренную величину (например, константу связывания),
так и функцию от нее (например, логарифм). Далеко не очевидно, что
экспериментально измеренная величина или ее функция отражают адди-
тивную связь эффектов отдельных признаков. Клетка - слишком сложный
организм и в нем присутствует много механизмов регуляции, изменяющих
наблюдаемый эффект. Даже в случае измерений, проведенных 1п чИго, и
выборе разумной функции, нет уверенности в аддитивности эффектов
признаков. Быть может, правильнее использовать данные об эффектив-
ности функционального сигнала для ранжирования сигналов в порядке
возрастания эффективности и требовать от алгоритмов распознавания не
максимально точного количественного предсказания эффективности, а
правильного порядка следования сигналов в одном ряду (или в несколь-
ких рядах, если исследования были проведены в разных работах).

Если принять предположение об аддитивном вкладе признаков в эф-
фективность, то можно написать ш уравнений (ш - число сайтов с изме-
ренной эффективностью) с п неизвестными, от которых зависит эффек-
тивность сайта. Если число неизвестных меньше числа уравнений, то
Для каждого параметра может быть вычислено значение, наилучшим обра-
5*	131
зом (по критерию наименьших квадратов) приближающее измеренное зка
чение эффективности. Таким образом, выявляются наиболее информатив-
ные позиции сайта и оценивается вклад каждого из признаков в распоз-
навание. Естественно, что применяться такой подход может только к
хорошо исследованным функциональным сигналам, для которых измерены
эффективности более чем ЗК+1 сайтов, где Ы - число позиций мононук-
леотидов, от которых зависит эффективность сайта. Каждой позиции мо-
нонуклеотида соответствует четыре возможных значения, однако вклад в
эффективность одного из них (например, Т) приравнивается нулю и чис-
ло неизвестных связанных с одной позицией сайта оказывается равно 3,
а одно неизвестное слагаемое соответствует эффективности последова-
тельности, состоящей из одних Т. Может оказаться, что эффективность
функционального сигнала зависит не только от мононуклеотидов. В об-
суждаемой схеме можно учесть практически любые признаки, однако с
ростом количества признаков растет и число переменных. Если в качес-
тве признаков взять присутствие динуклеотида, то тогда на одну пози-
цию придется уже не 3, а 15 неизвестных, что потребует еще большего
числа сайтов с измеренными эффективностями.

Количество информации в функциональном сигнале. Подсчет количес-
тва информации, соответствующего определенной позиции функционально-
го сигнала, служит хорошей иллюстрацией к процессу статистического
исследования сигнала и выявлению значимых позиций.

Количественная мера информации, присутствующей в функциональном
сигнале, основанная на статистическом рассмотрении сигналов, была
предложена Шнайдером и др. (ЗсЬпеИег еФ а1., 1986). Количество ин-
формации в одной позиции сигнала для случая одинаковых априорных
частот встречаемости нуклеотидов, равных 1/4, выглядит следующим об-
разом:

Н8ечие„ее(1) = 2 + Е Р„, 1 О^Р», , (4.6)
ь

ПОЛОЖЕНИЕ НА ПОСЛЕДОВАТЕЛЬНОСТИ/ П.Н. ( I >

Рис. 4.5. Информаци-
онное содержание сайта
связывания с рибосомой
(ЗсЬпеНег еФ а1.,
1986)

По оси абсцисс от-
ложен номер позиции
нуклеотида в сайте
(позиция 0 соответст-
вует первому нуклеоти-
ду инициирующего кодо-
на); по оси ординат -
информационное содер-
жание этой позиции в
битах
где РЬ1, как и выше, частота встречаемости нуклеотида Ь в позиции 1.

Позиция сайта, в которой всегда обнаруживается один и тот же нук-
леотид, согласно этой формуле, содержит 2 бит информации, позиция с
равной встречаемостью всех четырех нуклеотидов - 0 бит. Позицион-
но-зависимое количество информации, вычисленное для сайтов связыва-
ния рибосомы, приведено на рис.4.5. Самый большой пик на этом рисун-
ке соответствует инициирующему кодону, меньшего размера пик вблизи
-10 - области Шайна - Дальгарно.

Просуммировав информацию по всем позициям сайта, можно оценить
общее количество информации, которое содержит функциональный сигнал,
и ожидаемую частоту встречаемости сигнала в случайной последователь-
ности. Как это ни удивительно, наблюдаемые частоты встречаемости
функциональных сигналов в геноме для большинства сигналов оказывают-
ся близки к ожидаемым теоретически для случайной последовательности
(ЗсКпе1<1ег е1 а1., 1986).

4.5. МЕТОДЫ ДИСКРИМИНАНТНОГО АНАЛИЗА И РАСПОЗНАВАНИЯ ОБРАЗОВ

Объекты и их признаки- Некоторые хорошо разработанные методы дис-
криминантного анализа и распознавания образов были применены для ис-
следования генетических сигналов. Дискриминантный анализ призван
разделять на заданные группы объекты с известными признаками. Приз-
накам можно приписать некоторые значения, зависящие от объекта. Так,
если признаком является цвет, то он может быть зеленым, желтым и
т.д.; если при распознавании объекта учитывать его размеры, то зна-
чения этого признака будут укладываться в определенный диапазон дей-
ствительных положительных чисел. Таким образом, мы можем каждый объ-
ект представить в виде вектора, т.е. набора величин (признаков),
принимающих некоторые значения.

Важным частным случаем является разделение объектов на две груп-
пы. Например, если в качестве объектов рассматривать фрагменты нук-
леотидной последовательности, то в первую группу могут входить фраг-
менты, выполняющие определенную функцию (сайты), а во вторую - заве-
домо не являющиеся сайтами (несайты). Именно эту задачу разделения
Двух групп объектов мы и будем рассматривать в дальнейшем.

Дискриминантный анализ имеет наглядную геометрическую интерпрета-
цию. Построим пространство с координатными осями, по которым откла-
дываются значения соответствующих им признаков. Это пространство об-
ладает размерностью, равной количеству признаков. Каждая точка этого
пространства соответствует некоторому объекту и, наоборот, любому
объекту можно поставить в соответствие точку с координатами, равными
значениям признаков данного объекта. Разделить два класса объектов
означает провести между ними некоторую поверхность.
На рис. 4.6 изображено двумерное пространство признаков, в кото-
ром удалось разделить прямой два множества объектов. Когда мы имеем
дело с гораздо большим набором признаков, соответственно увеличива-
ется размерность пространства и множества разделяются не прямой ли-
нией, а гиперплоскостью. На рис. 4.7, а) приведена одна из ситуаций,
когда не удается разделить множества одной гиперплоскостью. Впрочем,
относительное положение объектов может стать совершенно иным, если
изменить набор используемых признаков, т.е. перейти в другое прост-
ранство. Выбор пространства, в котором множества разделяются наилуч-
шим образом, тоже входит в круг задач дискриминантного анализа.

Для изложения дискриминантного анализа как метода распознавания
функциональных сигналов далее будем обозначать:

множество объектов первой группы (сайты) - X;

множество объектов второй группы (несайты) - У;

]-й элемент первого множества х3;

значение 1-го признака у объекта х3 - х<;

аналогично для второго множества - у1, у\;

число признаков - п;

число значений 1-го признака - к,;

число объектов первой группы в обучающей выборке (сайты) - 11;

число объектов второй группы в обучающей выборке (несайты) - 12;
общее число объектов - 1=1

Важно помнить, что объекты представляют собой векторные величины.

Как превратить последовательность в вектор. Чтобы воспользовать-
ся методами дискриминантного анализа при работе с нуклеотидными пос-
ледовательностями, мы должны преобразовать каждую последовательность
в точку (вектор в пространстве признаков). Ранее мы видели, что
признаками могут быть нуклеотиды на определенных позициях, расстоя-
ние между блоками нуклеотидов, энергия вторичной структуры, А-Т сос-
тав и т.д. Каждый признак может принимать значение из некоторого
спектра: позиция (нуклеотид) на последовательности ДНК, например,
обладает дискретным спектром значений - А, С, С, Т; энергия вторич-

Р и с. 4.6. Два множества
объектов (X и У) разделены
прямой в двумерном простран-
стве признаков. С увеличением
количества признаков плос-
кость превращается в
пространство с размерностью,
равной	числу признаков, а

прямая	- в разделяющую

гиперплоскость
ной структуры имеет непрерывный спектр вещественных чисел; расстоя-
ние между блоками нуклеотидов измеряется целыми числами. Значения
признаков можно всегда сделать конечными и дискретными, разбив весь
спектр возможных значений на интервалы.

Если каждому признаку из интересующего нас набора поставить в со-
ответствие ось координат, по которой откладывать его значение, то мы
получим пространство признаков, а каждой последовательности будет
соответствовать точка и вектор, образованный ее координатами.

Рассмотрим в качестве примера сигнал, в котором должны присутст-
вовать или динуклеотид АА или динуклеотид АС; все остальные динукле-
отиды в последовательности не являются сайтами. Очевидно, что в ка-
честве признаков здесь следует выбрать две соседние позиции в после-
довательности. Мы можем утверждать, что встретили наш сигнал, если
на 1-й позиции последовательности будет стоять нуклеотид А, а на
(1+1)-й А или С. Пространство признаков представляется здесь плос-
костью, образованной двумя координатными осями (рис. 4.7,а). Положе-
ние сайтов изменится, если по другому упорядочить нуклеотиды. Так,
например, можно добиться разделения, если ввести порядок нуклеотидов
СТСА (рис. 4.7,б) влиять на возможность разделения. Чтобы избежать
этой неоднозначности, обычно предпочитают описывать объект бинарным
набором признаков. Бинарный признак - это признак, который может
принимать только два значения: 0 и 1. Любой набор из п дискретных
признаков, принимающих к1 значений (1=1,...,п), можно просто заме-
нить эквивалентным набором из К бинарных признаков, И=Ек1. В нашем
примере бинарные	признаки будут говорить о наличии (Х;=1) или

отсутствии (х^О)	конкретного нуклеотида в данной позиции.

Первые	четыре признака отвечают за первую позицию сайта, вторые

четыре	- за вторую и т.д. Первый признак каждой четверки

Рис. 4.7. Изображение сайтов АА и АС на плоскости признаков

По горизонтальной оси отложено значение первой позиции динукле
тида; по вертикальной - второй; а - отделить прямой множество сайто
от несайтов невозможно; б - другой порядок нуклеотидов сделал разде-
ление возможным
соответствует нуклеотиду А, второй - С, третий -Си четвертый - Т.
Сайт АА теперь заменяется вектором х=(1000 1000), а АС - (1000
0010).

Что значит разделить множества ? Будем говорить, что множества X
и V разделимы, если найдется такой разделяющий вектор I и действи
тельное число К, что для любого х и для любого у выполняются соотно
шения: (х-?)>К, (у?)<К. Обозначим скалярное произведение
(х-1-?) через у3х и будем называть число V весовой функцией
объекта.

В нашем примере разделяющим вектором будет, например, вектор
!=(!□□□ 1010). В самом деле, для сайтов х’=АА и х2=АС ух=2, а
для всех остальных динуклеотидов Vх <2. В качестве В можно взять
любое число от 1 до 2.

Разделяющий вектор направлен перпендикулярно разделяющей гиперг
лоскости и определяет ее ориентацию в пространстве признаков, а гра-
ничное число В задает ее положение. Любая точка 2 разделяющей гипер-
плоскости удовлетворяет уравнению

2-Г=В.

Рассмотренные ранее статистические методы тоже позволяли получать
координаты разделяющего вектора - мы называли их элементами статис-
тической матрицы. Разделение, правда, было обычно нестрогим: некото-
рые объекты классифицировались ошибочно. Это, конечно, может счи-
таться недостатком, но следует обратить внимание на опасность, поде
терегающую нас при стремлении избавиться от ошибок при обучении. Де-
ло в том, что при составлении обучающей выборки может случайно прои-
зойти ошибка и тогда наше благое намерение безошибочно разделить все
объекты, может привести к искаженной модели сайта. А при сложных ме-
тодиках работы с нуклеиновыми кислотами, требующих учета множества
косвенных факторов и проведения многостадийных реакций, наивно расс-
читывать на получение большого количества информации, достоверной не
все 100%. Поэтому полезно познакомиться с методами дискриминантного
анализа, разделяющими обучающую выборку оптимальным (в некотором
смысле) образом, но допускающими небольшое количество ошибок.

Оптимизация разделения. Наглядным и привлекательным методом оп-
тимизации разделения объектов воспользовался Иида для распознавания
5' сигналов сплайсинга (Ийа, 1987). Метод не требует полного разде-
ления множеств X и V, допуская небольшое перекрытие распределений
Vх и Vх. Чтобы найти разделяющий вектор Г, запишем несложные
статистические соотношения.

Среднее значение V внутри каждого множества и по всей обучающей
выборке вычисляется обычным способом:
< Vх > = — Е V х ; <чу> = — Е ч,у ;

1Х 1=1 1 1У 1=1

<У>=	( 1<Ух>+1„<Уу>).

1

Разброс значений V по всей обучающей выборке характеризуется диспер-
сией

1	Дх	1у

П= - ( Е (у1х-<ух>)2 + Е (у1у-<уу> )2).

1	1=1	1=1

Отличие средних значений весовой функции элементов разных групп
("межгрупповая" дисперсия) можно описать величиной

1

Бв= - (1Х(<ух>-<у>)2+1у( <уу>-<у>)2).

1

В качестве критерия оптимальности разделения Иида взял отношение
Бв/0. Разделяющий вектор Г вычисляется из условия достижения мак-
симума отношения межгрупповой дисперсии к дисперсии весовой функции
по всему множеству. Действительно, возрастание Вв свидетельствует
об увеличении расстояния между центрами множеств, а значит и об
улучшении разделения. Дисперсия С в знаменателе служит объединяющим
фактором, не позволяющим элементам обучающей выборки "разбежаться"
по всему пространству. Мы не будем останавливаться на технике вычис-
ления разделяющего вектора по такому критерию, а рассмотрим основные
результаты этого подхода.

Обучающая выборка была составлена из 155 5' сигнальных последова-
тельностей сплайсинга генов млекопитающих (1х=155) и 1596 фрагмен-
тов гена бета-глобина, не являющихся 5' сайтами сплайсинга
(1У=1596). В качестве признаков были выбраны девять нуклеотидов:
три на 3' конце экзона и шесть на 5' конце интрона. Таким образом,
количество признаков п=9, а число значений каждого признака одинако-
во и равно 4. Размерность бинарного пространства признаков и соот-
ветственно число неизвестных координат разделяющего вектора №=36.

После оптимизации разделения были построены гистограммы распреде-
ления весовой функции для каждой группы последовательностей (рис.
4.8). Выбрав в качестве порогового значения число К, минимизирущее
число ошибок, довольно просто удалось подсчитать вероятность ошибоч-
ной классификации на обучающей выборке. Оказалось, что если для пос-
ледовательности величина у>П, то с вероятностью 98,2% ее можно счи-
тать 5' сайтом сплайсинга; а если у<К, то с такой же степенью уве-
ренности ее следует отнести к несайтам. Ошибочно классифицированные
участки ДНК стали предметом всевозможных гипотез и спекуляций. К со-
жалению, ничего не сообщается о проверке результатов на выборке не
участвующих в обучении последовательностей, что ставит под сомнение
притягательное значение числа 98,2% - процента случаев правильной
классификации.

Рис. 4.8. Нормированное распределение весовой функции V/ для 5'
сайтов сплайсинга (вверху) и для выборки несайтов (внизу). Отмечены
средние значения функции и граничное число К

Персептрон. Для построения разделяющего вектора Г в ряде работ
был использован известный метод обучения распознаванию образов -
персептрон. Персептрон редко приводил к хорошим результатам, и его
популярность во многом основана на естественности и простоте. По
своей сути метод похож на процесс обучения человека: программе пока-
зывают по очереди объекты, принадлежащие двум разным классам; если
она правильно классифицирует предъявленный объект, ей показывают
следующий; если же программа ошибается, ее поправляют, изменяя раз-
деляющий вектор. Так происходит до тех пор, пока программа не нау-
чится правильно распознавать все объекты.

Пусть - значение разделяющего вектора до предъявления объ-
екта у1+1. Следующее значение вычисляем по правилу
^+Т1Н’ если (уг + 1» И У1 + 1еХ;

^♦1= {Гуи1' если (у<ч'М>К и
Гг в любом другом случае.

Тем самым мы увеличиваем характерные для сайтов и уменьшаем ти-
пичные для несайтов координаты разделяющего вектора. Одну и ту же
обучающую выборку можно прогонять через алгоритм много раз, до уста-
новления подходящих количественных соотношений между координатами
вектора Г. Обычно полагают К=0 и начальное значение разделяющего
вектора Го=0.

Известно, что если разделяющий вектор существует (т.е. множества
разделимы), то алгоритм персептрон позволяет найти его за конечное
число шагов (Вапник, 1971).

Для анализа нуклеотидных последовательностей впервые использовали
персептрон Стормо с соавт. (ЗЪогшо е! а1., 1982,Ь). Они пытались на-
учиться распознавать места инициации трансляции на обучающей выборке
из 124 сайтов и примерно 78 тыс. несайтов. Признаками служили 101
позиция последовательности РНК: от -60 до +40 рибонуклеотида, считая
от начала трансляции. Большое количество бинарных признаков (И=404)
позволило довольно быстро отыскать разделяющий вектор.

Персептрон безошибочно разделяет обучающую выборку и проверять
его надо только на объектах, не принимавших участия в обучении. В
работе Стормо и др. для контроля взяли 10 последовательностей тРНК,
со средней длиною около 1000 оснований. На контрольной выборке были
неправильно классифицированы три сайта и пять несайтов.

Авторы пробовали уменьшить огромный набор признаков, что не улуч-
шило качества обучения, а снижение числа рассматриваемых нуклеотидов
до 51 делало разделение обучающей выборки невозможным. Кажется сом-
нительным влияние столь удаленных оснований на инициацию трансляции,
и причину неудач следует объяснить неадекватным выбором признаков. В
частности, следует учитывать вторичную структуру РНК и вариабель-
ность расстояния между блоками существенных рибонуклеотидов.

Модификация персептрона, учитывающая некоторые особенности рас-
познавания сайтов, была применена к промоторам Е.соИ (Александров,
Миронов, 1987). Как мы уже отмечали, близлежащие сайты могут оказы-
вать заметное влияние друг на друга, а значит и эффективность (сила)
сайта может значительно варьировать в зависимости от окружающих его
последовательностей. Поэтому у нас нет гарантии, что промотор, с ко-
торого идет транскрипция в каком-то одном окружении, будет работать
в другом окружении, например рядом с гораздо более сильным промото-
ром. Эти соображения заставляют нас отказаться от граничного числа
В, которое служило критерием принадлежности исследуемой последова-
тельности к множеству сайтов.

Единственный постулат, который можно достаточно уверенно положить
в основу обучения, заключается в том, что промотор, с которого идет
транскрипция, является оптимальным среди всех возможных близлежащих
промотороподобных последовательностей. Тем самым мы допускаем, что у
экспериментально определенных промоторов вес V может быть меньше,
чем у нефункционирующих фрагментов последовательности, расположенных
недалеко от другого промотора. Расстояние, на котором взаимодействие
промоторов существенно, можно оценить размером покрываемой РНК-поли-
меразой последовательности ДНК, т.е. 100 нуклеотидов.

Вот почему пришлось отказаться от типичной для теории распознава-
ния образов постановки задачи - разделения фиксированного множестве-
векторов и поставить целью обучения совпадение участка последова -
тельности, дающего наибольшее значение весовой функции V с экспери-
ментально найденным промотором. Абсолютное значение V теперь не иг-
рает решающей рели в распознавании. Главное, чтобы величина V у ре
ального промотора была больше, чем вес любой другой последователь-
ности на исследуемом фрагменте ДНК.

Еще одно изменение стандартного алгоритма связано с невозмож-
ностью точной идентификации нуклеотидов, образующих промотор. Экспе-
риментально можно точно определить, с какого места начинается синтез
РНК, но какие именно нуклеотиды образуют -10 и -35 блоки остается
реизвестным. Эти блоки могут находиться на разном удалениии от точки
инициации транскрипции, расстояние между ними также варьирует в зна-
чительных пределах. Поэтому одной экспериментально определенной точ-
ке начала транскрипции могут соответствовать несколько положений
признаков промотора. Задача выбора оптимального положения признаков
относится к общей проблеме множественного выравнивания (раздел 4.6),
окончательного решения которой еще не найдено.

С учетом сделанных замечаний алгоритм персептрон работает следую-
щим образом.

1.	Если при предъявлении последовательности программа выбирает
правильное, т.е. непротиворечащее экспериментальным данным положение
структуры, разделяющий вектор не изменяется.

2.	Если же программа ошибется, выбрав слишком удаленное от старта
транскрипции положение блоков, вектор Г изменяется и становится рав-
ным	У,,! +х*и где у - вектор, соответствующий выбранному

положению структуры, ах*- оптимальный из всех правильных векторов.
Тем самым программа не только наказывается за ошибки, но и
стимулируется к распознаванию правильных положений.

В качестве признаков промотора были взяты -10 и -35 области дли-
ной соответственно 15 и 10 нуклеотидов, а также +1 область, состав-
ленная из трех динуклеотидов и расстояния между ними - всего получи-
лось 177 бинарных признаков. С таким набором признаков удалось ре-
шить поставленную задачу на обучающей выборке из 80 последователь-
ностей, содержащих промотор.
Для контроля был проведен поиск промоторов на последовательности
фага М, который дал довольно плохие результаты: из 35 лучших струк-
тур только четыре соответствовали реальным промоторам. Неудача, воз-
можно, объясняется общими недостатками, присущими алгоритму персепт-
рон и неоптимальным выбором признаков. Чтобы избавиться от этих не-
достатков, попытаемся использовать другой алгоритм распознавания об-
разов и другой способ формирования оптимального набора признаков.

Обобщенный портрет. Итак, применение довольно простого алгоритма
персептрон не дало удовлетворительных результатов; популярными ста-
тистическими методами нельзя получить однозначный ответ на вопрос о
существовании разделяющего вектора. Больше возможностей дает алго-
ритм обобщенный портрет, детально разработанный Вапником и др.
(1984). Для решения наших задач этот алгоритм потребовал лишь не-
больших изменений.

Положим граничное число В равным единице, что нисколько не изме-
нит задачу распознавания и нужно только для нормировки условий раз-
деления, которые теперь запишутся так:

(Гх)>=1, (4.7)
(Гу)<=к, где к<1.

Ясно, что может существовать несколько векторов Г, удовлетворяю-
щих условию (4.7). Геометрическая интерпретация этой неоднозначности
сводится к наличию нескольких разделяющих плоскостей. Как видно из
рис. 4.9, от положения плоскостей зависит расстояние г между множес-
твами. Обобщенным портретом называют минимальный по модулю из всех
возможных разделяющих векторов I, который обеспечивает максимум рас-
стояния г.

При решении задачи распознавания сайтов для каждого элемента
х1 е X, будем строить свое множество У1, в которое входят все векто-
ры последовательностей обучающей выборки, за исключением некоторой
окрестности остальных (кроме X;) сайтов, что обусловлено возможным
взаимным влиянием функциональных участков молекулы ДНК. Тем самым мы
формируем множество 2 из векторов х1 и всех элементов соответству-
ющего множества У,. Множество 2 значительно расширяется, если мы
обладаем информацией о качественном соотношении эффективностей сай-
тов.

Описанный алгоритм был использован для построения разделяющего
вектора на множестве промоторов Е.соИ. Обучающая выборка состояла
из 80 последовательностей длиной - 60 нуклеотидов с известной точкой
старта транскрипции. Модель промотора первоначально включала в себя
Два блока по шесть нуклеотидов (блоки Прибноу и Гильберта), разде-
ленных 15-21 основаниями. Начало транскрипции могло отстоять от
Прибноу блока на четыре-восемь нуклеотидов, т.е. одной точке старта
транскрипции соответствует (8-4+1)•(21-15+1)=35 разных положений
промоторной модели. Выбор правильного положения осуществлялся при
помощи статистической матрицы узнавания Муллигана (МиШ§ап е! а1.,
1984). Множество У, формировалось только из 1-й последовательности
и включало в себя все другие положения промоторной структуры на пос-
ледовательности.

В результате работы программы разделение оказалось невозможным.
Это означает, что часто используемая классическая структура промото-
ра (два блока по шесть нуклеотидов и вариабельное расстояние между
ними) принципиально недостаточна для распознавания.

Чтобы решить задачу распознавания, необходимо было ввести новые
признаки, например увеличить -10 и -35 области. Размер этих блоков
был увеличен соответственно до одиннадцати и десяти нуклеотидов.
Нетрудно подсчитать, что с учетом семи возможных значений расстояния
между блоками число бинарных признаков стало равным
Н=4*11+4,10+7=91. В таком пространстве была найдена разделяющая
гиперплоскость.

Из только что сказанного видно, что признаки были выбраны доста-
точно произвольно; можно было бы образовать другое похожее простран-
ство признаков, например еще больше расширить -10 и -35 области и
найти другой обобщенный портрет промотора. Было бы интересно устано-
вить минимальный набор признаков, позволяющих построить разделяющий
вектор и посмотреть, как меняется качество обучения при изменении
пространства признаков.

Для оценки качества обучения можно пользоваться как теоретической
оценкой, так и проверкой разделяющего вектора на контрольной выбор-
ке. В целях экономии машинного времени удобнее вычислять качество
разделения при помощи теоретической формулы. По этой формуле разде-
ляющий вектор считается более надежным, если он получен при помощи
меньшего количества признаков, большей обучающей выборки и обеспечи-
вает большее расстояние между разделяемыми множествами.

Определить оптимальное (с наилучшим качеством разделения) или ми-

Р и с. 4.9. Разделение
множеств несколькими способа-
ми: разделяющие векторы и
соответствующие им гиперплос-
кости могут заметно отличать-
ся

Метод "обобщенный порт-
рет" строит вектор Го,
максимизирующий расстояние г
между множествами, персептрон
выдает первый попавшийся
разделяющий вектор Г
нимальное (с минимальной размерностью, позволяющей разделить множес-
тва) пространство признаков простым перебором не представляется воз-
можным из-за огромного количества комбинаций. Пришлось отказаться от
поиска глобального оптимума и использовать пошаговую процедуру, при-
водящую к локальному оптимуму. Выбрасывая из первоначального набора
по одному наименее информативному признаку, можно получить минималь-
ное пространство, дальнейшее уменьшение которого сделает невозможным
распознавание на обучающей выборке.

После проведенной таким образом минимизации количества признаков,
используемых при распознавании промоторов Е.соИ, выяснилось, что
для разделения обучающей выборки достаточно учитывать всего 12 пози-
ций в расширенных блоках Прибноу и Гильберта. Таким образом, коли-
чество признаков по сравнению с каноническим набором (оба блока по
шесть нуклеотидов), который не позволил получить разделяющего векто-
ра, не увеличилось. Позиции, учитываемые минимальным набором призна-
ков, конечно, отличаются от позиций канонических блоков Прибноу и
Гильберта, хотя и включают в себя некоторые наиболее важные из них.

Однако не стоит стремиться к сильному сокращению признаков, так
как, разделяя стопроцентно обучающие множества, минимальный набор
плохо работает на контрольной выборке. Очевидными недостатками обла-
дает и слишком большой набор признаков - в него включаются незначи-
мые признаки, делающие распознавание в значительной степени случай-
ным. Существует некоторое оптимальное пространство признаков, кото-
рое можно найти, осуществляя пошаговую процедуру минимизации до тех
пор, пока теоретическая оценка качества обучения не достигнет макси-
мума.

Проверка алгоритма осуществлялась разбиением всей выборки промо-
торов на две группы: обучающую и контрольную, в каждой по 40 после-
довательностей. После того, как разделяющий вектор был построен на
первой группе, с его помощью искали промоторы на второй группе пос-
ледовательностей. Промотор считался найденным правильно, если блок
Прибноу ТАТААТ находился на расстоянии четырех-восьми оснований от
первого транскрибируемого нуклеотида. В оптимальном пространстве
признаков алгоритм обобщенный портрет ошибся 4 раза, показав нес-
колько лучший результат, чем статистическая матрица Муллигана
(Ми111§ап еФ а1., 1984), причем возможности алгоритма обобщенный
портрет для анализа нуклеотидных последовательностей еще не исчерпа-
ны.

4.6. МНОЖЕСТВЕННОЕ ВЫРАВНИВАНИЕ

Рассматривая выше обучающие выборки, мы считали,что последова-
тельности уже выровнены и похожие участки расположены друг под дру-
гом; нам оставалось только подсчитать количество нуклеотидов в каж-
дой позиции сайта. Оказывается, однако, что выровнять несколько пос-
ледовательностей - очень сложная и неоднозначно решаемая проблема.
Если мы будем отталкиваться от разных вариантов выравниваний, то,
возможно, будем получать отличающиеся решающие правила. Эксперимен-
тальными методами, как правило, не удается выявить более предпочти-
тельный вариант выравнивания. Перебор же всех возможных варианте-:
потребует очень много времени. Так, если предположить, что блоки -1С
и -35 в промоторах Е.соИ могут быть разделены 15-21 нуклеотидами, а
расстояние от точки транскрипции до блока -10 изменяется в пределах
четырех-восьми нуклеотидов, то число возможных положений этой струк-
туры на последовательности с известной точкой начала транскрипции
будет равно 35, а число разных вариантов выравниваний для выборки иг-
200 промоторов достигнет 352°°. При этом для каждого варианта нуж-
но построить матрицу и определить качество распознавания - критерии
оптимальности выравнивания. Ясно, что нужно придумать какой-то более
быстрый способ нахождения оптимального выравнивания.

Как стало ясно из первой главы, задачу выравнивания двух последе
вательностей можно считать в основном решенной. Этого нельзя пока
сказать о задаче выравнивания большего числа последовательностей.
Предложено немало алгоритмов для решения проблемы множественного вы-
равнивания, но ни один из них нельзя признать достаточно эффектив-
ным. Существуют в основном три подхода: первый представляет собой
обобщение алгоритма Нидльмана - Вунша (ИеесИетап, ИПшзсЬ, 1970) на
случай трех и более последовательностей; основная идея другого мето-
да заключается в поиске общих участков в выравниваемых последова-
тельностях с их дальнейшим упорядочиванием; в третьем случае множес
твенное выравнивание сводится к построению консенсуса, с которым
производится попарное выравнивание всех последовательностей. Все эти
подходы практически используются в разных случаях. Оптимальным можно
считать выравнивание, полученное при помощи алгоритма Нидльмана
Вунша, но он требует колоссального объема памяти и очень много ма-
шинного времени. Алгоритмы второго типа не дают гарантии оптималь-
ности выравнивания, но достаточно быстры и являются сейчас самыми
популярными при работе с большим числом последовательностей. И, на-
конец, методы построения консенсусов представляются наиболее общим
решением проблемы. Именно в этих алгоритмах отчетливо видна связ-
между одновременным выравниванием нескольких последовательностей и
распознаванием функциональных сайтов.

Динамическое программирование. Алгоритм Нидльмана - Вунша вырав
нивания двух последовательностей "от границы до границы" был приме-
нен Мурата (МпгаФа еФ а1., 1985) для выравнивания трех белковых пос-
ледовательностей. Такое обобщение совсем не изменило сути алгоритма.
Практическая реализация этого алгоритма требует большого объема па-
144
пяти, пропорционального №, где И - среднее геометрическое ш,п и
р. Время счета тоже пропорционально №. Сравнение трех белков с
11=100 требует 1МБ памяти и 80 с счета на компьютере УАХ-11/780.
Из-за огромных требований к памяти и быстродействию компьютеров
практически невозможно использовать этот алгоритм для четырех и
большего числа последовательностей. Поэтому были предложены эвристи-
ческие алгоритмы, значительно экономящие машинное время и память, но
не гарантирующие построение оптимального в матричном смысле выравни-
вания.

Джонсон и Дулиттл (ДоЬпзоп, БооИШе, 1986) предложили сканиро-
вать последовательности окном ширины V и динамически выравнивать
между собой лишь небольшие фрагменты в окнах. Объем требуемой памяти
теперь не зависит от длины последовательностей и определяется пара-
метром V. Время счета линейно зависит от длины и экспоненциально от
числа последовательностей. Алгоритм был проверен на трех, четырех, и
пяти белковых последовательностях длиной - 200 аминокислот и занял
соответственно 55 с, 18 и 263 мин счета на компьютере УАХ-11/780.
Когда последовательности очень похожи, преимущества этого метода не
вызывают сомнений. Однако, если они различаются довольно сильно и
для выравнивания необходимо делать протяженные вставки, трудно ожи-
дать удовлетворительных результатов.

Быстрое выравнивание. В одной из своих работ, посвященных проб-
леме множественного выравнивания, признанный специалист в области
компьютерной генетики М.С.Уотерман (ИаФегшап, 1986) отметил, что для
практического использования при выравнивании более трех последова-
тельностей годится только лишь метод Собела - Мартинеца (5оЬе1,
Маг11пег, 1986). В этой же статье он приводит еще один практический
алгоритм. Но сначала познакомимся с идеями Собела и Мартинеца.

Алгоритм основан на предварительном поиске общих сегментов с пос-
ледующим их упорядочиванием так, чтобы максимизировать некоторую
функцию или вес выравнивания. Под сегментом будем понимать подпосле-
довательность из нуклеотидов. Назовем общим сегментом или регионом
сегмент, встречающийся во всех выравниваемых последовательностях.
Пусть, например, сегмент АССТС встретился в позиции 12 первой после-
довательности и в позициях 45 и 100 второй последовательности. В
этом случае мы имеем дело с двумя общими сегментами, порожденными
АССТС. Один соответствует паре позиций (12,45), а другой - (12,100).
Если к тому же АССТС присутствует в позициях 20 и 50 третьей после-
довательности, мы получим уже четыре общих сегмента, соответствующих
тройкам позиций (12,45,20), (12,45,50), (12,100,20) и (12,100,50).

Очевидно, что число общих сегментов растет с увеличением суммар-
ной длины последовательностей. Соответственно возрастает и вычисли-
тельная сложность алгоритма. Этот комбинаторный взрыв можно предотв-
ратить, если увеличить минимальную длину общего сегмента, т.е. ис-
кать только крупные регионы. Поиск регионов осуществляется описанным
в первой главе методом (МагНпег, 1983).

Далее, будем считать, что регион X предшествует региону X, если
все позиции X меньше соответствующих позиций X по крайней мере на
длину региона X. Выравнивание мы теперь заменяем набором упорядочен-
ных регионов и нашей целью становится отыскание оптимального набора
регионов Х,,Х2,..., такого, что Х,<Х2<... Критерием оптимальности
(весом выравнивания) может служить, например, сумма длин регионов,
определяющих выравнивание: чем она больше, тем лучше данное
выравнивание.

Собел и Мартинец предложили использовать-очень простую рекурсив-
ную процедуру поиска такого набора регионов. Пусть у(Х) - вес опти-
мального выравнивания последовательностей от первого нуклеотида до
региона X. Следующим шагом нам надо определить, какой из дальнейших
регионов выгоднее включить в это выравнивание. Предлагается включить
такой регион X, на котором достигается максимум весовой функции у(У)

у(Х) = шах { 1(Х) - а(Х,Х) + у(Х) },

где 1(Х) - длина региона X, а сЦХ,Х) - штраф за пропуски между реги-
онами X и X. Штраф вводится так, чтобы он зависел от суммарной по
всем последовательностям длины вставок между регионами X и У.

К недостаткам алгоритма относятся два жестких требования: точное
совпадение сегментов, образующих регион и обязательное их наличие вс
всех выравниваемых последовательностях. Впрочем, нестрогое совпаде-
ние длинного слова можно представить в виде точных совпадений фраг-
ментов меньшей длины, а второе требование авторы предлагают ослабить
введением еще одного параметра алгоритма - числом последовательнос-
тей, включающих в себя общий сегмент. Например, при выравнивании пя-
ти последовательностей достаточно встретить сегмент в четырех из
них, чтобы он считался общим.

Этот подход значительно развил Уотерман (ЮаФегтап, 1986), естест-
венным образом устранив указанные недостатки. Пусть набор из В пос-
ледовательностей длины И изначально выровнен относительно какой-ни-
будь биологически определенной позиции. Это может быть, к примеру,
точка инициации транскрипции для промоторов или место соединения эк-
зона с интроном для сайтов сплайсинга. Такое выравнивание является,
конечно, приблизительным. Цель алгоритма - выровнить последовательное::
так, чтобы похожие участки были бы расположены друг под другом. В
качестве параметра, определяющего возможное относительное смещение
участков, вводится ширина окна ». Рассмотрим фрагменты последова-
тельности длиной V, начинающиеся с 0+1)-й буквы:
а2,] + 1 а2 , |*2 • * * а2,3чч»’

аК.]*1 ав,4*2 • ’ * ав^чч«‘

Найдем в этих фрагментах слова, совпадающие или близкие к слову
з. Если найденное слово отличается от з в I позициях, будем называть
его 1; соседом. Пусть ч5Л - число строк, в которых наиболее близкое
к V слово является I соседом. При этом обычно ограничиваются значе-
ниями 1=0,1,2. Каждому из 1 соседов приписывается вес 1г. Вычислим
вес слова з в данном окне по формуле

уИ1,^„(з)= 2

Наилучшим словом будет слово з*, удовлетворяющее условию

тах

Теперь упорядочим слова: з,<з2, если слово з, встречается
всегда левее з2 и не пересекается с ним. При этом не обязательно
их присутствие во всех последовательностях. В этих терминах поста-
новка задачи проста: нужно найти слова зи удовлетворяющие условию

тах{ Е ч(зр: з,<з2<... }.

Но, как часто бывает, простота формулировки вовсе не подразумева-
ет простоту решения и достичь поставленной цели за разумное время не
представляется возможным. Тем не менее можно придумать алгоритмы,
позволяющие подойти довольно близко к максимуму.

Для этого предлагается простая рекурсия. Положим V, - максимум
суммы от первой буквы последовательности до 1-й. Тогда
У1=тах{ч .+ч3 + 1 .:	1-^+1<з<1-к), где д - вес наилучшего

консенсусного слова в окне от з+1 до 1, а к - длина слова.
Предложенный алгоритм требует времени пропорционально П»2К и был
проверен на 34 последовательностях, кодирующих 53 РНК (-100
нуклеотидов). Единственным ограничением алгоритма является ширина
окна V, определяющая максимальное расстояние между гомологичными
участками.

Использование консенсуса. Интересными представляются алгоритмы,
основанные на построении пра-последовательности, или консенсуса. Эти
два термина означают одно и то же, хотя и употребляются в разных
контекстах: пра-последовательность имеет эволюционный оттенок, а
Консенсус - функциональный. Именно в этих алгоритмах нашло свое от-
ражение тесное переплетение двух задач компьютерной генетики - рас-
познавания сайтов и множественного выравнивания.

Первым такой подход разработал Санкофф (ЗапкоГГ, 1975) и применил
его для выравнивания 58-рибссомальных РНК. Кроме первичной структуры
молекул в качестве исходной информации использовалось филогенетичес-
кое дерево организмов, из которых были выделены 53-РНК. Однако зна-
ние этого дерева а рг1ог! не является обязательным, так как оно мо-
жет быть восстанавлено по последовательностям введением метрики при
попарном выравнивании. Рассмотрим в качестве примера дерево для де-
вяти последовательностей на рис. 4.10,а. Каждая из висячих вершин
1-9 соответствует реальной последовательности, а каждой внутренней
вершине ставится в соответствие некая пра-последовательность. Внача-
ле все пра-последовательности полагаются равными любой из близлежа-
щих реальных последовательностей. Для полутени" новых пра-последова-
дельностей использовалась следующая итеративная процедура: методами
динамического программирования, например алгоритмом Мурата, выравни-
ваются три последовательности, одна из которых является предшествую-
щей версией пра-последовательности, а две другие соеденены с ней
ребрами дерева. По результатам этого выравнивания строится новая
пра-последовательность. Итеративная процедура осуществляется ст ви-
сячих вершин к корню дерева. Общий ход итеративной процедуры предс-
тавлен на рис. 4.11,а-г. Когда все пра-последовательности будут
скорректированы, процесс повторяется в обратном порядке: вычисления
проводятся в направлении г-а. Как только полный итеративный цикл
пройдет в двух направлениях без изменения пра-последовательностей,
алгоритм останавливается. Во всех проведенных испытаниях сходимость
наступала до пятого цикла. Авторы отмечают, что алгоритм не гаранти-
рует достижения глобального оптимума выравнивания.

Похожие алгоритмы, использующие итеративные процедуры для вывода

Рис. 4.10. Множественное выравнивание с помощью филогенетического
дерева

А-Г - этапы реализации алгоритма
консенсусной последовательности, были независимо предложены Уотерма-
ном с соавт. (ИаФегтап еЪ а1., 1984) и Бэйнсом (Ва1пз, 1986). Уотер-
ман применил интересную геометрическую интерпретацию проблемы вырав-
нивания, введя метрику в пространстве последовательностей. Чтобы вы-
числить расстояние Б(а,Ь) между двумя последовательностями
а=а1а2...ап и Ъ“Ь1Ь2...ЬП, применяется стандартная рекурсивная про-
цедура динамического программирования:

Бн = т1п{Б1.1^+а(а1,о),Б1.1].1+а(а1,Ь^, Б. .^+<1(0,6.)}

с начальными условиями:

БоГБ(О,Ь1...Ь}); Б1О=Б(а1...а1,О); Боо=0,

где о соответствует вставке; 0=оо...; а сЦа^ьр - расстояние
между буквами последовательности.

Особенностью применяемого алгоритма является введение понятия ус-
редненной последовательности, каждой позиции которой соответствует
не конкретная буква, а вектор (р0,р1,р2...), где р,>=0 и Е р,=1
(для нуклеотидных последовательностей 1<4, для белков 1<20). Из
любых выровненных последовательностей можно вывести усредненную,
если интерпретировать р( как частоту встречи 1-й буквы алфавита в
данной позиции, а р0 - вставки V. Расстояние между двумя буквами
усредненных последовательностей а1=(р0р1р2...) и Ь,=(ч0д1ч2...)
равно

а(а,,ьр = (Е чк | Рк-чк |{)1/1,
к

где чк - вес, а Г>1 - параметр.

Кроме метрики в пространстве вводится операция сложения последо-
вательностей:	с(1)=1 а+(1-1)Ъ, где ^(1)=! а1+(1-1)Ь1. Нужно

Рис. 4.11. Гео-
метрическое вырав-
нивание последова-
тельностей
помнить, что а1,Ь1,с1 - векторы. Параметр 1 характеризует
относительную значимость усредненной последовательности а: чем
больше последовательностей принимало участие в формировании а, тем
больше 1.

Теперь представим выравниваемые последовательности в виде точек
(рис. 4.11). Усредненная последовательность (консенсус) будет совпа-
дать с центром тяжести первоначальных точек. Последовательность кон-
сенсуса определяется итерационным алгоритмом, каждый шаг которого
заключается в вычислении последовательностей, лежащих на середине
отрезков, соединяющих первоначальные точки а1, а2 и а3:

Ь,=(а1+а2)/2; Ь2=(а1+а2)/2; Ь3=(а2+а3)/2.

Далее в качестве первоначальных точек рассматриваем
Ь',Ь2,Ь3 и снова вычисляем координаты середин сторон треугольника.
Продолжаем процесс до тех пор, пока сумма расстояний между вновь
образованными точками не станет меньше наперед заданного числа е.
Сходимость алгоритма очень медленная и время работы растет
экспоненциально с ростом числа последовательностей. Метрика
последовательностей не является евклидовой, и поэтому нельзя
применить известные эффективные способы поиска центра тяжести
точек.	Быть может, при детальном изучении Уотермановской или

подобных метрик удастся предложить более совершенный метод
геометрирческого выравнивания последовательностей.

Эвристический алгоритм Бзйнса (Ва1пз, 1986) проиллюстрирован на
1) Исходные последовательности:

1.	ТССТТТССТСА

2.	ССТТССТА (начальный консенсус)

3.	ССТТСССТСА

2)	Попарное выравнивание:

консенсус	-СС-ТТССТ-А	ССТТССТА	ССТТС-СТ-А

1.	ТССТТТССТСА	2.	ССТТССТА 3.	ССТТСССТСА

3)	Введение вставок во все последовательности:

консенсус	-СС-ТТС-СТ-А	-СС-ТТС-СТ-А	-СС-ТТС-СТ-А

1.	ТССТТТС-СТСА	2. -СС-ТТС-СТ-А	3. -СС-ТТСССТСА

4)	Компиляция полученных последовательностей:
консенсус -СС-ТТС-СТ-А

1.	ТССТТТС-СТСА

2.	-СС-ТТС-СТ-А

3.	-СС-ТТСССТСА

5)	Новый консенсус:

-СС-ТТСССТСА

Рис. 4.12. Иллюстрация алгоритма Бзйнса
рис. 4.12. В первом приближении консенсусом объявляется любая из
последовательностей. Производится попарное выравнивание каждой пос-
ледовательности с консенсусом. Все вставки в консенсусе фиксируются
и таким образом вводятся во все остальные последовательности. После
этого из компиляции выровненных таким образоми последовательностей
выводится новый консенсус и цикл повторяется. Если консенсус не из-
менился после прохождения цикла, алгоритм заканчивается. Брзйнс от-
мечает, что алгоритм может зациклиться; но в программе есть против
этого защита, предусматривающая наличие не одного, а нескольких ко-
нечных консенсусов. Более серьезные трудности возникают, если алго-
ритм просто не сходится. Тем не менее алгоритмом можно пользоваться
для одновременого выравнивания нескольких десятков похожих последо-
вательностей длиной до 1000 нуклеотидов.

4.7.	ПРОВЕРКА ПРОГРАММ РАСПОЗНАВАНИЯ

Разберем проблемы, связанные с тестированием программ распознава-
ния. Если для решения одной задачи имеется несколько различных алго-
ритмов, возникает желание выбрать из них наилучший. По нашему мне-
нию, не существует универсального критерия качества, и сравнение
различных алгоритмов необходимо проводить с учетом той задачи, для
решения которой мы собираемся их применять. При этом следует иметь в
виду, что при обучении разных алгоритмов часто используются разные
выборки и один алгоритм может давать лучшие результаты, чем другой,
просто потому, что его лучше "учили". Граничное значение распознаю-
щей функции, отделяющее сайты от несайтов, при сравнении алгоритмов
должно формироваться по одинаковым принципам; в противном случае ре-
зультат сравнения будет плохо интерпретируем.

При проверке, так же как и при обучении программ, необходимо уде-
лять самое пристальное внимание формированию выборок сайтов и несай-
тов. Для обучения программ и получения чисел, характеризующих качес-
тво распознавания, необходимо выбирать правильное соотношение сайтов
и несайтов. Что означает ошибка 37%, полученная в работе Голованова?
Действительно ли взяв 100 белок-кодирующих последовательностей и
применив к ним программу распознавания КВ5, мы у 37 из них получим
неправильное место инициации трансляции?

Взглянем на проблему подробнее. В качестве не-НВ5 Стормо и Голо-
ванов выбирали все АТС кодоны, тогда как нас могут интересовать
только те, которые находятся в правильной рамке считывания. Если мы
уберем квази-КВ5, находящиеся в других рамках считывания, ошибка при
той же границе КВЗ : не-ЕВ5 может уменьшиться в 3 раза. (Заметим,
что мы тем самым изменили алгоритм распознз ния.) Мы можем по дру-
гим соображениям (например, приблизительная молекулярная масса бел-
ка) отсеять еще часть потенциальных инициирующих кодонов, и вероят-
ность ошибки распознавания еще уменьшится. То же и для промоторов:
вероятность ошибки в локализации промотора во фрагменте размером
1000 нуклеотидов гораздо выше, чем в 100-нуклеотидном фрагменте. По -
этому не следует абсолютизировать те характеристики алгоритма рас-
познавания, которые приводят авторы алгоритма: все эти характеристи-
ки нужно определять для своей конкретной задачи.

Последовательности-несайты желательно брать иэ того класса после-
довательностей, с которым будут сравниваться сайты. К примеру, при
построении модели промотора может быть разумно компоновать множество
непромоторов на основе участков, окружающих промотор, относительно
которых есть основания полагать, что промоторов сравнимой эффектив-
ности в них больше нет. При этом каждому промотору будет соответст-
вовать свой набор непромоторов.

Наибольшие проблемы вызывает проверка алгоритмов распознавания в
тех случаях, когда выборка мала. При этом иногда используют так на-
зываемую процедуру "джзкнайф": обучение проводят по всем последова-
тельностям, кроме одной, и затем классифицируют зту одну последова-
тельность, определяя, попадает она в класс сайтов или несайтов. Так
поступают со всеми последовательностями, и число ошибок классифика-
ции служит критерием качества распознавания. Более предпочтительным,
однако, кажется другой подход, при котором выборка сайтов (и несай-
тов, если она нужна для обучения) разбивается на две, и одна из час-
тей используется при обучении, а другая - при проверке.

В качестве выборки несайтов нельзя использовать случайную после-
довательность, сгенерированную на ЭВМ. Генератор случайной последо-
вательности вполне закономерно производит время от времени последо-
вательности, сколь угодно похожие на любую наперед заданную последо-
вательность, в том числе и на сайт. Поэтому нет оснований считать,
что все сгенерированные последовательности не имеют никакого отноше-
ния к сайтам. Тем не менее случайные последовательности могут быть
использованы при проверке программ распознавания образов. Они могут
дать информацию,о том, как часто сигнал, который мы научились узна-
вать, встречается в случайной последовательности и в некоторых слу-
чаях (например, если модель строилась по сайтам и создать выборку
несайтов не представляется возможным) выбрать некоторое начальное
значение функционала, отделяющее сайты от несайтов. Граничное значе-
ние, к примеру, можно выбрать таким, чтобы частота встречаемости
функционального сигнала в случайной последовательности была равна
частоте встречаемости этого сигнала в природных последовательностях.
Информация, получаемая при помощи поиска сайтов на случайных после-
довательностях, в большинстве случаев носит иллюстративный характер.
4.8.	ЗАКЛЮЧЕНИЕ

Главное, чего бы мы хотели достичь в четвертой главе, - это соз
дать у читателя отчетливое представление о неразрывной связи трех
проблем распознавания: выбора модели сигнала, вычисления параметров
модели и множественного выравнивания. В большинстве работ эти задачи
рассматривались как независимые, и решение каждой из них в отдель-
ности (при условии, что две другие уже решены) сейчас не вызывает
больших трудностей. Но до сих пор не ясно, какая из проблем должна
решаться первой.

Решить задачу распознавания функциональных сайтов означает найти
общие для выборки сайтов особенности, при этом может отсутствовать
информация о точной привязке сайта к последовательности. Казалось,
первое, что нужно сделать - это выровнять выборку с тем, чтобы похо-
жие участки оказались друг под другом. Но что есть сходство? На при-
мере терминаторов мы видели, что при выравнивании важно принимать во
внимание не только конкретные нуклеотиды, но и вторичную структуру
молекулы.

Значит, сначала нужно определить набор признаков, из которого
можно составить модель любого функционального сайта. Но даже если
нам и удастся определить характерные признаки для выборки сайтов,
выровнять ее все равно нельзя: мы ничего не знаем о вкладе признаков
в выполнение функции, т.е. о весе признаков. Определить вес признака
(параметры модели) можно лишь только по выровненной выборке. Круг
замкнулся.

Как объединить решения этих задач для распознавания сайтов, пока
не ясно. В последнее время начинается развитие систем, позволяющих
легко конструировать модели функциональных сигналов (ЗФабеп, 1988)
на основании нескольких известных и заложенных в программу типов
признаков. Однако возможно, что придется отказаться от простого сое-
динения разработанных алгоритмов и придумать что-нибудь совершенно
новое.
Глава 5. ФИЗИЧЕСКОЕ (РЕСТРИКЦИОННОЕ)
КАРТИРОВАНИЕ МОЛЕКУЛ ДНК

5.1.КАК ПОСТРОИТЬ ФИЗИЧЕСКУЮ КАРТУ?

Зачем нужны физические карты? В 1970 г. Гамильтон Смит обнаружил,
что специальный фермент - рестриктаза Н1пс111 разрезает молекулы ДНК
при встрече последовательностей из шести нуклеотидов СТССАС или
СТТААС. Вскоре после этого была построена(Саппа еФ а1.,1973) первая
физическая карта (рис.5.1) - изображение молекулы ДНК с указанием
мест разреза рестриктазами(сайтов). С тех пор физические карты стали

Р и с.5.1. Физическая карта
генома 5740, построенная в
1973 г. К.Дэйна, К.Сэком и
Д.Натансом

Стрелками показаны места
разрезов генома ферментом,
выделенным из Н.1пГ1иеп2ае

одним из основных инструментов исследования в молекулярной генетике.
После построения физической карты 5У40 Д.Натане сумел точно указать
место инициации репликации, затем физическая карта была использована
для картирования белок-кодирующих областей 5740. Клонирование до сих
пор остается основной областью применения физических карт. После по-
явления методов чтения последовательностей ДНК сфера использования
физического картирования значительно расширилась: построение физи-
ческой карты обычно предшествует проведению работ по секвенированию.
Следует также отметить, что физические карты активно применяются для
выявления эволюционнной близости геномов (Тетр 1е-Ьоп, 1983; МаФегтап
е! а1., 1984; Не1т-Вус1кжзк1,1Шзоп, 1986) и определения специфичности
рестриктаз(Мазанов,Киселев,1986). Различным аспектам применения фи-
зических карт посвящена книга "51аНз11са1 апа1уз!з о! ВПА зедиепсез
ДаФа", 1983.

Широкое использование физических карт требует развития биохими-
ческих и математических методов, позволяющих строить карты с доволь-
но большим числом сайтов (на такой "подробной" физической карте мож-
но точнее локализовать гены). Однако, несмотря на то, что задача фи-
зического картирования была включена еще в первый проект по компь-
ютерной генетике МОЬСЕЫ (5ФеГ1с,1978), ее до сих пор нельзя считать
окончательно решенной. Дело в том, что при большом числе сайтов пос-
троение физической карты требует перебора и анализа огромного коли-
чества гипотез о порядке расположения рестрикционных фрагментов -
решение этой задачи возможно только при использовании современных
методов дискретной оптимизации.

Конечно, зная нуклеотидную последовательность, легко построить
физическую карту по каждой рестриктазе - для этого нужно просто най-
ти все вхождения сайта узнавания этой рестриктазы в последователь-
ность ДНК. Однако, если последовательность ДНК неизвестна (или из-
вестна не полностью), то физическое картирование превращается в до-
вольно трудоемкую процедуру, требующую как проведения биохимических
экспериментов, так и применения специальных математических методов
построения физических карт по косвенным биохимическим данным. При
этом размеры фрагментов определяются с помощью биохимических мето-
дов, а вот восстановление порядка расположения фрагментов требует
привлечения методов дискретной оптимизации и ЭВМ.

Как получают физические карты? Стандартная биохимическая проце-
дура - электрофорез - позволяет (с некоторой точностью) определить
длины рестрикционных фрагментов, однако для построения физической
карты требуется также знать порядок расположения этих фрагментов.
Так, например, для фага ЗМ Рзеибошопаз аеги§1поза, имеющего всего 3
сайта узнавания рестриктазы Н1пс1П1, возможны 24 различных варианта
расположения фрагментов, некоторые из них представлены на рис.5.2. В
начале 70-х годов возникла идея восстановления порядка расположения
фрагментов на физической карте, основанная на использовании данных о
совместной рестрикции по двум рестриктазам.

На рис.5.3 схематически изображена электрофореграмма, полученная
после обработки линейной ДНК фага 8М Рзеиботопаз аеги^хпоза рестрик-
тазами Н1пс1Ш ( 4 фрагмента),ВагоН! (3 фрагмента) и совместной обра-
ботки рестриктазами Н1пс11 II и ВагаН! (6 фрагментов, при совместной
обработке молекула ДНК расщепляется как по сайтам Н1пйШ, таг и по
сайтам ВатН1). В табл. 5.1 представлены размеры фрагментов,получен-
ных при обработке рестриктазами Н1пйШ,Вал1Н1 и Н1 п<11 II+ВатН1(разме-
ры определены на основании анализа электрофореграммы). Можно рас-
смотреть 4!=24 гипотез о порядке расположения фрагментов рестриктазы
Н1пбШ и 3!=6 гипотез о порядке расположения фрагментов рестриктазы
ВатН1: таким образом, возможны 144 варианта взаимного расположения
сайтов Н1ПС1111 и ВашНТ. Однако информация о совместной рестрикции
ШпсПП+ВатН! позволяет отбросить подавляющую часть этих вариантов и
1	2	3	4

Г - ~ I I	_ . _ц

1	2	4	3

С_____________________1 I

1	3	।	2	4

1	3	4_______2

I II ...I

Р и с.5.2. Различные варианты
расположения фрагментов рес-
триктазы Н1ПЙ111

Р и с.5.3. Схематическое изо-
бражение электрофореграммы,
полученной после расщепления
ДНК фага 5М Рзеибошопаз
аегигшоза рестриктазами
Н1ПС1111 (1-я дорожка), ВатН!
(2-я дорожка) и Н1пйП1+ВатН1
(3-я дорожка). На 4-й дорожке
представлены пробеги маркеров

однозначно восстановить физическую карту.

Действительно, гипотезы о порядке расположения сайтов одиночных
рестрикций должны согласовываться с информацией о длинах фрагментов
совместной рестрикции. Например, приняв гипотезу о порядке располо-
Таблица 5.1

Размеры фрагментов фага 5М Рзеибошопаз аегщцпоза при
расщеплении рестриктазами

| Рестриктаза	Молекулярная масса фрагментов,МДа	|
| Н1ПС1111  | ВашН!  | НФпсНП+ВашН!	|	13,7	|	7,7	|	4,8	|	0,3	|	|	1  |	12,5	|	10,9	|	3,1	|	|	|	|  |	10,9	|	7,7	|	4,8	|	2,7	|	0,3	|	0,1	|

1	2	3	4

Н4паIII

ВашН!

Н1па1I1+ВатН!

1	2	3	4	5 6

Н1пйIII

ВатН1

Н1ПС1111+ВатН1

1	4563	2

Р и с.5.4. Гипотезы о расположении фрагментов рестриктаз Н1псН11 и
ВатН1, представленные в верхней части рисунка, не согласуются с
экспериментальными данными о размерах фрагментов совместной
рестрикции Н1ПС1111 и ВатН1. В нижней части рисунка представлена фи-
зическая карта фага ЗМ Рзеибошопаз аеги§1поза

жения фрагментов (1 2 3 4) рестриктазы ШпбШ и (1 2 3) рестриктазы
ВатН1, мы получим, что длины фрагментов совместной рестрикции равны
(12,5, 1,2, 7,7, 2,2, 2,6, 0,3) (рис.5.4), что противоречит данным
о длине фрагментов совместной рестрикции,представленным в табл. 5.1,-
это означает, что исходную гипотезу о расположении сайтов рестрикций
Н1ПС1111 и ВашН! следует отбросить. Перебрав таким образом все гипо-
тезы о порядке следования сайтов Н1пс1Ш и ВашН1, можно убедиться в
том, что единственным расположением фрагментов Н1пс1Ш и ВатН1, сог-
ласующимся с информацией о длинах фрагментов совместной рестрикции,
является (1 4 3 2) для Н1ПС1Ш и (2 3 1) для ВатНГ. Таким образом,
мы получаем физическую карту (рис.5.4) фага ЗМ Рзеиботопаз
аеги§1поза по рестриктазам ШпбШ и ВатНЦКульба и др., 1986).
Проблемы, возникающие при построении физических карт. Казалось
бы, описанный метод легко может быть использован для построения фи-
зических карт, однако его реализация наталкивается на несколько
серьезных проблем (развитые программы физического картирования име-
ются только в двух современных пакетах программ по молекулярной ге-
нетике ВЫА515 и ВЫА5ТАК(Ноу1е, 1987)).

Определение размеров рестрикцион-
ных фрагментов с достаточно высокой
точностью. Размеры фрагментов, полученные в результате об-
работки электрофореграмм, всегда определяются с некоторой ошибкой.
Требования к точности вызваны тем, что при небольшой погрешности
определения размеров фрагментов число вариантов, перебираемых при
построении физической карты, резко сокращается. Биохимические про-
цедуры и методы интерполяции (экстраполяции), использующиеся для
вычисления размеров фрагментов, описаны в разделе 5.2. Там же об-
суждаются некоторые проблемы, возникающие при интерпретации
электрофореграмм - знакомство с ними может быть полезно биологам-
экспериментаторам.

Построение парных физических карт.
Прямой перебор гипотез уже при числе фрагментов около 10 натал-
кивается на серьезные вычислительные трудности и не может быть ре-
ализован даже на современных ЭВМ. Следует отметить также, что пе-
ребор гипотез о порядке расположения фрагментов для кольцевых мо-
лекул оказывается значительно сложнее,чем для линейных в связи с
тем, что в этом случае необходимо анализировать не только порядок
фрагментов, но и сдвиг фрагментов одной рестриктазы относительно
фрагментов другой. В разделе 5.3 описываются методы направленного
перебора гипотез, позволяющие резко снизить вычислительную слож-
ность алгоритма для случая построения парной физической карты
(т.е. карты, строящейся по информации о двух одиночных и одной
совместной рестрикции).

Методы построения карт с помощью ЭВМ развиваются с середины
70-х годов. Стефик(5ФеПс, 1978; Стефик и др.,1985) предложил метод
генерации всех перестановок фрагментов совместного расщепления, а
Пирсон(Реагзоп,1982) - генерации перестановок фрагментов одиночных
расщеплений (согласно общепринятым обозначениям, мы будем исполь-
зовать термин 5В-фрагменты для фрагментов одиночной рестрикции и
ВВ-фрагменты для фрагментов совместной рестрикции - 51пё1е
В1§ез11оп и ВоиЫе В1§ез11оп).Число итераций в обоих методах оце-
нивается экспоненциальной функцией от числа фрагментов, поэтому,
как отмечено Полнером и др.(Ро1пег еФ а1.,1984), реализация мето-
дов со столь высокой вычислительной сложностью весьма проблематич-
на уже при небольших пит (здесь пит- число фрагментов в 1-й
и 2-й обработке рестриктазами).
В ряде работ(Ро1пег е€ а1.,1984; Сигапб.Вгеееееге, 1984;
С1х,К1егопзка,1988) удалось снизить трудоемкость перебора благода-
ря усовершенствованиям алгоритма Пирсона (эти методы применимы в
основном для случая линейных молекул). Ноланом и др.(Ио1ап еЪ
а1.,1984) предложен принципиально новый алгоритм перебора вариан-
тов, применимый как для линейных, так и для кольцевых молекул (в
работах Туффери и др.(ТиГГегу еФ а1.,1988), Беллона(Ве Поп, 1988) и
Кравчака(Кгатсгак,1988) метод Нолана и др. был значительно усовер-
шенствован). Совсем недавно(Со1с!5<;е1п, даа'Ьегшап, 1987) для построе-
ния физических карт был предложен метод, использующий интерпрета-
цию задачи физического картирования в терминах статистической ме-
ханики. Решение вопроса о том, какой из известных алгоритмов физи-
ческого картирования является предпочтительным, затруднено, так
как в настоящее время не представляется возможным теоретически
оценить их вычислительную сложность (попытки анализа сложности,
предпринятые в работе Полнера и др.(Ро1пег еФ а1.,1984), привели к
большому разрыву между верхней и нижней оценкой).

Построение множественных физичес-
ких карт. Уже в первых работах по физическому картированию
было отмечено, что использование только информации о результатах
двух одиночных и одной совместной рестрикции, как правило, не дает
возможности однозначно восстановить физическую карту: при числе
сайтов около 10 ( по каждой рестриктазе) получаются десятки (а
иногда сотни) карт, лежащих в пределах ошибок биохимического
эксперимента ( Певзнер, Миронов,1987а). Причины этого кроются,
с одной стороны, в недостаточно высокой точности определения
размеров фрагментов, с другой - в огромном количестве вариантов
взаимного расположения сайтов рестрикции. Для снятия неодно-
значности приходится переходить от двух к нескольким рестриктазам
( известны случаи, когда использование даже 5 одиночных и 10
совместных рестрикций не давало возможности однозначно
идентифицировать физическую карту). Таким образом, при
переходе к нескольким рестриктазам вместо классической задачи пос-
троения парной физической карты (по двум ЕГО- и одной ВС- рестрик-
ции) возникает задача построения множественной физической карты
(по нескольким 50- и СО-рестрикциям), для решения которой предло-
жен метод потенциалов (Певзнер,Миронов,1987а). В разделе 5.4 опи-
сывается метод потенциалов и обсуждаются трудности, возникающие
при построения множественных физических карт.

Уточнение физических карт. При реализации
алгоритмов физического картирования на первый план выдвигаются
следующие две задачи:

- оптимальная организация перебора гипотез о взаимном расположе-
нии сайтов (рассматривается в разделах 5.3 и 5.4);
- эффективная проверка и отбраковка гипотез о взаимном расположе-
нии сайтов.

В рассматриваемом ранее примере мы отвергли гипотезу о порядке
расположения сайтов рестриктаз Н1п(1111 и ВатНТ, поскольку получаю-
щийся при принятии этой гипотезы набор размеров фрагментов совмес-
тной рестрикции 31=( 12,5, 7,7, 2,6, 2,2, 1,2, 0,3) совершенно не
похож на экспериментально полученный набор 52=(10,9, 7,7, 4,8,
2,7, 0,3, 0,1). Однако, как правило, вопрос о принятии (или отбра-
сывании) той или иной гипотезы (или, иначе, о сходстве наборов
размеров фрагментов) далеко не всегда решается столь однозначно:
во-первых, экспериментально полученные размеры фрагментов совмест-
ной рестрикции определены с ошибками, а во-вторых, может оказать-
ся, что рестрикционные сайты Н1п(1Ш и ВашН! можно "немножко под-
вигать" и наборы 8, и 32 станут похожи? В разделе 5.5 рассмат-
ривается задача о проверке и отбраковке гипотез (другое ее назва-
ние - уточнение физических карт, так как проверка гипотез сводит-
ся, как правило, к уточнению положения сайтов рестрикции относи-
тельно некоторой точки на карте - начала отсчета).

Еще в 1978 г. (Зс11гое(1ег,В1аФФпег, 1978) был предложен метод на-
именьших квадратов для уточнения физических карт, при этом соот-
ветствие гипотезы о расположении сайтов экспериментальным данным
оценивалось в евклидовой норме(см. раздел 5.5). Такой подход поз-
воляет предложить быстродействующий алгоритм уточнения физических
карт, однако использование евклидовой нормы для оценки гипотез не
отбраковывает многие несостоятельные варианты. Выбор равномерной
нормы в большей степени соответствует реальной задаче картирова-
ния, так как незначительные отклонения от данных электрофореграмм
вполне допустимы (они постоянно встречаются при картировании), а
вот значительные отклонения хотя бы на одном фрагменте недопустимы
и должны приводить к отбраковке гипотезы о порядке расположения
сайтов.

Рассмотрение задачи уточнения физических карт в равномерной
норме (Певзнер,1987,1988а) приводит к двум известным задачам диск-
ретной математики: нахождению циркуляций в потоковой сети с двус-
торонними ограничениями (Форд,Фалкерсон,1966) и поиску оптимально-
го контура в графе (Кагр,1978). Использование алгоритмов Форда-
Фалкерсона и Карпа дает возможность получить быстродействующий
(что особенно важно, учитывая огромное число перебираемых гипотез)
полиномиальный алгоритм уточнения физических карт. Помимо эффек-
тивного метода проверки и отбраковки гипотез, такой подход позво-
ляет локализовать для каждой гипотезы узкие места, т.е. выявить
фрагменты, дающие максимальное отклонение от экспериментальных
данных(положение таких фрагментов может быть определено с привле-
чением дополнительных биохимических экспериментов).
Оптимальное планирование биохими-
ческих экспериментов по картирова-
нию. Построение физических карт на ЭВМ освобождает эксперимента-
торов от рутинной и трудоемкой работы и дает возможность получать
подробные физические карты (порядка 10 сайтов по каждой рестрикта-
эе), построение которых без помощи ЭВМ невозможно. Однако построе-
ние физических карт с 10-20 сайтами по каждой рестриктазе (при
использовании только информации об одиночных и совместных рестрик-
циях) сталкивается с серьезными вычислительными трудностями даже
на современных ЭВМ. В разделе 5.6 обсуждаются возможности дополни-
тельных биохимических экспериментов, которые позволяют иногда
обойти математические проблемы построения физических карт за счет
получения (довольно трудоемкого) биохимическими методами информа-
ции о порядке расположения рестрикционных фрагментов (при
использовании таких методов требования к точности определения длин
фрагментов снижаются). Привлечение информации о дополнительных
биохимических экспериментах дает возможность строить очень подроб-
ные физические карты (20-50 сайтов по каждой рестриктазе). Работа
с ЭВМ в режиме диалога позволяет свести к минимуму и эксперимен-
тальную работу по картированию - при этом минимизируется количест-
во электрофорезов и указывается минимальный набор дополнительных
биохимических экспериментов, необходимых для построения физической
карты.

5.2.ОПРЕДЕЛЕНИЕ РАЗМЕРОВ РЕСТРИКЦИОННЫХ ФРАГМЕНТОВ

Использование маркеров для определения размеров фрагментов.
Рестрикционные фрагменты можно разделить с помощью электрофореза.
На схеме электрофореграммы (рис.5.3) .полученной при разделении
Н1п<1Ш-фрагментов ДНК фага ЗМ Рзеийотопаз аеги§1поза, видны четыре
полосы, каждая полоса соответствует одному рестрикционному фрагмен-
ту. Длина пробега фрагмента в геле зависит от его размеров (молеку-
лярного веса): чем больше фрагмент,тем меньшее расстояние в геле он
проходит. Зная зависимость Б(К), можно по длине пробега восстановить
длины рестрикционных фрагментов (через К обозначен размер фрагмента,
через В - длина пробега в геле). Однако получение аналитических фор-
мул для зависимости Б(К) (31а1ег е! а!.,1987) затруднено. В реальных
биохимических экспериментах по картированию аналитические формулы
обычно не используются, вместо них для определения зависимости В(К)
проводится электрофорез с фрагментами, размер которых заранее извес-
тен (такие фрагменты называются маркерами). В правой дорожке на
рис.5.3 представлены пять полос, соответствующих маркерам. Эти поло-
сы можно использовать для определения размеров фрагментов фага ЗМ
Рзеиботопаз аеги§1поза. На рис.5.5 по размерам маркирующих фрагмен-
тов и их длинам пробегов построена интерполяционная кривая, которая
позволяет оценить размеры фрагментов фага ЗМ Рзеибошопаз аеги§1поза.

Методы аппроксимации для определения размеров фрагментов. Для
аппроксимации длин рестрикционных фрагментов по длинам маркеров было
предложено несколько подходов.

Саузерн(ЗоиФ1тегп,1979) предложил для расчета размеров фрагмен-
тов соотношение:

П(К)= с/(К-К0)+Б0,
где В0,В0,с - некоторые константы.

Р и с.5.5. Интерполяционная кривая, построенная по длинам пробегов
пяти маркеров, представленным на рис.5.3 (для наглядности по оси
абсцисс отложен 1п(К), а не К).На интерполяционной кривой отмечены
три точки, соответствующие фрагментам рестриктазы ВашН!

Для вычисления параметров В0,В0,с необходимы, по крайней мере,
три маркера (эти маркеры целесообразно выбирать так, чтобы анали-
зируемый фрагмент лежал между ними). Соотношение Саузерна можно ис-
пользовать в двух формах: локальной и глобальной
(ЗсЬаИег, ЗебегоИ, 1981). В первом случае при определении размера
фрагмента используется информация только о маркерах,близких по раз-
меру к анализируемому фрагменту, а во втором - обо всем множестве
маркеров(при этом используется метод наименьших квадратов). Следует
отметить, что хотя использование соотношения Саузерна в глобальной
форме более полно использует информацию о маркерах, тем не менее в
локальной форме оно дает более высокую точность в определении длин
фрагментов (ЕИег.ЗоиФФегп, 1983). Это вызвано тем, что параметры Ко,
ЦрС остаются постоянными только в узких интервалах длин пробегов.

Другой подход к определению размеров фрагментов связан с кусочно-
линейной интерполяцией зависимости логарифма К от В, а также с
аппроксимацией этой зависимости кривой 2-го порядка (С觧1еЬу еФ
а1.,1981) или третьего порядка(Киззе15 еФ а1.,1984):

1п(К)=а3В3+а2В2+а1В1+а0.

Сравнительный анализ методов аппроксимации ( ортогональными по-
линомами; кубической сплайн-функцией; кусочно-линейной функцией; с
помощью соотношения Саузерна в локальной форме) показал, что
лучшие результаты дает аппроксимация кубической сплайн-функцией
(Сои§Ь,Сои§Ь,1984). Пехов и др.(1985) предложили специальный метод,
позволяющий экстраполировать размеры фрагментов, не укладывающихся в
шкалу маркеров.

Какие трудности возникают при определении размеров фрагментов?
В настоящее время имеется большое число программ (Сгау еФ а1.,1984;
К1езег,1984; Ма1па еФ а1.,1984; и др.) вычисления размеров фрагмен-
тов, ориентированных на персональные компьютеры и использующих раз-
личные методы аппроксимации.Однако следует отметить, что при аппрок-
симации возникают следующие проблемы.

1.	Экстраполяция дает большие ошибки в определении размеров фраг-
ментов. При необходимости определения размеров больших фрагментов
(свыше 10 тыс. нуклеотидов) необходимо тщательно подходить к выбору
маркеров - дело в том, что при использовании в качестве маркеров
фрагментов фага лямбда в области свыше 10 тыс. нуклеотидов оказыва-
ется, как правило, один маркер, что явно недостаточно для надежного
определения размеров больших фрагментов. При определении размеров
больших фрагментов имеет смысл ставить несколько маркирующих дорожек
(3-4) по различным рестриктазам: в этом случае число маркеров в об-
ласти больших размеров оказывается уже приемлемым.

2.	Удачный подбор маркеров. Не должно быть больших "дырок" между
маркерами - в идеале в связи с нелинейностью для каждого интервала
длин разумно подбирать свои маркеры.

3.	Точность определения положения линий на электрофореграмме. Ли-
нии на электрофореграмме имеют определенную толщину и на глаз трудно
определить положение центров линий. В связи с этим при определении
центров линий используются аналоговые и цифровые денситометры
(ЕЫег.ЗоиФФегп, 1987; Сгау еФ а1.,1984).

4.	Совмещение линий, соответствующих фрагментам,близким по длине.
Выявление совмещения линий на глаз (по интенсивности свечения) может
вести к потере или появлению лишних фрагментов. Использование цифро-
вых денситометров и специального математического обеспечения позво-
ляет анализировать пики интенсивности на электрофореграммах
(Е1йег,ЗоиФПегп,1987).

5.	"Убегание" коротких фрагментов из геля. Короткие фрагменты да-
ют также размытые и слабоокрашенные линии на электрофореграмме.

6.	Зависимость длины пробега от нуклеотидного состава и конформа-
ции фрагмента. Элдер и Саузерн(Е1<1ег,5ои№егп, 1983) показали,что при
различиях в нуклеотидном составе фрагментов ошибки в определении
длин фрагментов могут значительно возрастать.

5.3.	МЕТОД ВЕТВЕЙ И ГРАНИЦ ДЛЯ ПОСТРОЕНИЯ ПАРНОЙ ФИЗИЧЕСКОЙ КАРТЫ

Как организовать перебор вариантов при картировании? Необходи-
мость разработки математических методов построения физических карт
была осознана уже в начале 70-х годов, когда биологи, пытавшиеся
строить физические карты без привлечения ЭВМ, столкнулись со значи-
тельными вычислительными трудностями уже при построении парных физи-
ческих карт с 5-8 сайтами по каждой рестриктазе. В 1977 г. Паркер и
др.(Рагкег е! а1.,1977) отмечали, что серьезные проблемы возникают
не только при построении физической карты, но и при доказательстве
того, что найденная карта - единственно возможная. Ранние попытки
(ЗФеПс,1978; Реагзоп,1982) решения задачи физического картирования
нельзя признать удачными,поскольку они использовали прямые перебор-
ные методы, быстро выходившие на ограничения по времени расчета. Зе-
хетнер и др.(2еЬеФпег е! а1.,1987) провели анализ метода Пирсона
(Реагзоп,1982): даже при расчете небольшой парной карты с 5 сайтами
по каждой рестриктазе и нереалистично низким уровнем ошибок, время
счета составило 42 мин на УАХ 11/780. По-видимому, первым "работаю-
щим" методом построения физических карт был метод Фитча и др.(ЕИсЬ
е! а1.,1983), использующий технику, известную в дискретной математи-
ке как метод ветвей и границ. Основная идея метода ветвей и границ
заключается в организации перебора предварительных "заготовок" для
построения карт с одновременной оценкой потенциальных возможностей
этих заготовок и отбрасыванием тех вариантов, оценка которых оказа-
лась слишком низкой. Эффективность метода ветвей и границ определя-
ется способом организации перебора (ветвления) и выбором оценочной
функции. В ряде работ(иногда в неявном виде) были сделаны попытки
добиться повышения эффективности построения карт за счет разных под-
ходов к организации ветвления и выбору оценочной функции - здесь
рассматривается подход, изложенный в работах Певзнера и Мироно-
ва(1986,1987а).
Физические карты, вилки и вложения. Исходной информацией для
построения парной физической карты служат размеры ЗВ-фрагментов оди-
ночных расщеплений рестриктазами А и В, размеры ВВ-фрагментов сов-
местного расщепления рестриктазами А+В и ошибки их измерения:

А=(а,,... ,ап) , бА=( ба,,... ,бап);

.....Ь„) , бВ=( бЬ,..........бЬт);

АВ=(аЬ,,... ,аЬ„),	бАВ=( баЬ,,... ,баЬк)

( к равно п+т для линейной молекулы и п+т-1 для кольцевой, однако
часто к оказывается меньше в связи с "убеганием" коротких фрагментов
из геля). В табл. 5.2 приведены исходные данные, которые будут далее
использоваться в качестве примеров(в этом параграфе мы не обсуждаем
возможности использования информации о дополнительных биохимических
экспериментах,которые будут рассмотрены в разделе 5.6).

Таблица 5.2

Размеры фрагментов ЗВ- и ВВ-расщеплений.

Общая длина молекулы - 104(в условных единицах).
Информация о рестриктазе С используется в
разделе 5.4 при построении множественных карт

Тип обработки	Номера фрагментов	|
	1	2	1 з	1 4	5 I	6	7 1
А	44	42	18
В	42	38	16	8
С	58	46
АВ	36	30	12	8	8	6	4
ВС	40	38	8	8	8	2
СА	42	34	14	10	4

Следуя работе Нолана и др.(Но1ап еФ а!.,1984), будем называть
группу ВВ-фрагментов расщепления рестриктазами АВ 1-вилкой расщепле-
ния А, если сумма длин этих фрагментов равна длине 1-го ЗВ- фрагмен-
та расщепления А (с учетом ошибок измерения). Например, 3=(36+8) и
3=(30+8+6) - 1-вилки расщепления А, 3=(30+12) и 3=(30+8+4) - 2-вилки
расщепления А, 5=(8+8) - 3-вилка расщепления В (рис.5.6). 1-вилку
расщепления А можно интерпретировать как набор фрагментов, на кото-
рые может разбиться 1-й фрагмент А при действии рестриктазы В.

Назовем вложением набора фрагментов АВ в набор А такое разбиение
п

множества фрагментов АВ= 0 5. на подмножества 3., что каждое 5.
1=1

является 1-вилкой расщепления А (вложения можно рассматривать как
предварительные заготовки для построения физической карты). Напри-
мер, разбиения

6* Заказ № ШТ

165
44

42

1а

8+8

Р и с.5.6. Примеры вилок

30+8+6 36+6 30+8+4	30+12 12+4

36+8

(36+8), (30+8+4), (12+6);

(36+8), (30+12), (8+6+4)

являются вложениями АВ в А. Очевидно, что каждая физическая карта
порождает вложения АВ в А и в В(рис.5.7). Обратное, вообще говоря,
неверно. Например, вложениям

(36+8), (30+8+4), (12+6) АВ в А;

(36+8), (30+6), (12+4),(8) АВ в В

не отвечает ни одна физическая карта, в этом случае мы будем гово-

рить, что вложения АВ в А и АВ в В несовместимы.

Решение задачи о построении парной физической карты разобьем на
три этапа: 1) поиск вилок расщеплений А и В; 2) поиск вложений АВ в
А и в В; 3) удаление несовместимых пар вложений и восстановление
парных физических карт по совместимым парам вложений.

А

Р и с.5.7. Соответствие между
физическими картами и вло-
жениями. Карта на рисунке по-
рождает вложения:

(36+8), (30+8+4)/12+6) АВ в А;

(36+6), (30+8), (12+4), (8) АВ в В

А

Поиск вилок. Задача поиска вилок сводится к классической задаче
о сумме размеров (Гэри,Джонсон,1982) : в множестве чисел {а} найти
все подмножества X, для которых

А-6 < Е а < А+6,
аеХ

где А и 6 - фиксированные числа. Эта задача может быть решена с ис-
пользованием метода динамического программирования - таким образом,
поиск вилок не является проблемой (для задач физического картирова-
ния реальной размерности). Однако при высоком уровне погрешностей в
определении размеров фрагментов возможна ситуация, когда число вилок
оказывается очень большим, что затрудняет этап поиска вложений АВ в
А и в В. Для уменьшения трудоемкости этого этапа Нолан и др. (До1ап
еФ а1.,1984) предложили методы, позволяющие резко сократить множест-
во вилок, использующихся при поиске вложений.

Поиск вложений(,). Поиск вложений - самый трудный этап при по-
строении парных карт. Удобно сформулировать эту задачу на языке
теории графов как задачу поиска "представительных" наборов ви-
лок (т.е. наборов, в которые входят все ПП-фрагменты).

Для поиска вложений АВ в А строится гиперграф Н на множестве вер-
шин АВ В А (определения, относящиеся к теории графов, см. Зы-
ков, 1987). Каждой 1-вилке 5 рестрикции А, состоящей из 1 ВВ- фраг-
ментов, соответствует ребро 5 II {1} в гиперграфе Н, состоящее из 1+1
вершины. Задача поиска вложений эквивалентна задаче нахождения точ-
ного покрытия гиперграфа Н ребрами(Гэри,Джонсон,1982). Отсутствие
эффективных алгоритмов для решения этой задачи заставляет применять
переборные методы дискретной оптимизации, например метод ветвей и
границ (Е1ФсЬ еФ а1.,1983; Певзнер,Миронов,1987а). Следует отметить,
что многие эвристические правила отбора вилок, введенные Ноланом и
др.(Мо1ап еФ а1.,1984), вытекают из процедур поиска точного покрытия
гиперграфа ребрами.

Описание метода ветвей и границ (Романовский,1977) применитель-
но к конкретной задаче предполагает описание стратегии ветвления и
процедуры отсечения. Например, в работе Певзнера и Миронова(1987а)
для организации перебора строится дихотомичное дерево ветвления
Т (рис.5.8). Корневой вершине дерева Т отвечает разбиение АВ. На
каждой итерации вершина дерева Т порождает две новые вершины; одна
из них отвечает варианту, в котором подмножества (элементы разбие-
ния) объединяются, другая - варианту, в котором объединение запре-
щено. Размножение вершин дерева Т продолжается до тех пор, пока чис-
ло групп в разбиении вершины не станет равным п - числу фрагментов
5В-расщепления. Теперь задача поиска вложений сведена к задаче по-
иска висячих вершин дерева Т, соответствующих вложениям. Для опреде-
ления процедуры отсечения определим на вершинах х дерева Т функцию
оценки вариантов Г(х):

“ О,

Г(х) =

если х или какой-либо потомок х является

вложением

1, в противном случае.

Задача поиска вложений эквивалентна задаче поиска минимума Г(х)
на вершинах дерева Т. Примитивный подход к минимизации Г(х) связан с
анализом всех вершин дерева Т и требует перебора колоссального числа
б**
Р и с.5.8. Дихотомичное дерево ветвления(фрагмент). Каждой вершине
соответствует прямоугольник, в первой строке которого представлена
информация о разбиении,во второй - о запрещении объединения фрагмен-
тов, в третьей - значение функции оценки вариантов. В круглых скоб-
ках - информация об объединении фрагментов, в квадратных - о запре-
щении объединения (например, запись [6,36] означает, что фрагменты 6
и 36 объединяются, а запись [6-36] - что объединение фрагментов зап-
рещено). В двойных прямоугольниках показаны вершины, соответствующие
вложениям

вариантов. Поэтому для отсечения заведомо тупиковых вариантов ис-
пользуется минорирующая функция §(х): §(х)<Г(х), которую можно вы-
числить, не прибегая к полному перебору. В качестве такой функции

выберем функцию

§(х)=

1, если в разбиении
в какую вилку

есть подмножество, не входящее ни

О, в противном случае.

При просмотре дерева Т вершины, в которых §(х)=1, отбрасываются
вместе со всеми потомками. При реализации метода ветвей и границ
возможно совместное использование функции §(х) и различных процедур
отсечений (ЕИсЬ еФ а1.,1983; До1ап еФ а1.,1984). Следует отметить,
что, несмотря на обилие предложенных подходов, поиск вложений явля-
ется самым трудным этапом при построении парных физических карт.

Проверка совместимости вложений и интервальные графы. После
построения вложений АВ в А и в В производится проверка совместимости
пар влсжений("склейка" вложений), при этом может быть использован
метод интервальных графов (1аФегтап,Сг1е§5,1986) или специальные
процедуры (По1ап еФ а1.,1984).

Для рестрикционной карты, представленной на рис.5.4,б, можно
ввести матрицу инциденций(перекрытий):

О 1 1

КА,В) =

1 О о

1 О 1

0 0 1

где А и В - сокращенные обозначения для рестриктаз Н1пс1Ш и ВатН! и

| 1, если к-й фрагмент рестриктазы А перекрыва-
ть (А,В) = -| ется с 1-м фрагментом рестриктазы В

|_ 0, в противном случае.

Таким же образом вводятся матрицы :
		1	0	0	1	0	0
К А,А+В)	=	0 0	1  0	0  1	0 0	0  0	0  1
		0	0	0	0	1	0
		0	1	1	0	0	0
К В,А+В)	=	1	0	0	0	0	0
		0	0	0	1	1	1

где

1к1(А,А+В) =

1,если к-й фрагмент одиночной рестрикции А
содержит 1-й фрагмент совместной
рестрикции А+В

О,в противном случае

(матрица 1к1(В,А+В) определяется аналогично).

Заметим, что для любого 1, 1-я строка матрицы 1(А,А+В) определяет
1- вилку А, а 1-я строка ЦВ.А+В) - 1-вилку В(например, (10,9 + 2,7)
- 1-вилка А, а (7,7 + 4,8) - 1-вилка В). Таким образом, матрице
1(А,А+В) соответствует некоторое вложение АВ в А, а матрице 1(В,А+В)
- вложение АВ в В.

Матрицы инциденций используются при проверке совместимости вложе-
ний. Для построения парной физической карты после этапа поиска
вложений можно перебирать всевозможные пары вложений и для каждой
4

1

2

3

Р и с.5.9. Граф С(Н,В) физической карты,приведенной на рис.5.4: каж-
дому рестрикционному фрагменту соответствует вершина, а каждой паре
перекрывающихся фрагментов - ребро графа С(Н,В). Цифры возле ребер,
соединяющих вершину 1 в верхней доле и вершину а в нижней доли,соот-
ветствуют номерам фрагментов совместной рестрикции, образующихся при
перекрывании фрагментов 1 и з

пары строить матрицы 1к1(А,А+В) и 1к1(В,А+В). Ватерман и Григе
(^аФегтап,0г122з,1986) показали, что матрица 1(А,В) может быть полу-
чена как произведение булевых матриц 1(А,А+В) и 1Т(В,А+В) (здесь
1Т(В,А+В) - транспонированная матрица для 1(В,А+В) ). По матрице
К А,В) можно построить двудольный граф 6 с долями А и В (рис. 5.9).

Если физическая карта рестрикций А и В известна, то построить по
ней граф С(А, В) очень просто. При анализе совместимости вложений
приходится решать обратную задачу: по графу С(А,В) восстановить фи-
зическую карту. Ватерман и Григс(1УаФегтап,Сг122з, 1986) приводят тео-
рему:

двудольный граф С(А,В) является графом рестрикционной карты тогда
и только тогда, когда он является интервальным двудольным графом
без изолированных вершин,
и сводят задачу проверки совместимости вложений к известной задаче
распознавания интервального графа и нахождения его интервального
представления(ВооФ11,Ьеикег, 1976; Миркин,Родин, 1977). Нужно отметить,
что поиск совместимых вложений не является лимитирующим этапом при
построении парных карт и подход Ватермана - Григса следует рассмат-
ривать лишь как один из многих возможных.

При проверке совместимости вместо порождения всех перестановок
внутри вилки (1! вариантов, где 1- число элементов вилки) перебира-
ются только пары крайних элементов вилок (1(1-1) вариант),так как
порядок средних элементов не восстанавливается. Проверка совмести-
мости значительно упрощается, если известно расположение фрагментов
одного 30-расщепления. Эти данные могут быть получены из решения за-
дачи о парной карте для других пар рестриктаз, скажем А и С. Следует
отметить, что проверку совместимости вложений можно вести уже на
этапе поиска вложений - такой подход позволяет избавиться от анализа
неперспективных вложений.
О числе решений задачи физического картирования. Информации о
размерах фрагментов двух БП- и одной ПП-рестрикции,как правило, не-
достаточно для однозначной идентификации физической карты (при ре-
альных уровнях ошибок в определении размеров фрагментов), так как
число вложений и допустимых парных физических карт резко возрастает
при увеличении числа ВВ-фрагментов. Гольдстейн и Ватерман
(ЦоМзФешДаФегтап, 1987), используя субаддитивную эргодическую тео-
рему Кингмана, показали, что число решений задачи физического карти-
рования растет как экспонента от длины картируемой молекулы. Таким
образом, для однозначной идентификации физических карт необходим еще
один этап - сцепление парных карт и построение множественной физи-
ческой карты.

5.4.	МЕТОД ПОТЕНЦИАЛОВ ДЛЯ ПОСТРОЕНИЯ МНОЖЕСТВЕННОЙ ФИЗИЧЕСКОЙ КАРТЫ

Схема эксперимента. Представьте себе, что при построении парной
физической карты получено 100 различных вариантов расположения сай-
тов рестриктаз А и В. Как отбросить 99 из них и выбрать единственно
правильное? При множественном картировании на помощь приходит инфор-
мация о парных картах АС и ВС - учет этой информации отсекает вари-
анты, которые не согласуются с информацией о расположении сайтов А и
В, полученной на основе анализа карт АС и ВС. Таким образом, при
построении карты по рестриктазам А,В,С возникает задача: среди мно-
жества парных карт АВ,ВС и СА выбрать три "согласованных" и "скле-
ить" их на одной множественной карте. В этом разделе описываются ме-
тоды проверки "согласованности” и алгоритмы "склейки" парных физи-
ческих карт.

Пусть в результате эксперимента получены данные о длинах фраг-
ментов 1 одиночных рестрикций и некоторые данные о длинах фрагментов
совместных рестрикций. Сопоставим этому эксперименту схему с 1 вер-
шинами: каждому одиночному расщеплению соответствует вершина схемы,
каждому совместному расщеплению - ребро схемы, соединяющее соответс-
твующие вершины. На рис.5.10 схема С1 отвечает варианту, рассмот-
ренному в работе Нолана и др.( Ыо1ап еФ а1.,1984), схема С2 - ва-
рианту из работы Полнера и др. (Ро1пег еФ а1.,1984), а схемы С3 и
С4 - экспериментам с пятью рестриктазами. Как уже отмечалось, для
однозначной идентификации физической карты необходимо достаточно
большое число совместных расщеплений или, иными словами, достаточ-
ная насыщенность схемы эксперимента ребрами. Опыт решения задачи
построения множественных карт показывает, что важную роль играет
также вид схемы эксперимента; так, например, двусвязная схема С4
предпочтительнее односвязной схемы С3, хотя они имеют одинаковое
число ребер и эксперименты по схемам С3 и С4 одинаково трудоемки.
с

1

Р и с.5.10.Примеры схем экспериментов

Р и с.5. И.Парные физические карты, полученные по методу ветвей и
границ, - для разбиений А и В (а),для разбиений В и С(б), для разби-
ений С и А(в)
Это замечание может быть полезным при рациональном планировании
экспериментов по картированию.

Потенциалы и вращения вершин в схеме эксперимента'. Рассмот-
рим эксперимент по схеме "треугольник" с тремя рестриктазами А,
В, С (табл. 5.2) и кольцевой молекулой ДНК. Метод потенциалов пред-
полагает построение на предварительном этапе всех допустимых парных
физических карт (т.е. парных карт, лежащих в пределах ошибки экспе-
римента). Предполагается, что после построения парных физических
карт (любым из известных методов) на каждом ребре схемы 0 построено
некоторое множество парных физических карт (рис.5.И), и возникает
задача их сцепления на одной множественной карте.

Каждую расстановку из п фрагментов на кольцевой молекуле можно
записать 2п способами в зависимости от того, какой фрагмент выбрать
первым (п вариантов) и какое выбрать направление обхода (два вариан-
та). Каждую такую расстановку будем записывать как набор из п+1 чис-
ла: первые п - размеры фрагментов, последнее число +1 или -1 в зави-
симости от направления обхода (+1 - по часовой стрелке, -1 - против
часовой стрелки). Например, расстановку фрагментов рестрикции А на
рис.5.7 можно записать различными способами: (44, 42,18, +1), (18,
44, 42, +1), (42, 44, 18, -1) и т.д. Канонической будем называть
лексикографически максимальную из всех возможных записей (для карты
на рис. 5.7 канонической записью для А будет (44,42,18,+1) , а для В
- (42,38,8,16,+1)). Точка начала первого фрагмента в канонической
записи определяет начальную точку каждого 5В-расщепления(на рис.5.7
начальной точкой рестрикции А является граница фрагментов 44 и 18, а
рестрикции В - граница фрагментов 42 и 16). Расстояние между началь-
ными точками (при движении по часовой стрелке) определяет сдвиг
з(А,В) между двумя ЗВ-расщеплениями А и В, ориентации канонических
записей рестрикций А и В определяют согласованность
и(А,В):у(А,В)=+1, если канонические записи А и В одинаково ориенти-
рованы; в противном случае у(А,В)=-I	(на рис.5.7

з(А,В)=98,у(А,В)=+1). Заметим, что величина з(А,В) задается с неко-
торым допуском, определяемым погрешностями определения размеров ЗВ-
и ВВ-фрагментов. Зафиксируем на молекуле некоторую точку "О" - нача-
ло отсчета (можно считать, что точка "О" является единственным учас-
тком расщепления для гипотетической рестриктазы В). Числа
р(А)=з(В,А) и с(А)=ч(К,А) будем называть потенциалом и вращением
рестрикции А. Можно показать, что

з(А,В)=(р(В)-р(А))’с(А) [той ВЫ,	(5.1)

у(А,В)=с(А)-с(В),	(5.2)

где ВЬ - длина молекулы (равенство в (5.1) записано с учетом ошибок,
правая часть (5.1) рассматривается по модулю ВЬ). Оператор, действу-
А1 4.44,42,18,41)

В =(42,38,16,8,41

В =(42,38,8,16,41

)

О =(56,48,41)

С

Р и с. 5.12. Преобразование графа С в мультиграф (1пс1(А)=1,1пс1(В)=2,
ша(с)=1)

ющий на вершинах схемы эксперимента и определенный равенствами (5.1)
и (5.2), называется коциклическим. Задача исследования аналогичных
операторов часто возникает в теории графов (ЬеГзсПег,1975).

Построение множественной карты сводится к поиску представитель-
ных подграфов(,). Задачу построения множественной физической карты
можно переформулировать как задачу поиска таких потенциалов р и
вращений с на вершинах схемы эксперимента, которые порождают сдвиги
и согласованности (по формулам (5.1) и (5.2)), совпадающие с данны-
ми, полученными на этапе поиска парных физических карт. Таким обра-
зом, при построении множественной физической карты нужно выбрать не-
которые расстановки фрагментов рестрикций А,В и С и, используя фор-
мулы (5.1) и (5.2), попытаться "склеить" их на одной карте. При этом
следует анализировать не все варианты расположения фрагментов: в
частности, при расстановке сайтов рестрикции А можно рассматривать
не все варианты, представленные в парных картах АВ , а только те,
которые смогут в дальнейшем участвовать в некоторой "склейке". Для
отбрасывания вариантов, которые не смогут участвовать в построении
множественной физической карты, используется понятие индекса верши-
ны.

Назовем индексом 1п<1(А) расщепления А число канонических расста-
новок ЗВ-фрагментов расщепления А, совместимых со всеми типами пар-
ных расщеплений, в которых участвует А. В примере на рис.5.И единс-
твенной допустимой расстановкой фрагментов расщепления А будет
А(=(44, 42, 18,+1)); следовательно, вершина А имеет индекс 1, вер-
шина В - индекс 2, так как допустимыми являются расстановки
В,=(42,38, 16, 8, +1), В2=(42, 38, 8, 16, +1), вершина С имеет
индекс 1 - расстановка С,=(56,48, И). Расстановка фрагментов рес-
трикции В (42,16,38,8,+1), присутствовавшая в парных картах ВС от-
брасывается, так как она не присутствует в парных картах АВ.

Для построения множественной физической карты строится 1-дольный
мультиграф С, получающийся из С размножением каждой вершины А на
1псЦА) вариантов. Размножим каждую вершину А схемы эксперимента на
величину индекса 1пс1(А) и в каждой из полученных вершин укажем одну
расстановку ЗВ-фрагментов расщепления А (рис.5.12). Вершины мультиг-
рафа С соединяются дугой, если соответствующие ЗБ-расстановки сов-
местимы, т.е.образуют карту. Сдвиги и согласованности на этих дугах
определяются сдвигами и согласованностями соответствующих парных
карт.

Граф с определенными на вершинах потенциалами р и вращениями с
будем называть рс-графом.Подграф Н называется представительным подг-
рафом 1-дольного графа С, если он содержит ровно одну вершину в каж-
дой доле С и его порожденный подграф совпадает с С. Можно показать,
что существует взаимнооднозначное соответствие между кольцевыми фи-
зическимим картами и представительными рс-подграфами С, у которых
коциклические операторы на вершинах порождают сдвиги и согласован-
ности на дугах (аналогичное утверждение верно для линейных карт).
Следующие утверждения сводят проблему идентификации множественной
карты к поиску представительных подграфов:

1)	представительный рс-подграф С порождает кольцевую физическую
карту тогда и только тогда, когда коциклический оператор на его вер-
шинах определяет сдвиги и согласованности на его ребрах;

2)	подграф графа С порождает линейную физическую карту тогда и
только тогда, когда он является представительным.

Для поиска представительных подграфов можно использовать декомпо-
зицию С, связанную с перебором вариантов, начиная с рестриктаз, име-
ющих небольшое число различных положений фрагментов (им соответству-
ют доли С с небольшим числом вершин).

Пример построения множественной карты. Для графа С (рис.5.12)
возможны наборы расстановок ЗВ-фрагментов: Н1=(А1, В(, С]),
Н2=(А,, В2, С,). Для подграфа Н, потенциалы и вращения р(А1)=О,
р(В1)=98, р(С1)-О, с(А1 )=с(В1 )=с(С1)=1 порождают сдвиги и согласо-
ванности:

з(А,В)=р(В)-р(А)-98,
5(В,С)=р(С)-р(В)=4О,
з(С,А)=р(А)-р(С)=70,
и(А,В)=у(В,С)=ч(С,А)=1.

Так как эти значения совпадают с значениями на рис.5.12, то.рас-
становки А^В^С, порождают физическую карту (рис.5.13). Убедимся,
что подграф Н2 не порождает физической карты. Действительно, если бы
такая карта была, то она приводила бы к равенствам:

с(А1),с(В2)=ч(А1,В2)=1,
с(В2)-с(С1)=у(В2,С1)=1,
с(С,)-с(А1)=у(С1,А1)=1,

откуда следует, что или с(А,)=с(В2)=с(С,)=+1, или с(А,)=с(В2)=с(С,)=-1.

В первом случае (второй случай рассматривается аналогично) разности
потенциалов должны удовлетворять условиям (5.1):

р( А,, В2)=р(В2)-р(А, )=з(А,,В2)=98,
р(В2, С1)=р(С1)-р(В2)=з(В2,С1)=88,
р(С,, А, )=р(А,)-р(С,)=з(С1, А.)=70.

Из условия: сумма разностей потенциалов на замкнутом контуре равна
О, получаем

О=р(А,, В2)+р(В2, С,)+р(С,, А1)=256=48[гоос1 104].

Р и с.5.13. Множественная физическая
карта рестрикций А, В и С

Полученное противоречие показывает, что нельзя восстановить по-
тенциалы на графе Н2, и поэтому набор расстановок Н2 не порождает фи-
зическую карту.

Поэтапное построение физических карт. Важно отметить, что в
настоящее время до проведения биологического эксперимента, как пра-
вило, бывает неизвестно, какие рестриктазы предпочтительно использо-
вать для картирования, сколько нужно провести одиночных и совместных
расщеплений, какие дополнительные биохимические методы следует прив-
лечь. Метод потенциалов предоставляет возможности для рационального
планирования эксперимента, а также для поэтапного построения физи-
ческих карт (Певзнер,Миронов,1987а). Так, типична ситуация, когда
построено несколько допустимых карт, однако для однозначной иденти-
фикации реальной карты экспериментального материала еще недостаточ-
но. В этом случае на основании анализа построенных карт можно ука-
зать, какими опытами следует дополнить эксперимент, для того чтобы
установить реальную физическую карту. Данные дополнительных экспери-
ментов могут быть введены в ЭВМ для завершения расчетов. Возможности
поэтапного построения физических карт особенно важны при расчете
карт с большим числом сайтов, так как в этом случае перед началом
расчета трудно оценить, позволят ли экспериментальные данные одноз-
начно идентифицировать физическую карту.

5.5.	ФИЗИЧЕСКОЕ КАРТИРОВАНИЕ И МЕТОДЫ ДИСКРЕТНОЙ МАТЕМАТИКИ.

УТОЧНЕНИЕ ФИЗИЧЕСКИХ КАРТ

Физическое картирование как задача дискретной оптимизации.
Несмотря на то, что мы подробно обсудили алгоритмы построения физи-
ческих карт, математическая постановка задачи физического картирова-
ния еще не приводилась. Эта парадоксальная ситуация связана с тем,
что физическое картирование - сложная комбинаторная проблема, форму-
лировка которой не укладывается в схемы классических задач дискрет-
ной оптимизации (в большинстве работ по физическому картированию ав-
торы избегают четкой математической постановки этой задачи). Видимо,
отсутствие четких постановок привело к тому, что основные усилия в
области физического картирования направлены на совершенствование пе-
реборных схем (типа метода ветвей и границ) и различных эвристичес-
ких процедур, в то время как мощный аппарат дискретной оптимизации
при этом практически не используется. Несмотря на обилие алгоритмов,
предложенных для физического картирования, первые теоретические
оценки сложности этой задачи (в рамках теории сложности Кука-Кар-
па(Гэри,Джонсон,1982)) появились лишь в 1987 г. (СоИзФе1п, ДОаФегтап,
1987). Мы приведем одну из возможных постановок задачи физического
картирования (СоИзФешЛаФегшап, 1987), надеясь, что она привлечет
специалистов-математиков и позволит уяснить место физического карти-
рования в рамках задач современной дискретной оптимизации. Постанов-
ка является упрощенной - она применима только для линейных молекул
ДНК, двух рестриктаз А и В и отсутствия ошибок в измерении длин
фрагментов(более общая постановка приводится Певзнером(1987)).

Исходной информацией для физического картирования являются упоря-
доченные множества положительных чисел:
А={а;: 1-1,п},
В={Ь(: 1=1,т},
АВ={аЬ,: 1=1,к}

(упорядоченность означает, что а.^ при 1<) , аналогичные усло-
вия выполняются для множеств В и АВ).

Пусть р и р - перестановки элементов множеств А и В (пару <р,д)
будем называть конфигурацией). Перестановки р и ц задают множество:

з	1;

й={г: г= Е ар(1) или г= Е Ъд(1) , где 0<зйп, 0а1;<т}.

1=1	1=1

Упорядочим элементы В

й={г.: 1=1,к и г(<г. при 1<Л

и обозначим через АВ(р,р) множество разрезов, получающихся при рас-
смотрении конфигурации (р,ц)

АВ(р,ц)={аЬ1(р,ц): аЬ((р,ц)=г1_1 для некоторого 1<а<к}

(мы предполагаем, что множество АВ(р,ц) упорядочено, т.е.
а!г (р, р)<а!г (р, р) при !<,]). Задача физического картирования со-
стоит в отыскании конфигурации (р,ц), такой, что АВ=АВ(р,р).

Голдстейн и Ватерман (СоИзФехпДаФегтап, 1987) показали, что даже
в такой упрощенной постановке физическое картирование является
НР-полной задачей (Гэри, Джонсон,1982). Таким образом, возможность
построения эффективных(в смысле теории сложности Кука-Карпа) алго-
ритмов для физического картирования вызывает большие сомнения( из-
вестна гипотеза о том, что для ЫР-полных задач не существует полино-
миального по сложности алгоритма решения) и основные усилия здесь
следует сосредоточить на совершенствовании переборных схем.

Как уже отмечалось, при построении физических карт основными
являются следующие две задачи:

1)	оптимальная организация перебора гипотез о взаимном расположении
сайтов;

2)	Э1 фективная проверка и отбраковка гипотез о взаимном расположе-
нии сайтов!уточнение физических карт).

Обсуждавшиеся ранее проблемы отсутствия эффективных алгоритмов
и относятся к задаче 1, в то время как для задачи 2 в настоящее вре-
мя известны эффективные алгоритмы решения, опирающиеся, на глубокие
теоретико-графовые результаты. В этом параграфе обсуждается связь
проблемы физического картирования с двумя задачами дискретной опти-
мизации - поиском максимального потока в сети и оптимального контура
в графе, для решения которых известны эффективные комбинаторные ал-
178
горитмы (недавно Эллисон и Йи (А111зоп, Тее, 1988) предложили новый
подход к уточнению физических карт, опирающийся на теорию отделения
Шостака).

Гипотезы о расположении сайтов рестрикции и диаграммы. При ре-
шении задачи уточнения физических карт считается, что зафиксирована
гипотеза о порядке расположения сайтов рестрикций и следовании фраг-
ментов на молекуле ДНК. Каждой такой гипотезе соответствует диаграм-
ма Б (на рис.5.14 представлена диаграмма для линейной молекулы ДНК),
на которой указаны порядок следования сайтов и соответствующие длины
ЗБ- и ББ-фрагментов (при этом координаты сайтов не указываются). Фи-
зическая карта М (рис.5.14) дает информацию о порядке следования
сайтов и о координатах - расстояниях каждого сайта от начальной точ-
ки. Всякая физическая карта М порождает некоторую диаграмму Би, в
качестве длины фрагментов на этой диаграмме используются расстояния
между между соответствующими сайтами. Однако обратное утверждение
неверно: не по всякой диаграмме можно построить физическую карту,
например, по диаграмме Б нельзя построить физической карты, так как
уже для первых двух фрагментов рестрикции В: 8+15^24. Поэтому воз-
никает вопрос о построении физической карты, наилучшим образом приб-
лижающей диаграмму - это и есть задача уточнения физических карт.

В качестве меры расхождения между диаграммой и физической картой
рассматривается равномерная норма, т.е. если длины фрагментов диаг-
раммы представлены вектором Б=(й1,..., ), а длины фрагментов фи-
зической карты - вектором М=(ш1,... ,ше), то под отклонением физи-
ческой карты М от диаграммы Б понимается

шах | <1 -ш |
1=1, Ф

(в векторах Б и М представлены в некотором порядке длины фрагментов
ЗБ- и ББ-рестрикций). Задача уточнения физической карты состоит в
отыскании по Диаграмме Б физической карты М*, дающей решение сле-
дующей минимаксной задачи:

гаах |а.-т.*1= ш!п тах |<1.-т.1,
1=1,Ф	М 1=1,Ф

где минимум берется по всевозможным физическим картам М. Физическая
карта М* называется оптимальным представлением диаграммы Б (на
рис.5.14 карта М - оптимальное представление диаграммы Б).

Выбор равномерной нормы в большей степени соответствует реальной
задаче картирования, чем, скажем, выбор евклидовой нормы I2:

( Е (Д.-ш. )2)1/2.

1=1,Ф ' '

Дело в том, что использование евклидовой нормы не отбраковывает ва-
рианты со значительным отклонением от экспериментальных значений на
одном-двух фрагментах. Эти варианты не должны рассматриваться, так
как значительные отклонения хотя бы на одном фрагменте недопустимы
при построении физических карт. В приведенной модели задачи уточне-
ния физических карт ошибки в определении размеров фрагментов счита-
ются равными. Различные уровни ошибок в определении размеров фраг-

ментов легко учесть внесением в эту модель дополнительных весовых
коэффициентов.

Р и с. 5.14.Диаграммы и физические карты

В - диаграмма(цифры показывают размеры фрагментов); М - физическая
карта ( цифры показывают расстояния от сайтов рестрикции до начала
молекулы ДНК; Вм - диаграмма, построенная по физической карте М;
С - граф для задачи о минимальном в среднем цикле, построенный по
диаграмме Б

Р и с.5.15.Построение

рестрикционного графа по диаграмме

Рестрикционные графы. Всякой диаграмме можно поставить в соот-
ветствие рестрикционный граф 0 с пропускными способностями дуг (не
путать с ранее вводившимися интервальными графами) . Построение гра-
фа 0 проведем в три этапа (на рис.5.15 показан процесс построения
рестрикционного графа, соответствующего диаграмме на рис.5.14).

1.	Построим трехдольный ориентированный граф О' (рис.5.15) с до-
лями:

А - множество ББ-фрагментов рестрикции А;

В - множество БВ-фрагментов рестрикции В;

АВ - множество ВВ-фрагментов.
Из вершины V верхней доли А проведем дугу (V, V?) в вершину я средней
доли АВ, если БП-фрагмент V содержит ПП-фрагмент V. Аналогично в
вершину V нижней доли В проведем дугу (уг.у) из вершины V средней до-
ли АВ, если БВ-фрагмент V содержит ВВ-фрагмент V.

2.	Граф С' преобразуем в граф 0" (рис.5.15), заменив каждую вер-
шину дугой, пропускная способность которой равна длине соответствую-
щего фрагмента.

3.	Для завершения формирования рестрикционного графа 0 добавим к
графу С-'' (рис.5.15) две вершины - источник 5 и сток Ф - и соединим
источник з с началами всех дуг, соответствующих БВ-фрагментам А, а
все концы дуг, соответствующих БВ-фрагментам В, соединим со стоком
ф. После этого добавим в граф последнюю дугу (Ф,з)(эти преобразова-
ния делаются для сведения задачи уточнения физических карт к класси-
ческой задаче о циркуляции).

Описанный процесс позволяет строить рестрикционные графы по диаг-
раммам как линейных, так и кольцевых молекул и обобщить понятие рес-
трикционного графа для случая трех рестриктаз, учета информации о
недорестрикциях и т.д. (на рис.5.16 приведен пример построения рест-
рикционного графа кольцевой молекулы для трех рестриктаз).

Циркуляции в рестрикционных графах(,). Каждому ВВ-фрагменту физичес-
кой карты, согласующейся с нашей гипотезой о порядке следования
сайтов рестрикции, соответствует некоторая дуга в графе 0. Можно по-
казать, что через эту дугу в графе С проходит ровно один ориентиро-
ванный цикл. Взвешенная сумма таких циклов (в качестве веса цикла
используется длина соответствующего фрагмента) дает циркуляцию в С.
Таким образом, каждой физической карте, согласующейся с принятой ги-
потезой о порядке следования сайтов, можно поставить в соответствие
циркуляцию в 0. Обратно, если дана циркуляция в 0, то она однозначно
определяется значениями на дугах, соответствующих ЦП-фрагментам (это
следует из того, что всякий ориентированный цикл в 0 проходит через

Р и с.5.16. Построение рестрикционного графа по диаграмме кольцевой
молекулы для трех рестриктаз
некоторую ВВ-дугу и через каждую такую ВВ-дугу проходит ровно один
цикл). По значениям на ВВ-дугах, в свою очередь, однозначно строится
соответствующая физическая карта (координата 1-го сайта рестрикции

на ней равна Е Г., где Г, - поток по ,]-й ВВ-дуге графа С).

3=1,1

Таким образом, установлено взаимооднозначное соответствие между
физическими картами и циркуляциями в С (заметьте, что при таком под-
ходе поток по дуге (Ф,з) определяет общую длину молекулы ДНК). Так
как физическим картам соответствуют циркуляции, для отыскания опти-
мального представления диаграммы физической картой необходимо найти
циркуляцию в сети С (графы с пропускными способностями дуг в дис-
кретной оптимизации принято называть сетями), наилучшим образом при-
ближающую пропускные способности дуг,т.е. циркуляцию, минимизирующую

тах |<1( V,чг)-Г(V, чг) |,

(V, «г)

где <3(V,V) - пропускная способность дуги (ч,«г), а Цу,я) - поток по
дуге (ч,гс) (максимум в формуле берется по дугам, на которых опреде-
лена пропускная способность).

Для решения этой задачи введем нижние и верхние пропускные спо-
собности на дугах по правилу

й'( V, «г)=(1(7, *г)-Ф ; б+( V, »)=(!( V, «г)+ф

(для дуг (ч,»), на которых ранее пропускная способность не определя-
лась, положим б‘(ч, «г)=0, й*(у,»)=«> )).

В этом случае существование физической карты, отклонение которой
от диаграммы не превышает Ф , эквивалентно существованию циркуляции
в сети с нижними и верхними пропускными способностями й" и сР.

Уточнение физических карт и теорема Гофмана(,). Для циркуляций в
сети с двухсторонними ограничениями пропускной способности верна
следующая

Теорема Гофмана(Форд,Фалкерсон, 1966): циркуляция в графе С с
двусторонними ограничениями пропускной способности существует тогда
и только тогда, когда для любого подмножества X вершин графа выпол-
няется

(Г(Х,Х) > сГ(Х,Х)

(здесь с!*(Х,Х) - суммарная верхняя пропускная способность прямых
дуг разреза (Х,Х), а й'(Х,Х) - суммарная нижняя пропускная спо-
собность обратных дуг разреза (Х,Х) ).

Определим дефицит сети как ВЕ= тах (сГ(Х,Х)-сГ(Х,Х)). Если в
сети с двухсторонними ограничениями пропускной способности не
182
существует циркуляции, то по теореме Гофмана ВЕ>0. Как уже отмеча-
лось, в реальной ситуации, как правило, не существует физической
карты, в точности соответствующей диаграмме, поэтому при 1=0 (в этом
случае функции й" и й* совпадают и равны й) найдется множество X,
такое, что

й(Х,Х) > й(Х,Х)

и дефицит сети ВР>0. Значение БЕ может быть определено с помощью ал-
горитма вычисления максимального потока в некоторой сети специально-
го вида (Форд, Фалкерсон,1966). Множество X, на котором достигается
дефицит сети, позволяет локализовать фрагменты, на которых принятая
гипотеза дает "максимальные" противоречия (на рис.5.15 для графа С
выделено множество X из 6 вершин, дающее максимальный дефицит: сумма
пропускных способностей по его обратным дугам равна 20+18, а по пря-

мым - 15+19. Следовательно, ВЕ=38-34=4). При возрастании I й_(Х,Х)
уменьшается , а й*(Х,Х) увеличивается для любого множества X. Та-
ким образом, дефицит сети БЕ(Ф) - убывающая функция. Можно показать,
кроме того, что БЕ(1;) - кусочно-линейная выпуклая вверх функция,
число звеньев которой оценивается как 0(г), где г - число сайтов
рестрикции. Как уже отмечалось, ВЕ(0)>0 для реальных диаграмм. Обоз-
начим через Фо точку, в которой ВЕ(Ф) обращается в 0, при таком Фо,
по теореме Гофмана, впервые появляется возможность построить
циркуляцию в сети с двухсторонними ограничениями, и, следовательно,
Фо дает минимальное отклонение исходной диаграммы от физической
карты, а соответствующая циркуляция порождает физическую карту, яв-
ляющуюся оптимальным представлением диаграммы,

В результате задача уточнения физической карты свелась к нахож-
дению и построению циркуляции в соответствующей сети. Заметим, что
функция ВР(Ф), вообще говоря, неизвестна, однако ее значение в любой
точке можно вычислить путем решения задачи о максимальном потоке в
сети. Задача нахождения точки пересечения таких функций с прямой
(нас интересует пересечение графика функции БЕ(Ф) с прямой БР=0)
рассматривалась в работе Певзнера(1979), и для ее решения был пред-
ложен алгоритм, число этапов которого не превышает числа звеньев ку-
сочно-линейной функции.

Таким образом, решение задачи уточнения физических карт свелось
к серии итераций, на каждой из которых находится максимальный поток
в сети. Так как для решения последней задачи известны эффективные
полиномиальные алгоритмы (Адельсон-Вельский и др.,1975), предложен-
ный метод позволяет решать задачу уточнения физических карт практи-
чески при любом числе фрагментов.
Уточнение физических карт и задача об оптимальном контуре в гра-
фе(,). Рассмотренный подход устанавливает связь между потоковыми
алгоритмами и физическими картами при числе рестриктаз к<3, но уже
при к=4 не удается построить потоковую сеть, сводящую задачу уточне-
ния физических карт к построению циркуляций. В этом случае предлага-
ется более универсальный подход: сведение задачи построения физичес
ких карт к задаче об оптимальном контуре в графе(Романовский,1977).
Для ориентированного графа 0(7,Е) с весами на дугах 1(е) будем обоз-
начать через 1(С) длину цикла С с учетом ориентаций дуг,а через й(С)
- число дуг в С . Например, для цикла, составленного из жирных дуг’
на рис.5.14: 1(0=20+18-19-15=4,(1(0=4. Обозначим

1^„=ш1п 1(0,

1т1а=т1п 1(С)/а(С)

(минимум берется по множеству всех простых циклов графа).

Задача определения 1т1п известна как задача поиска минимального
цикла в графе, она относится к классу №. Задача определения 1т1<1
известна как задача определения оптимального контура в графе, и для
нее в отличие от задачи о поиске минимального цикла известны эффек-
тивные алгоритмы (Кагр,1978; Карзанов,1985).

Оказывается, что задача уточнения физической карты (при произ-
вольном числе рестриктаз) сводится к поиску оптимального контура в
графе специального вида. На рис. 5.14 приведен взвешенный ориентиро-
ванный граф, построенный по диаграмме - каждому сайту рестрикции на
диаграмме (а также началу и концу линейной молекулы) соотвествует
вершина в С, две вершины соединяются дугой веса 1, если расстояние
между соответствующими сайтами на диаграмме известно и равно 1.

Всякая физическая карта М, построенная по диаграмме В , описы-
вается функцией р на множестве вершин графа С ( р(г) - расстояние от
сайта, соответствующего вершине V, до начальной точки). Физическая
карта М порождает диаграмму Вм, которой соответствует граф С(У,Е) с
весами дуг Г(V,«)=р(«)-р(у).

Таким образом, отклонение физической карты М от диаграммы В да-
ется формулой:

шах | р(V»)-р( V)-1 (V,т») |

(у,»)еЕ

и задача уточнения физической карты состоит в поиске неотрицательной
функции р на V, на которой достигается минимум
ш1п тах | р(ш)-р(у)-1(у,«)|.

(5.3)

р (у,«)еЕ

Эту задачу можно сформулировать, как задачу линейного программирова-
ния. Если добавить в граф 0 |Е| новых дуг, вводя для каждой дуги
(у,») веса	антипараллельную дугу (»,и) веса -1(V,ш), то зада-

чу (5.3) можно преобразовать к виду :

ш1п тах	( р(»)-р(у)-1(у,ш))

р	(у,«)еЕ'

(через Е' обозначено новое множество дуг мощности 2|Е|). Эта задача
эквивалентна следующей задаче линейного программирования:

УуеУ: р(у)>0,

У(у,»)еЕ': р(у)-р(»)-1 <1(у,ш),

—> пип.

Вводя двойственные переменные §(у,») и переходя к двойственной зада-
че, получим

У(у,«)еЕ':	б(ч,«)>0 ,

УчеУ:	Е	”	2	ё(*,71-0 ,

(у.ш)еЕ'	(»,у)еЕ'

Е я(у,»)=-1 ,

(у,»)еЕ'

Е 2(у,»г)'1(у,«) --> тах .

(у,«)еЕ'

Последняя задача: постановка задачи об оптимальном контуре(или о ми-
нимальном в среднем цикле в графе) в форме задачи линейного програм-
мировать Романовский, 1977)

У(у,»)еЕ':	,

УчеУ:	2	- Е	,

(у,«)еЕ'	(«,у)еЕ'

Е 2(у,»)=1 ,
(у,«)еЕ'

Е е( V, ») • 1 ( V, V) --> Ш1П .

(V, ?г)еЕ'

Использование алгоритма Карзанова(Карзанов,1985) для минимизации
этого функционала дает возможность одновременно с построением опти-
мального контура получить также решение задачи об уточнении физичес-
кой карты.

5.6.	ДОПОЛНИТЕЛЬНЫЕ БИОХИМИЧЕСКИЕ МЕТОДЫ И СТРАТЕГИЯ КАРТИРОВАНИЯ

При картировании больших геномов и построении подробных физичес-
ких карт необходимо привлекать дополнительные методы. Мы рассмотре-
ли методы физического картирования, основанные на анализе результа-
тов одиночных и совместных рестрикций. При этом подходе эксперимен-
тальная работа сводится к минимуму, однако построение карты по такой
косвенной информации вызывает большие математические трудности, ко-
торые не всегда удается преодолеть (при значительном числе сайтов
рестрикции и ошибках в определении размеров фрагментов). Дополни-
тельные биохимические эксперименты по картированию позволяют за счет
дополнительной экспериментальной работы снять некоторые математичес-
кие проблемы. Даже в тех случаях, когда математические проблемы уда-
ется преодолеть, при картировании больших геномов, как правило, воз-
никает несколько физических карт, согласующихся с экспериментальной
информацией - снять эту неоднозначность удается только при использо-
вании дополнительных биохимических экспериментов.

В предыдущих разделах уже затрагивался вопрос об оптимальном пла-
нировании экспериментов по картированию при минимизации числа элект-
рофорезов, необходимых для однозначной идентификации физической кар-
ты. Однако при картировании больших геномов вычислительные трудности
столь велики, что даже анализ данных о многих рестрикциях не дает
возможности построить физическую карту. В этих случаях необходимо
выбрать стратегию картирования: набор и последовательность дополни-
тельных биохимических методов, приводящих к построению физической
карты при минимальной экспериментальной работе.

Возможности дополнительных биохимических методов картирования.
В этом разделе кратко описаны некоторые дополнительные методы, ис-
пользующиеся при картировании.

1.	Разрезание отдельных фрагментов рестрикции А рестриктазой В.
Обычно при этом используется двумерный гель-электрофорез: 5Л- фраг-
менты рестрикции А сначала разделяются в первом направлении , затем
разрезаются рестриктазой В и получившиеся ВВ-фрагменты разделяются
во втором направлении. Этот метод позволяет резко сократить вычисли-
тельные сложности при поиске вилок и вложений - лимитирующих этапах
при построении парных карт.

2.	Гибридизация по Саузерну. Гибридизация по Саузерну позволяет
получить информацию о перекрывании фрагментов различных рестрикций и
"обойти" этапы поиска вилок и вложений, перейдя сразу к построению
рестрикционной карты по интервальному графу (разд. 5.3). Помимо это-
го для получения информации о перекрывании фрагментов могут быть ис-
пользованы помеченные пробы (например, высокоповторяющиеся рассеян-
ные последовательности ДНК при физическом картировании эукариот).

3.	Линеаризация кольцевых ДНК. Для линеаризации кольцевой ДНК
нужно найти рестриктазу с уникальным сайтом. В случае больших коль-
цевых ДНК (например, космид) поиск такой рестриктазы представляет
проблему, однако ее можно пытаться решить с помощью специфического
разрезания по соз-последовательности (Каск»Иг еФ а!., 1985).

4.	Недорестрикция ДНК. Недорестрикция ДНК достигается подбором
времени инкубации и количества фермента, при этом для выбора уровня
недорестрикции могут применяться различные методы, в частности раз-
резание ДНК в присутствии бромистого этидия, блокирующего реакцию
после разрезания первого сайта . Использование недорестрикции позво-
ляет получить информацию о смежных фрагментах на молекуле ДНК и сок-
ратить число допустимых парных карт.

5.	Концевая метка. Использование концевых ме-
ток(5т!Ф11,В1гпзФа11,1976) позволяет определить расстояния от сайтов
рестрикции до помеченного конца молекулы и значительно облегчает оп-
ределение положения нескольких сайтов рестрикции, близких к помечен-
ному концу. Однако при значительной общей длине молекулы ДНК этим
методом не удается определить положения сайтов в середине молекулы,
так как соответствующие им фрагменты выходят за предел шкалы марке-
ров, что приводит к невозможности их разделения. При использовании
концевых меток с двух концов линейной молекулы возникают трудности
при совмещении координат сайтов с правого и левого конца. Зехетнером
и др.(ХейеФпег еФ а1.,1987) разработан специальный метод "гребенки"
для проведения такого совмещения.

Разработка математического обеспечения для поддержки дополни-
тельных биохимических экспериментов. Расширение работ по физичес-
кому картированию и секвенированию больших геномов требует разработ-
ки специальных программ, позволяющих минимизировать эксперименталь-
ную работу при построении физических карт. В имеющемся в настоящее
время математическом обеспечении возможности учета информации о до-
полнительных биохимических экспериментах очень ограничены (Ро1пег еФ
а1.,1984; 2ейеФпег еФ а1.,1987). В настоящее время актуальной явля-
ется разработка алгоритмов и программ физического картирования, под-
держивающих все рассмотренные дополнительные биохимические методы
(2еЬеФпег еФ а1.,1987), а также дополнение программ физического кар-
тирования программами манипулирования физическими картами и сравне-
ния физических карт (АЬгетзку,^агй,1986; №еита1ег,1986; 2ейеФпег,
Ье11гас11,1986).
5.7.	ЗАКЛЮЧЕНИЕ

Физическое картирование - один из самых популярных методов ана-
лиза ДНК. Сложный комбинаторный характер этой задачи и вычислитель-
ные трудности при прямом переборе вариантов требуют привлечения ме-
тодов дискретной математики для построения физических карт. В насто-
ящее время физическое картирование - один из немногих разделов
компьютерной генетики, где удалось "заставить" работать серьезные
результаты из разных областей математики(теории графов, потоков в
сетях, эргодической теории и др.). Программы построения физических
карт - одна из необходимых и наиболее трудоемких составляющих совре-
менных пакетов программ по молекулярной генетике. Узким местом при
разработке методов физического картирования остается этап построения
парных карт (задачи построения множественных карт и уточнения карт
можно считать решенными) - по-видимому, дальнейший прогресс в этой
области будет связан с использованием аппарата дискретной оптимиза-
ции. В связи с планирующимися масштабными работами по физическому
картированию в рамках секвенирования генома человека особую актуаль-
ность приобретают задачи оптимального планирования экспериментов,
привлечения информации о дополнительных биохимических экспериментах
и разработка принципиально новых методов картирования. В последние
годы был проведен ряд работ по крупномасштабному физическому
картированию ( Сои1зоп еФ а!., 1986; 01зоп еФ а1.,1986,’ КоНага еФ
а1.,1987,‘ Ьапбег ДаФегтап, 1988; 5и1зФоп еФ а!., 1988) и тесно
связанному с ним мегабазному секвенированию ДНК ( Пысов и др., 1988,’
Вгтапас еФ а1.,1989,’ Речгпег, 1989).
Глава 6. МЕТОДЫ ПРЕДСКАЗАНИЯ
ВТОРИЧНЫХ СТРУКТУР РНК

6.1.	ПРОБЛЕМА ОПРЕДЕЛЕНИЯ ВТОРИЧНЫХ СТРУКТУР РНК

Молекула РНК представляет собой однонитевую полимерную цепочку. Об-
наружено, однако, что в процессе синтеза молекулы комплементарные
участки в цепи находят и связываются друг с другом. В результате обра-
зуются двунитевые спиральные фрагменты.Совокупность таких спиральных
участков и однонитевых отрезков составляет вторичную структуру РНК.

В настоящее время накоплено много информации о биологической роли
вторичной структуры. Так, для транспортных РНК структура типа "клевер-
ный лист" необходима для узнавания ее соответствующими ферментами и
рибосомами. Вторичная структура рибосомных РНК обусловливает самосбор-
ку и функционирование рибосом. Имеется очень много указаний на роль
вторичной структуры мРНК в трансляции. Ниже будет показано, что поло-
жение инициирующего триплета в структуре может оказать решающее влия-
ние на частоту инициации трансляции. Анализ вторичной структуры мРНК
позволяет объяснить также регуляцию транскрипции с помощью аттенюации,
процесс сплайсинга интронов, явления транскрипционных пауз и термина-
ций. Таким образом, знание вторичной структуры РНК является необходи-
мым для понимания процессов,происходящих в клетке. В связи с этим воз-
никла проблема предсказания вторичной структуры молекулы РНК.

Эта задача, как она понимается в настоящее время, заключается в оп-
ределении существующей в структуре совокупности спиральных участков.
Для решения этой задачи необходимо рассмотреть все возможные спираль-
ные участки, проанализировать возможность их совместного существования
и выбрать наилучшую структуру. Как считает М.Эйген (1973), природа са-
ма поступает подобным образом с нуклеотидной последовательностью, пе-
ребирая различные варианты, разыгрывает партию в игре, которую он наз-
вал " игра в тРНК или как делать клеверные листья".

Наша задача - попытаться понять правила игры или правила отбора
структур. В первое время для выбора наилучшей структуры использовался
критерий комплементарности - преимуществом обладала структура с наи-
большим числом комплементарных пар оснований. Затем правила отбора
усовершенствовались, и на следующем этапе исследования вторичной
структуры РНК в качестве критерия стали использовать свободную энер-
гию. Стратегия поиска и отбора вторичных структур может быть различна.

В этой главе рассматриваются основные алгоритмы предсказания вто-
ричных структур РНК. Можно выделить четыре основных подхода: 1) комби-
наторный, в котором просчитывают различные варианты взаимного располо-
жения спиралей; 2) индуктивный, в котором используются методы динами-
ческого программирования; 3) кинетический, в котором пытаются модели-
ровать процесс формирования вторичной структуры РНК; 4) филогенетичес-
кий и ферментативный, при помощи которого из различных эксперименталь-
ных данных и сопоставления результатов анализа гомологичных РНК опре-
деляют спиральные участки во вторичной структуре.

6.2.	ТОПОЛОГИЧЕСКИЕ УСЛОВИЯ И ТЕРМОДИНАМИКА ОБРАЗОВАНИЯ
ВТОРИЧНЫХ СТРУКТУР РНК

Условия совместимости спиралей. Возможные элементы вторичной струк-
туры РНК представлены на рис.6.1. Двутяжевый спиральный участок, или
для краткости спираль, состоит из нескольких комплементарных пар, в
которых нуклеотиды образуют классические Уотсон - Криковские А-П и С-С
связи, а также С-П связь.Наличие С-0 связи было экспериментально уста-
новлено, правда, при этом нужно учитывать, что связь между этими нук-
леотидами непрочная и пара С-П может находится только внутри спирали,
стабилизируемая стэкинг взаимодействиями соседей. Одноцепочечные учас-
тки характеризуются тремя типами петель и свободными З'и 5' концами
цепи.

Р и с. 6.1. Возможные элементы
вторичной структуры РНК

I	- петля-шпилька;

II	- спиральный участок;

III	- внутренняя петля;

IV	- боковая петля

Рассмотрим теперь условия совместного существования спиральных
фрагментов во вторичной структуре.Условия топологической совместимости
спиралей представленны на рис. 6.2,а. В этом случае спирали могут од-
новременно полностью присутствовать в структуре. Нет очевидных тополо-
гических препятствий и для образования спиралей, изображенных на
рис.6.2,б, однако практически во всех теоретических исследованиях не
допускается образования такой узловой структуры. Это связано прежде
всего с ее явной энергетической невыгодностью. Действительно, для об-
разования такого узла необходимо соблюдение очень жестких требований к
пространственному расположению нуклеотидов, что крайне невыгодно ска-
жется на энтропийном вкладе в свободную энергию.
Анализ вторичной структуры показал, что возможно и другое взаимное
расположение спиралей (51ш1п1ска е! а!., 1978; Миронов, Кистер, 1989).
При этом, как нетрудно убедиться из рис.6.3, обе спирали могут однов-
ременно существовать, но только одна из них или обе будут не полными.
Как видно иэ рисунка, часть оснований одной спирали комплементарна ос-
нованиям другой спирали, поэтому с равной вероятностью в структуре мо-
гут присутствовать пары или одной, или другой спирали. Этот переход
изоэнергетический, поскольку замена на эквивалентную пару не влияет ни
на энергию спирального участка, ни на энергию неспирального фрагмента.

Рис. 6.2. Два типа возможных рас-
положений топологически полностью
совместимых спиралей

а - расположение спиралей в
структуре; б - узловая структура

Б' — ссиссслАсссиссиссииассссАсс — з'

Рис. 6.3. Расположение топологи-
чески совместимых спиралей I и II, <5
при котором, однако, они не могут
полностью одновременно находится в
структуре

а - в потенциальных спиралях I и
II (отмечены стрелками) часть нук-
леотидов комплементарны нуклеотидам
другой спирали; б - одновременное
существование двух спиралей I и II,
разделенных "блуждающей" боковой
петлей

1	11 Л'и

5' — с-с-и-с-с-с-л-л-с-с' Ч
3'- с-с-А-с-с^-и-с-с^/

1	11 С'Ч1

б — а-с-и-с-с-с-а-А-с-сг Ч

1 11
5' — С-С-и-С-С-С-А-А-С-С' Ч.
з* — с-с-А-с^с^с-и-и-с-Очи сх

Понятно, что такие переходы возможны только если сохраняется часть
спирали, т.е. остается неизменной структура петель. При сосуществова-

нии двух подобных спиралей между ними образуется флуктуирующая, сколь-
зящая петля. При замене пары из одной спирали на пару из другой спира-

ли петля перемещается, и спирали как бы перетекают друг в друга
(рис.6.3,6).

Возможность сосуществования в структуре подобных спиралей и посто-
янных переходов между ними является очень важным обстоятельством и

заставляет по-новому рассматривать вторичную структуру РНК. По-видимо-

му, нельзя теперь представлять ее как статический набор спиралей со
строго фиксированными параметрами. Наличие вторичной структуры РНК
предполагает постоянный динамический процесс с непрерывно изменяющими-
ся спиральными участками. Возможно, эта одна из причин трудностей при
кристаллизации этой, как бы дышащей, молекулы.
Силы, стабилизирующие вторичную структуру РНК. Для определения ста
бильности спиралей нуклеиновых кислот биологи вначале использовали,
можно сказать, визуальный, статистический метод - оценивали на глаь
содержание С-С и А-П пар в спирале. Это казалось вполне подходило для
качественных выводов, однако в 1963 г. Чемберлен с соавт. (СЪатЬегИг.
е! а1., 1963) четко показали на синтетических полимерах влияние после-
довательности оснований на стабильность. Энтальпия спирали, имеющей,
например, две С-С пары, будет очень сильно разнится в зависимости от
того, являются ли эти пары ближайшими соседями или между ними располо-
жена А-П пара. Чтобы объяснить этот результат, надо учесть так называ-
емые вертикальные или стэкинг-взаимодействия.

Одна из первых попыток оценить взаимодействия между основаниями в
двухспиральной структуре была предпринята в работе Де Во и Тиноко в
1962 г.(Се Уое, Т1посо, 1962). Результат этой работы казался в ту пору
немного неожиданным.Наибольший вклад в стабильность спирали давали не
водородные связи, соединяющие комплементарные основания, благодаря ко-
торым и образуется двойная спираль, а ван-дер-ваальсовы силы, действу-
ющие в стопке между основаниями. Впоследствии во многих работах более
точно оценивались стэкинг-взаимодействия (РиНшап, 1968), но общий вы-
вод о преимущественном значении этих сил оставался неизменным. Из всех
работ следовал еще один существенный вывод о том, что для оценки ста-
бильности спирали достаточно учесть взаимодействия только между бли-
жайшими основаниями - так называемая модель ближайших соседей. Это
заключение сделало реальным возможность экспериментально оценить тер-
модинамические параметры, характеризующие стабильность спирали.

Термодинамика образования спиралей исследовалась с помощью оптичес-
ких и калориметрических методов (см..например,Кантор, Шиммел, 1984). К
сожалению, определение энтальпии и энтропии чувствительно к тому, ка-
ким способом проводились измерения. Различия могут достигать 50
ккал/моль. Однако различия в величинах свободной энергии, определенной
разными способами, значительно меньше, возможно, благодаря тому, что
расхождения энтальпии и энтропии компенсируют друг друга. Так, напри-
мер, из результатов, представленных в работе (Вогег е! а!., 1974),
видно, что для олигонуклеотида А7П7 величины свободной энергии образо-
вания спирали, полученные разными методами в интервале от 25 до 50 ,
отличаются не более чем на 1 ккал/моль.

Определение термодинамических параметров. Определение термодинами-
ческих параметров обычно проводится из данных по плавлению олигонукле-
отидов. Анализ кривых плавления коротких двуспиральных фрагментов поз-
воляет получить термодинамические характеристики в зависимости от пос-
ледовательности оснований. При помощи дисперсии оптического вращения
(используются также другие спектроскопические методы, а также протон-
ный магнитный резонанс) можно получить кривые зависимости поглощения
при изменении температуры. Сравнивая кривые поглощения одно- и двуспи-
192
ральных олигонуклеотидов, можно определить Г - долю спаренных основа-
ний. Из этой величины можно получить Кс - константу равновесия обра-
зования двуспирального фрагмента (Вогег еф а!., 1974)

21
К =-------------,

(1-1)2С

где С - общая концентрация олигонуклеотидных нитей.

Это уравнение описывает ситуацию, когда в растворе находятся одина-
ковые молекулы РНК с комплементарными участками в цепи. Изменение
стандартной свободной энергии при образовании спирального участка в
этом случае равно

бС° = -КТт1пС,

где Тт - температура, при которой 1=1/2. Из уравнения Вант-Гоффа можно
определить энтальпию этого процесса:

В а(1п С)
6Н° =	----------- .

б (1/Ти)

Таким образом, из данных по плавлению РНК, построив кривые зависи-
мости 1/Тт и 1пС, можно получить полный набор термодинамических пара-
метров - свободную энергию, энтальпию и энтропию образования спирали.

Инициация образования спиралей. Обязательным условием при образова-
нии первой инициирующей пары спирали является образование петли. Раз-
личные типы петель представлены на рис.6.1. Термодинамика образования
петель была подробно исследована в работе (ШПепЬеск еФ а1.,
1973;Сга11а, Сгойегз, 1973).

Стандартную энтальпию процесса образования петли - Н° можно вывести
из уравнения Вант-Гоффа:

Е" = 4КТп2 (1П/Т),

где I - доля петель в системе; Тт - температура, при которой 1п=0,5.

Стандартная свободная энергия равна 0 при Тт и, следовательно, 3° -
стандартная энтропия образования петли равна

3°=Нп/Тт.

Свободная энергия образования петли - это фактически свободная энер-
гия инициации спирали. На этапе инициации цепь сворачивается сама на
себя, сближая комплементарные основания таким образом, чтобы между
ними могла возникнуть водородная связь. Это приводит к образованию
петли. Фиксирование оснований, скрепляющих шпильку,приводит к умень-
шению энтропии и тем самым к увеличению свободной энергии петли.

Свободную энергию инициации - Си- можно представить в виде

С„=-КТ-1п р„ ,

где рп - вероятность образования петли из п неспаренных оснований.

Инициация спирали не зависит ни от величины спирали и последова-
тельности нуклеотидов в ней (что в общем очевидно), ни от того, какого
типа пара А-П или С-С является инициирующей. Величина рп зависит от
числа оснований в петле, с уменьшением и образование петли становится
более вероятным. При больших и менее вероятна встреча комплементарных
оснований. В оптимальном случае в петле-шпильке находятся 7- 8 основа-
ний, при дальнейшем уменьшении петли становятся значительными стери-
ческие препятствия. Анализ на пространственных моделях показал, что в
полирибонуклеотидах невозможно образование петли с двумя основаниями,
однако в боковой петле может находится даже одно основание.

Термодинамические параметры для расчета свободной энергии вторичной
структуры. Среди первых исследований, в которых оцениваются термодина-
мические параметры, отметим работу 1971 г.(Т1посо е! а1.,1971),а среди
последних - работу 1986 г.(Рге!ег е! а1.,1986). Причина столь долгого
и кропотливого анализа термодинамических параметров заключается в сле-
дующем: для того чтобы иметь полный набор параметров, описывающих все
возможные вторичные структуры, в руках исследователей должны быть об-
разцы этих вторичных структур. Отметим, что даже в рамках модели бли-
жайших соседей число таких вариантов весьма значительно, поскольку оно
включает не только все возможные сочетания пар оснований в спирали,
учет различных петель, но и анализ допустимых в структуре РНК дефектов
- внутренних и выпуклых петель.

В работе (За1зег, 1977) были рассмотрены многие варианты образова-
ния вторичной структуры. Полученные величины свободной энергии до пос-
леднего времени были основными параметрами, на которых основывались
расчеты по предсказаниям вторичных структур РНК. Однако недостаточное
число экспериментальных данных не позволило получить полностью согла-
сованные друг с другом величины и их использование в ряде случаев мог-
ло привести к неудовлетворительным результатам. Так, например, при ис-
пользовании этих параметров не всегда удавалось получить структуру ти-
па "клеверный лист" для тРНК. Не удавалось также согласовать рассчиты-
ваемую вторичную структуру 53 рРНК с хорошо установленными эксперимен-
тальными данными.

Поэтому Нинио с соавт. (Рарап1со1аи еФ а!., 1984) предпринял попытку
подогнать параметры Сэлсера для расчета этих молекул. Подгонка была
сделана с помощью метода "проб и ошибок". Сравнение параметров, полу-
ченных таким не совсем корректным образом, с величинами, выведенными
13 экспериментальных данных, подтвердило вывод о том, что параметры
’элсера не описывают большое число структурных особенностей вторичной
:труктуры. Необходимо было дополнительно ввести ряд эмпирически расс-
читанных параметров.

Только в последние годы в связи с успехами в синтезе олигонуклео-
тидов появилась возможность детально рассмотреть все структурные
зозможности молекулы РНК. В работе (Рге1ег еФ а1.,1986) на основании
хнализа термодинамических данных для 45 олигонуклеотидов были рас-
считаны, как пишут сами авторы, "улучшенные" параметры, описывающие
трактически все возможности вторичной структуры. Они пришли на сме-
чу так называемым параметрам Сэлсера. Для специалистов весьма убеди-
тельно выглядит сравнение этих параметров, которые провели сами ис-
:ледователи. Для 142 нуклеотидных последовательностей тРНК были пред-
сказаны с помощью метода, предложенного в работе (2икег, 511е§1ег,
.981), вторичные структуры. При использовании улучшенных параметров в
32% случаев были рассчитаны структуры типа "клеверный лист", в то
зремя как с параметрами Сэлсера только в 62% случаев были предсказаны
подобные структуры.

Таблица 6.1

Изменение свободной энергии
при образовании различных типов петель

Число нуклеотидов в петле	Внутренняя петля	Боковая петля	Петля- шпилька
1		+3,3
2	+0,8	+ 5,2	-
3	+ 1,3	+ 6,0	+7,4
4	+ 1,7	+ 6,7	+ 5,9
5	+ 2,1	+ 7,4	+4,4
6	+2,5	+8,2	+ 4,3
7	+ 2,6	+9,1	+ 4,1
8	+ 2,8	+ 10,0	+4,1
9	+ 3,1	+ 10,5	+ 4,2
10	+3,6	+ 11,0	+ 4,3
12	+ 4,4	+ 11,8	+4,9

Результаты экспериментальных исследований, в которых оценивалась
свооодная энергия при образовании различных типов петель, приведены в
"абл. 6.1.

Из результатов экспериментальных исследований следует, что свобод-
ная энергия формирования петли не зависит от последовательности нукле-
оидов в петле, а определяется числом, образующих петлю нуклеотидов.

В табл. 6.2 приведены параметры, с помощью которых можно рассчитать
свободную энергию спирали. Термодинамические параметры вычислены при
емпературе 37 . Образование спирали энергетически выгодный процесс,
I. естественно, все величины отрицательные. Расчет производится сле-
дующим образом. Предположим, что в процессе формирования спирали к
крайней паре нуклеотидов (А - на 5' конце цепи, II - на 3' конце в таб-
лице обозначается *) (см. второй ряд) добавляется пара ° (см. 12-й
столбец), тогда свободная энергия спирали изменяется на величину -1,7
ккал/моль. Очевидно, что наиболее стабильной оказывается спираль, сос-
тоящая из С-С пар, но расчет стэкинг взаимодействий показал, что наи-
больший вклад в свободную энергию (-3,4 ккал/моль) будет в том случае,
когда эти пары расположены в спирали асимметрично, а именно следующим
образом:	. Другая взаимная ориентация этих оснований дает

значительно меньший вклад в свободную энергию.

Таблица 6.2

Изменение свободной энергии
при добавлении комплементарной пары в спирали

—5'	А	А	А	А	и	и	и	и	6	С	с	6	С	с	С	с
3' —	А	и	6	С	А	и	6	с	А	и	6	с	А	и	6	с
А:А	О	о,1	0	0	0,8	0	0	0	0	0	0	1,9	0	0	1,1	0
А:О	0.8	0.9	1	1	0,9	0,8	0,7	0,8	0,8	о, 5	1	1,7	0,7	0,7	2,1	0,7
А:6	0	1.1	0	0	1	0	0	0	0	0	0	1,9	0	0	1,6	0
А:С	0	0,7	0	0	0,7	0	0	0	0	0	0	1	0	0	1,1	0
О:А	1	1,1	1,1	0, 8	0,9	0,5	0,5	0, 6	1,1	0,7	1,2	1,8	0,7	0, 5	2,3	0, 6
и:и	0	0,5	0	0	0,8	0	0	0	0	0	0	1,2	0	0	0,7	0
0:6	0	0,7	0	0	0,5	0	0,5	0	0	0,6	0	1,5	0	0	1,3	0
О:С	0	0,5	0	0	0,7	0	0	0	0	0	0	0,8	0	0	0,5	0
6:А	0	1,1	0	0	1	0	0	0	0	0	0	1,9	0	0	1,3	0
6:0	0	0,5	0	0	0,7	0	0,5	0	0	0, 5	0	1,5	0	0	1,9	0
6:6	0	1,2	0	0	1	0	0	0	0	0	0	1,9	0	0	1,4	0
6:С	1,1	2,3	1,3	1,3	2,1	0,7	1,9	0,8	1,6	1,3	1,4	2,9	1,1	0, 5	3,4	0,6
С:А	0	0,8	0	0	1	0	0	0	0	0	0	2	0	0	1,3	0
С:П	0	0,6	0	0	0,8	0	0	0	0	0	0	1,5	0	0	0,8	0
С:6	1,9	1,8	1,9	2	1,7	1,2	1,5	1,5	1,9	1,5	1,9	2	1	0,8	2,9	1,1
С:С	0	0,6	0	0	0,7	0	0	0	0	0	0	1,1	0	0	0,6	0

К приведенным параметрам необходимо добавить также величины сво-
бодной энергии, которые учитывают вклад свободных "хвостов" полимер-
ной цепи. В работе (Еге1ег ей а1.,1984) было тщательно проанализиро-
вано влияние неспаренных свободных концевых нуклеотидов. Оказалось,
что свободная энергия в очень значительной степени зависит от после-
довательности крайних нуклеотидов. Наличие практически всех термоди-
намических параметров различных элементов вторичной структуры позво-
ляет вычислить свободную энергию.

После того, как были рассмотрены структурные условия, а также
термодинамические параметры образования и распада спиральных участ-
ков, можно приступить к анализу методов образования вторичной струк-
туры РНК.

6.3.	ОСНОВНЫЕ АЛГОРИТМЫ ДЛЯ ПРЕДСКАЗАНИЯ ВТОРИЧНЫХ СТРУКТУР

Комбинаторные методы. Первые, кто сыграли в "игру тРНК” были Дж.
Фреско, Б.Олбертс и П.Доти ( Ргезсо е1 а1., 1960 ). В 1960 г. они
опубликовали работу, в которой исследовали проблему определения вто-
ричной структуры по первичной последовательности. Они сформулировали
ее как задачу нахождения конфигурации с максимальным для данной после-
довательности числом спаренных оснований. Выводы в этой работе носили
качественный характер, так как способ нахождения подобной структуры не
был найден авторами.

Через пять лет, когда в работе Холли была расшифрована нуклеотидная
последовательность молекулы тРНК, принцип максимального числа нуклео-
тидных пар был опробован на реальной последовательности. Оказалось,
что природа в качестве вторичной структуры тРНК выбрала конфигурацию
"клеверного листа". Впоследствии многочисленные расчеты различных рас-
шифрованных тРНК показали, что эта структура является общей для всех
молекул. В 1974г. удалось с помощью рентгеноструктурного анализа подт-
вердить справедливость выбора этой структуры для тРНК. Тем самым было
показано, что критерий комплементарности обладает предсказательной си-
лой.

Однако простой подсчет максимального числа спаренных оснований для
выбора вторичной структуры не всегда приводил к правильным результатам
даже в случае некоторых тРНК. Для более длинных молекул, например 53
рибосомальной РНК, число возможных пар резко возрастало, что очень
затрудняло выбор оптимальной структуры. При этом было сомнительно, что
полученные структуры с максимальным числом нуклеотидных пар отвечают
действительности, поскольку они не соответствовали биологическим свой-
ствам этой молекулы (Ье»1з, БоФу, 1970). Очевидно, что простой подсчет
Уотсон - Криковских пар является формальным критерием и не может отра-
жать реальной картины, происходящей при формировании вторичной струк-
туры. Поэтому на следующем этапе исследования вторичной структуры РНК
в качестве критерия стали использовать свободную энергию.

Оценка свободной энергии вторичной структуры заставила подробно
проанализировать все возможные структурные элементы (рис.6.1). Ранее,
при подсчете комплементарных нуклеотидов фактически анализировались
только двуспиральные участки.Однако при опенке свободной энергии в ка-
честве дестабилизирующих слагаемых должны входить также величины сво-
бодной энергии одноцепочечных фрагментов: петли, внутренние и боковые
петли.

В работе Тиноко с соавт. (Т1посо еГ а1.,1971) впервые были исполь-
зованы термодинамические параметры для подсчета свободной энергии
структуры. Для спирального участка были приведены две величины: бСд.с
- изменение свободной энергии спирали - при добавлении А-11 пары равно
-1,2 ккал/моль и бйя_с - соответственно при добавлении С-С пары равно
-2,4 ккал/моль. Изменение свободной энергии при инициации спирали или
при образовании петли имеет вид

бС=-2,ЗКТ[В-1,5 1ое(т+1)],

где В -параметр,отражающий тип петли, в которой находится ш оснований.
Общая формула для свободной энергии структуры при 25

бО-1,2 1Г -2,4 Я +С,
7 А-11 7 О-С

где С=5,9+2,0 1о§(т+1) для петли и для внутренней петли или
С=4,1+2,0 1о§(т+1) для боковой петли; Нд_и и На_с - число А-11 и С-С
пар в структуре соотвественно. Предполагается, что число нуклеотидов в
петле ш должно быть больше 3, так как хотя петля с тремя основаниями
по стерическим соображениям уже может существовать, но энергетически
она невыгодна.

Исследовался небольшой фрагмент из 55 оснований рибосомальной РНК
К17. По существу осуществлялся перебор всех комплементарных пар на
этой последовательности, из которых формировались всевозможные спира-
ли. В этой работе впервые подробно анализировались дефекты спиральных
участков - различные типы петель - и обсуждались их стерические и
энергетические характеристики. Для выбора наилучшего варианта исполь-
зовался термодинамический критерий, который отражает существо процес-
сов, происходящих при формировании вторичной структуры.

Дальнейшим развитием этого подхода можно считать работу ( Р1раз,
МсМаНоп, 1975), в которой анализировались последовательности 62 тРНК.
Алгоритм расчета состоял из трех этапов: 1) определения всех возможных
потенциальных спиралей; 2) анализа совместимости спиралей и формирова-
ния из них всевозможных вторичных структур; 3) подсчета свободной
энергии и выбор энергетически наиболее выгодных структур. Длина анали-
зируемой последовательности составляла около 89 оснований, а число
структур, которые надо было перебрать, достигало в ряде случаев 13 000
вариантов. Расчет свободной энергии осуществлялся аналогично методике,
разработанной в работе (Т1посо еФ а1., 1971), однако величины парамет-
ров были частично модифицированы с учетом результатов термодинамичес-
ких исследований, проведенных в работах (Ш11епЬеск еФ а1., 1973;Сга11а,
198
Сгойегз, 1973; Вогег еФ а!., 1974). Результаты расчетов выявили несо-
вершенство термодинамических параметров, поскольку из 62 рассмотренных
тРНК только в 32 случаях наиболее энергетически выгодными оказались
структуры типа "клеверный лист".

В работе (З'ЬисЫска еФ а1.,1978) громоздкость переборного метода
была немного облегчена. Авторам удалось снизить время перебора до ве-
личины, пропорциональной №, где П - число нуклеотидов в последова-
тельности. Алгоритм был успешно опробован для предсказания вторичной
структуры 53 РНК.

К переборным методам можно отнести и работу (Миронов и др. ,1984), в
которой поиск всех вторичных структур основан на обходе дерева возмож-
ных структур (рис.6.4). Предположим, что на последовательности можно
сформировать пять спиралей (рис.6.4,а). Совместимость спиралей друг с

4 2 2 4
а --------— . *---------

1 1 5 3 3 5

б

	1 2 3 4 5
1  2  3  4  5	-- + + +  -  + + - + + + + + + -  + - + - -

02 3 4 5

[2]3 4 5	1 3[4]5

3 4	3 5

Рис. 6.4. Поиск всех возможных вторичных структур

а - взаимное расположение потенциальных спиралей на последователь-
ности РНК; б - матрица совместимости; в - дерево возможных структур и
его обход; г - максимальные структуры

другом отражена в матрице (рис.6.4,б). Элемент матрицы ш равен 1,
если 1-й нуклеотид комплементарен з-му и равен 0 в противном случае.
Дерево структур строится следующим образом. На первом этапе построения
дерева считаются допустимыми все спирали (рис.6.4,в). Из матрицы сов-
местимости видно, что спираль I несовместима со спиралью II. Поэтому
возможны структуры, либо содержащие спираль I и не содержащие спираль
II (переход вправо),либо не содержащие спираль I (переход влево). Рас-
смотрим для примера правую ветвь дерева, т.е. примем на втором этапе
спираль I и все совместимые с ней (I,III,IV,V). Здесь спираль IV не-
совместима со спиралью V, т.е. возможны варианты (1,111,IV) и (1,111,
V). Эти совокупности спиралей представляют собой структуры В и С с
максимально возможным числом спиралей (рис.6.4,г). Аналогично просмат-
риваются остальные ветви дерева. Затем подсчитывают свободную энергию
всех полученных структур.

Разнообразие вторичных структур для одной молекулы достаточно вели-
ко. Число возможных структур, например рибосомной 53 РНК, может дости-
гать 3000, но большинство из них имеет пренебрежимо малую вероятность
существования. Поэтому целесообразно определить не все возможные, а
только наиболее вероятные структуры, так как именно среди них должны
содержаться биологически активные. В соответствии с этим в работе был
получен ансамбль вторичных структур, в котором представлены все воз-
можные структуры с вероятностями р., отвечающими распределению Боль-
цмана:

Р!=2ехр(-бС(/КТ),

где бО. - свободная энергия 1-й структуры, а 2 - нормировочный мно-
житель.

Однако изложенные комбинаторные методы, в которых осуществляется
перебор всех возможных структур, оказались недостаточно эффективны и
не получили широкого распространения. Развитие методов анализа нуклео-
тидных последовательностей привело к тому, что увеличились длины рас-
шифрованных последовательностей и соответственно резко возросло число
альтернативных структур. Пропорционально этому увеличилось и время,
требуемое для расчетов. Однако неразумность использования переборного
подхода связана скорее всего не с этим обстоятельством. Дело в том,
что при анализе всех вариантов вторичных структур нет возможности, так
сказать, руководить этим процессом, например на каком-то этапе забра-
ковывать явно невыгодную структуру и не доводить процесс ее формирова-
ния до конца. Поскольку очевидно, что невыгодным будет подавляющее
число структур, то отсюда понятно, насколько неэффективен метод пере-
бора. Поиски выхода из этого затруднения привели к идее использования
метода динамического программирования, которая оказалось исключительно
плодотворна.

Индуктивные методы. Индуктивный, или рекурсивный, подход наиболее
широко распространен для предсказания вторичных структур РНК. Как пра-
вило, для этой цели используют метод динамического программирования.
Впервые этот алгоритм для определения вторичной структуры РНК по нук-
леотидной последовательности был использован В.Г.Туманяном с соавт.
(Туманян и др.,1966).

Продемонстрируем возможности метода на примере небольшой нуклеотид-
ной последовательности (рис. 6.5). Запишем все возможные комплементар-
ные пары в виде треугольной таблицы. Элемент таблицы а.р стоящий на
пересечении 1-го столбца и 1-й строки, равен 1, если 1-й нуклеотид
комплементарен 1-му, и равен 0, если соответствующие основания не ком-
плементарны. Нетрудно догадаться, что если через единички можно про-
вести диагональ из левого нижнего угла в правый верхний, то на после-
довательности может образоваться соответствующая спираль. В данном
случае видно, что существует только одна диагональ из единичек и пос-
ледовательность как бы складывается пополам и 1-й нуклеотид образует
пару с 10-м нуклеотидом, 2-й нуклеотид с 9-м и т.д. Следовательно, на
данной последовательности можно построить спираль из пяти спаренных
оснований. Это число можно найти, построив вторую треугольную таблицу,
элементы которой Ь находятся по следующему правилу:

если а(=1

тах (а.	;	), если аи = 0.

Можно доказать методом математической индукции, что построенный таким
образом матричный элемент . равен числу пар в максимальной по длине
спирали, построенной на участке последовательности от 1-го до д-го
нуклеотида. Заполнение этой таблицы начинается с первых номеров после-
довательности.

1 2 3 4 5 6 7 8 9 10

А П 0 '3 С С С А А О

1

2

3

4

5

6

7

8

9

10

А
О
и
с
с
с
с
А

0	0	0	0

0	0	0	1	0

0	0	0	0	1	0

0	0	0	1	0	1	0

0	1	1	0	0	0	0	0

0	1	1	0	0	0	0	0	0

1	0	0	0	0	0	0	1	1 0

Рис. 6.5. Нуклеотидная последовательность и матрицы возможных комп-
лементарных пар

Таким образом, можно выбрать на данной последовательности наиболее
длинную спираль. На основе одношпилечного алгоритма можно найти конфи-
гурацию о двумя и более спиралями. В результате можно получить струк-
туру, состоящую из самых длинных спиралей.

В последующих работах, аналогично тому, как развивалось применение
комбинаторных методов, подсчет нуклеотидных пар был заменен расчетом
свободной энергии. Нуссинов и Якобсон (Ни551поу, ТасоЬзоп, 1980) раз-
работали быстрый алгоритм для предсказания вторичной структуры РНК с
наименьшей свободной энергией. Поскольку эта работа получила широкую
известность и породила целый ряд исследований, рассмотрим ее более
подробно.

7 Заказ № 4327

201
Идею подхода легче представить на задаче, в которой определяется
структура с наибольшим числом спаренных оснований. Представим нуклео-
тидную последовательность в виде окружности, а возможные компле-
ментарные пары - дугами между соответствующими нуклеотидами (рис.
6.6). Выберем на окружности отрезок длиной р и определим макси-

Р и с. 6.6. Представление вторичной структуры на окружности

мальное число пар на этом отрезке. Точка разбиения отрезка к пробегает
все нуклеотиды от о1 до Ь]_1. В каждой точке проверяется возможность
образования комплементарной пары ЬкЬ^ и подсчитывается их число на
фрагментах Ь1 Ьк_, и	После того, как все точки к будут про-

верены, выбирается максимальная величина нуклеотидных пар и записыва-
ется в матрицу комплементарных пар М1 г Если не может образовать
пару ни с одним нуклеотидом к на фрагменте Ь(ЪГ то М, =М(	. Уве-

личивая соответственно значения 1 и 1,можно проверить все возможные
отрезки длиной р на последовательности Ь,ЬП. На следующем этапе повто-
рим аналогично всю процедуру на отрезке длиной р+1 и т.д. Следователь-
но, для каждого интервала

М, мах (М, к_,+Мк+1 ^,+1,

1 < к <>1 + р .

Поскольку выбор дуги Ц происходит с последовательным увеличением
длины р, то величины М, к_,, Мкм и М, уже определены и эле-
мент матрицы М1 может быть легко подсчитан. На последнем этапе рас-
считывается величина М1 п, т.е. определяется, какое максимальное коли-
чество комплементарных пар может быть образовано на всей последова-
тельности.

Для того, чтобы получить соответствующую максимальную структуру,
строится вторая п п матрица К. В элементе матрицы К1 3 содержится
номер основания Ьк с наибольшим числом возможных нуклеотидных пар на
интервале Ь,г Для образования структуры сначала рассмотрим величину
К]п. В ней записано число к - номер нуклеотида Ьк, который, образуя
пару с нуклеотидом Ьп, приводит к наилучшему сворачиванию всей после-
довательности. Образование этой пары делит последовательность на две
части. Теперь для каждой из них анализируем матрицу К и повторяем про-
цедуру оптимального сворачивания. Разбивая последовательность на все
более маленькие фрагменты, получим в результате структуру с максималь-
ным числом пар.

Алгоритм поиска структуры с минимальной свободной энергией пост-
роен аналогичным индуктивным образом. Анализируются последовательно
увеличивающиеся нуклеотидные фрагменты и определяется минимальная
свободная энергия. Выражение для матрицы М может быть переписано
следующим образом

т!п {Е1к.гЕк41|^1+Еък,
Е,_1 < к <з-1в1п,

где Е1 - элемент матрицы Е, в которой записана минимальная энергия
структуры, образованная нуклеотидной последовательностью Ь,Ьр ЕЬк -
энергия пары нуклеотидов о и к; 1т1п равно 3, это минимальное число
нуклеотидов, которое может находится в петле.

В каждом случае энергия для отрезка Ь,Ь определяется как сумма
энергий, рассчитанных для фрагментов Ь^.,, Ьк41^ и энергии самой
пары ЬкЬг Величина наименьшей энергии структуры, построенной на от-
резке Ь,Ьр записывается в матрицу М1р а позиция Ьк, при которой по-
лучена эта величина в матрицу К( г Такой индуктивный метод позволяет
быстро подсчитать энергию. Построение вторичной структуры с наименьшей
свободной энергией происходит в обратном порядке - от анализа всей
последовательности Ь1 п к минимально возможным фрагментам. В итоге оп-
ределяется структура с наименьшей свободной энергией. Время, необходи-
мое для выбора энергетически оптимальной структуры, пропорционально п3.

К числу наиболее популярных методов предсказания вторичной структу-
ры относится также алгоритм, предложенный Цукером и Стиглером (2икег,
ЗНе§1ег,1981). Идея их индуктивного подхода очень проста. Рассматри-
вается небольшой фрагмент нуклеотидной последовательности. На нем вы-
бирается структура с наименьшей свободной энергией. На следующем шаге
фрагмент увеличивается на один нуклеотид.При анализе возможных вторич-
ных структур предполагается, что выбранная на предыдущем этапе струк-
тура является частью вновь образованной. Поэтому необходимо вычислить
энергию только тех возможных элементов вторичной структуры, которые
образуются при элонгации цепи. Затем выбрать минимальную структуру и
перейти к следующему этапу. На последнем этапе вычисляется энергия
структуры, сформированной уже всей цепью.

На рис.6.7 представлены элементы вторичной структуры, которые ана-
лизируются в этой работе. Выделяются два типа вторичных структур: 1)
структуры, в которых концевые нуклеотиды 1 и з образуют комплементар-
ную пару между собой; 2) структуры, в которых нуклеотиды 1 и 1 не свя
ваны друг с другом.

Все варианты структур первого типа показаны на рис. 6.7,а,б,в. В
первом случае в структуре присутствует только одна петля типа шпильки.
Обозначим энергию - Е1, . Если в структуре существует ровно две пет-
ли, одна петля - обязательно шпилька, а вторая может быть внутренней
или боковой (рис.6.?,б). Тогда энергию такой структуры Е21 . можно
представить как сумму энергий двух составляющих частей структуры -
Е1П и, в этой части присутствует только одна петля, замкнутая нукле-
отидами 11 и „и, и энергии остальной пасти - Е ,. Энергия структуры
Е21 равно* Е2.	Е(1 ,, +	.. И. наконец, е ли в структуре больше

двух петель, то	можно пред-равт1 как сумму энергий двух

частей структуры \рис.6.7,в): ЕЗ, = ЕМ1 ,, + Е11 + 1	. Аналогично

рассматривается и второй вариант, в котором краевые нуклеотида не об-
разуют пару друг- с другом. Минимальная свободная энергия структуры
рассчитывается, используя полученные подобным образом реккурентные
формулы.

Рис. 6.7. Типы вторичных структур РНК. Вторичные структуры, в кото-
рой концевые нуклеотиды 1 и у образуют пару друг с другом

а - в структуре присутствует только одна петля; б - в структуре
присутствуют две петли; в - общий случай: в структуре присутствуют
больше двух петель

В последние годы метод динамического програмирования очень широко
применялся для предсказания вторичных структур РНК. По-видимому, наи-
более интенсивно использовались рассмотренные нами алгоритмы, получен-
ные в работах (Пизз1поч, ПасоЬзоп, 1980; Еикег, 5Ф1е§1ег, 1981).Позже
оба эти алгоритма неоднократно модифицировались. Якобсон и Зукер.объе-
динившись друг с другом (ИасоЬзоп, Сооб еб а!., 1984), сумели в 4 раза
уменьшить требуемый объем памяти, необходимый для расчетов по програм-
ме Зукера и Стиглера. В свою очередь в другой работе Нуссинов с соавт.
(Сотау, Лиззхпоу ег. а1., 1984) значительно улучшили алгоритм расчета,
предложенный ею ранее совместно с Якобсон, - скорость счета при этом
для последовательности, содержащей 1000 нуклеотидов, возросла на два
порядка.

При использовании метода динамического программирования независимо
от того, какой конкретно алгоритм применяется, на каждом шаге выбира-
ется одна структура. В результате с помощью этого метода можно полу-
204
чить только одну единственную вторичную структуру с минимальной сво-
бодной энергией. Естественно, что корректность этих предсказаний зави-
сит от точности определения термодинамических параметров. Однако в эк-
спериментальных работах указывается, что точность определения парамет-
ров для спиральных областей не превышает 0,2-0,5 ккал, а для петель и
для других неспиральных областей оценка параметров еще более грубая -
1-2 ккал (8а1зег, 1977).

Кроме этого, термодинамические параметры рассчитываются для конк-
ретной температуры (обычно 37 ) и строго определенных условий, имеется
в виду, например, ионная сила раствора. Изменения условий должны при-
вести к изменению вторичной структуры. Однако метод динамического
программирования не позволяет выявить возможные структурные модифика-
ции. Он очень жестко связан с параметрами. Поэтому нет никакой уверен-
ности в том, «то, даже если расчет произведен аккуратно, тр-в'- 'сданная
структура действительно соответствует структуре с минимальной свобод-
ной энергией.

Есть еще более важное соображение, которое заставляет быть неудов-
летворенным методом динамического программирования для поиска вторич-
ных структур РНК. В ряде работ было показано, что биологическое значе-
ние могут иметь альтернативные неравновесные структуры. Так, альтерна-
тивные структуры могут быть важны для объяснения механизма трансляции
(СоИ, еФ а1., 1981), стабильности мРНК (чоп СаЫп еФ а1.,1983), атте-
нюации (КоПег, УапоГзку, 1982).

Поэтому возникла потребность в разработке алгоритма, позволяющего
предсказывать несколько близких по энергиям структур. В работе
(ШПИатз, Т1посо, 1986) был разработан модифицированный алгоритм, ь
котором используются идеи динамического программирования, развитые
Нукером и Стиглером. В результате расчета можно получить не только од-
ну единственную оптимальную структуру, но и определить ряд субопти-
мальных вторичных структур.

Кинетический подход. Для предсказания вторичной структуры РНК было
предложено еще несколько оригинальных алгоритмов, которые можно услов-
но объединить под названием кинетический подход. На наш взгляд, этот
подход является наиболее перспективным. Идея его заключается в модели-
ровании на ЭВМ процесса формирования вторичной структуры РНК.

В наиболее четком виде такой подход" был впервые использован Джорда-
ном (ПогОап, 1972). Он фактически разыгрывал на ЭВМ процесс образова-
ния спиральных участков. С помощью метода Монте-Карло на последова-
тельности выбираются две случайные точки. Если они могут образовать
комплементарную пару, то программа "старается" дорастить сколько воз-
можно спиральный участок в обе стороны от стартовой паоы. Если спи-
ральный участок в этом месте возможен, то он фиксируется, затем выби-
раются две другие случайные точки и процедура повторяется до тех пор.
пока на последовательности остается возможность образовать комплемен-
тарные пары. Такой расчет проводится несколько раз и в результате мож-
но выбрать структуру с наибольшим числом пар.

В работе Мартинеца (МагИпег, 1984) предлагается рассматривать про-
цесс образования вторичной структуры как последовательное добавление
спиральных участков. Правило, которым при этом пользуются, является
очень простым: к структуре надо добавить спираль, которая имеет наи-
большую константу равновесия - Крава = ехр(- бС1/КТ), где бС. - изме-
нение стандартной свободной энергии структуры при присоединении к ней
1-й спирали.

Практически реализация этого алгоритма происходит следующим обра-
зом. Предварительно рассчитываются все возможные спирали, которые мо-
гут образоваться на данной последовательности. Затем на ЭВМ начинают
моделировать образование вторичной структуры. Предположим, что на не-
котором этапе уже сформировалась часть вторичной структуры. На следую-
щем шаге для всех полностью топологически совместимых с этой структу-
рой спиралей рассчитываются константы равновесия. Выбор спирали, кото-
рая добавляется к структуре, происходит с помощью метода Монте-Карло,
при этом вероятность выбора пропорциональна константе равновесия. Про-
цесс самосборки молекулы РНК многократно повторяют, и в результате по-
лучается наиболее вероятная структура.

Такой подход к предсказанию оптимальной вторичной структуры предс-
тавляется нам очень перспективным и требующим своего развития. К сожа-
лению, эта работа не свободна от недостатков. Отметим два из них, ка-
сающихся правила добавления спиралей к структуре. Автор полагает, что
только спирали, представленные на рис. 6.2,а, имеют право на совмест-
ное существование. Однако в разделе "Условия совместимости спиралей"
уже подробно обсуждалось более широкое определение топологической сов-
местимости и доказывалась необходимость рассматривать и частично сов-
местимые спирали. Кроме того, отметим, что при анализе образования
структуры неправильно рассматривать только полностью или частично сов-
местимые спирали, необходимо учитывать все потенциальные спирали. На
первый взгляд кажется,что возможность добавления к структуре только
совместимых спиралей является очевидным. Однако это ограничение списка
спиралей сильно уменьшает число вариантов образования структуры. Дейс-
твительно, чтобы добавить несовместимую спираль, необходимо разрушить
некоторые уже существующие спиральные участки. Однако, возможно, что
необходимая для этого затрата энергии будет компенсироваться выигрышем
энергии при появлении новой, более выгодной спирали в структуре.

Второе возражение,касающееся выбора констант присоединения спиралей
к структуре,более существенное.Процесс образования вторичной структуры
можно описать обратимыми реакциями: 3 + К -= ЗЬ, где 3 структура, а Ь
- спираль, которую добавляют к структуре. Используя константу равнове-
сия. автор как будто хотел учесть обратимость этой реакции. Но утверж-
дение, будто выражение Кравн 8 Ь описывает результирующую скорость
206
процесса является абсолютно неправильным ни с кинетической, ни с тер-
модинамической точки зрения.

В этой работе была сделана попытка рассчитать равновесную структу-
ру. Однако во многих исследованиях, в которых анализировался процесс
самоорганизации, было показано, что время структурных перестроек может
достигать очень большой величины. Поэтому не всегда ансамбль вторичных
структур, существующих 1п у!уо, можно считать равновесным. В связи с
этим представляет интерес задача поиска кинетического ансамбля вторич-
ных структур РНК - совокупности вторичных структур, вероятность обра-
зования которых зависит от времени. Для решения этой проблемы необхо-
димо внимательно проанализировать условия, а также кинетические конс-
танты образования спирального участка во вторичной структуре. Все эти
вопросы будут подробно рассмотрены ниже (см. "Определение кинетическо-
го ансамбля вторичных структур РНК").

Ферментативные и филогенетические методы предсказания. Несколько
особняком стоят работы, которые можно отнести к ферментативным и фило-
генетическим методам предсказания вторичной структуры. Суть этого под-
хода заключается в том, что из анализа экспериментов по взаимодействию
ферментов с молекулой РНК пытаются определить места расположения спи-
ральных участков в структуре. Для предсказания структуры используют
также данные для тех же молекул, но в других организмах. При этом
предполагается, что одинаковые РНК из разных организмов должны иметь
схожую структуру. Разумеется анализ экспериментальных данных является
обязательным при любом подходе. Беда только в том, что в подавляющем
большинстве случаев у исследователя нет таких данных.

В работе (Жоезе е"Ь а1., 1980) приведена вторичная структура 163 ри-
босомальной РНК, полученная, как пишут авторы, при помощи филогенети-
ческих, ферментативных и химических доказательств. Эта молекула оказа-
лась очень удобным объектом, поскольку для нее имеется большое число
экспериментальных данных. Ход анализа следующий. Сначала рассчитывают-
ся все возможные спиральные участки, которые могут быть сформированы
на всей 1542 нуклеотидной последовательности.Таких спиралей, содержа-
щих более четырех пар нуклеотидов, оказалось около 10 000. Последова-
тельно, начиная с 5' конца, рассматривают возможность появления данной
спирали в структуре и сопоставляют получающийся при этом фрагмент
структуры с биохимическими данными. К примеру, возможность химической
модификации нуклеотида свидетельствует, что данный нуклеотид скорее
всего не находится в спиральном участке. Аналогично анализируются дан-
ные по местам взаимодействия с ферментами. Ограничения, которые возни-
кают из-за экспериментальных данных, резко сужают число возможных спи-
ралей и перебор всех допустимых спиралей становится вполне разрешимой
задачей. Затем сравнивают вторичные структуры 163 РНК из Е.соИ и
В.Ьге71з, а также из других организмов. В результате была получена
вторичная структура, состоящая из примерно 50 спиральных участков.
Филогенетический подход лежал в основе предсказания вторичной
структуры 185 рРНК рибосом эукариот (Манькин и др.,1981). За основу
взяли модель 163 рРНК Е.соИ, предложенную в только что рассмотренной
нами работе. При построении модели авторы исходили из того, что моле-
кулы рРНК одного класса, выполняя одни те же функции в разных организ-
мах, должны быть сходно организованы, несмотря на различия в их пер-
вичных структурах.

Анализ вторичной структуры РНК с помощью ферментативных методов ис-
следования проводился также в работе (Кгатег, МШз, 1981), в которой
исследовалось образование вторичной структуры РНК МОТ-1 во время ее
синтеза. При этом анализировалась вторичная структура, которая возни-
кает в процессе роста, при различной длине цепи. Как видим, если исхо-
дить из стратегии поиска структуры, то эту работу можно с полным осно-
ван;,ем отнести г методу, который мы условно назвали кинетическим. Од-
нако в данном случае критерием отбора служили биохимические данные.

Фрагменты РНК различной длины были разделены с помощью электрофоре-
за, а затем выделены из геля. Каждый фрагмент был обработан нуклеазой
Т1, которая специфична к однотяжевому участку. Анализ этой реакции
позволяет локализовать спиральные участки. Очень интересные наблюдения
об изменении структуры были сделаны во время роста цепи. Было показа-
но, что процесс образования структуры сопровождается как образованием,
так и разрушением спиралей. Появление новых спиралей может привести к
разрушению старых, если они не могут совместно сосуществовать по сте-
рическим соображениям. Авторы сделали вывод, что структура находится в
состоянии динамического равновесия. Устойчивая при одной длине цепи
структура при росте цепи разрушается и образуется другая вторичная
структура.

Более того в этой работе экспериментально доказывается, что процесс
формирования может идти разными путями. Так, во время роста цепи наря-
ду с оптимальной может существовать структура менее энергетически вы-
годная. Авторы, пытаясь объяснить этот факт, предполагают, что ско-
рость полимеризации значительно выше скорости структурных перестроек и
структуры не успевают перестроится. Все эти результаты представляются
нам чрезвычайно важными для понимания процессов образования вторичной
структуры и для объяснения биологических функций РНК.

6.4.	ОПРЕДЕЛЕНИЕ КИНЕТИЧЕСКОГО АНСАМБЛЯ ВТОРИЧНЫХ СТРУКТУР РНК

Образование спиральных участков. Проведенный в разделе "Условия
совместимости спиралей" анализ топологических условий взаимного распо-
ложения спиралей в структуре позволяет рассмотреть процесс образования
спиральных участков. Этот процесс условно можно представить в виде
трех последовательных этапов (рис.6.8).
1.	Подготовка к образованию нового спирального фрагмента. Сразу от-
метим, что если новая спираль топологически совместима полностью или
частично со всеми существующими в структуре спиралями, то этот этап
отсутствует. В противном случае для инициации спирали требуется полный
или частичный распад фрагментов вторичной структуры. Предположим, что
для образования спирали III требуется разрушить спираль II (рис.6.8).
Кинетическая константа Кр определяется временем ожидания спонтанного
распада спирали. Энергетические затраты для этого процесса в основном
зависят от внутренней энергией мешающих участков.

2.	Инициация спирали. На этом этапе существенным является образова-
ние первой пары спирали. Необходимым условием для этого является соот-
ветствующее расположение комплементарных оснований. Кинетическая конс-
танта Кн определяется временем, за которое нуклеотиды подойдут друг к
другу и образуют комплементарную пару. Вероятность этого события зави-
сит в основном от энтропийного вклада в свободную энергию цепи.Энер-
гия, необходимая для осуществления первых двух этапов, определяют вы-
соту энергетического барьера процесса образования спирали.

3.	Рост новой спирали. Наличие инициирующей пары - аналогично цент-
ру кристаллизации при образовании кристалла, приводит к спонтанному
формированию комплементарных пар. Кинетическая константа Кп может дос-
тигать очень большой величины, порядка 106-10' (РогзИке, 1974). Рост и
замыкание спирали можно сравнить с быстрым застегиванием молнии, пос-
кольку все основания соответствующим образом сориентированы для обра-

зования комплементарных пар.

Рис. 6.8. Изменение энергии Е и
этапы образования спирали в структуре

Рис. 6.9. Различные условия инициа-
ции образования спирали II

а - для инициации требуется полное
разрушение спирали I; б - свободное
образование инициирующей пары А2Б2; в
- для инициации требуется разрушить
часть комплементарных пар; г - спи-
раль А В С Б образоваться не может
На рис.6.9 проиллюстрированы несколько вариантов образования новой
спирали А2В2С2П2.При топологической несовместимости (рис. 6.9,а) тре-
буется полный распад всей спирали АДС^В,. При этом энергетический
барьер определяется энергией распада спирали и энергией инициации но-
вой спирали. При взаимной ориентации спиралей, показанной на рис.
6.9,6, инициация происходит свободно, а затем при помощи скользящей
петли образуется динамический комплекс спиралей.Энергия, необходимая
для образования спирали, определяется энергией, требующейся для воз-
никновения инициирующейся пары, например А2П2. В случае, представ-
ленном на рис.6.9,в, инициирующая пара не может образовываться свобод-
но. Однако в отличие от варианта на рис.6.9,а здесь не требуется пол-
ного разрушения мешающей спирали, достаточно разрушить только две ком-
плементарные пары с нуклеотидами А,А2. Это условие должно соответ-
ствено отразиться на расчете барьера перехода. Заметим, что если в су-
ществующем в структуре спиральном участке уже присутствует скользящая
боковая петля,то ее перемещение может привести к тому, что число раз-
рушаемых пар станет минимальным. И, наконец, на рис.6.9,г представлена
ситуация, когда образование спирали невозможно. Здесь новая спираль
как бы вложена в уже существующую. Даже если произойдет инициация, хо-
тя это маловероятно, старая спираль вытеснит ее из структуры.

Определение эффективных кинетических констант образования и распада
спиралей. Каждое изменение структуры, т.е. образование или разрушение
спирального участка является, как видно из сказанного выше, многоста-
дийным процессом. На рис.6.8 были показаны некоторые промежуточные
стадии при образовании новой спирали, каждая из которых характеризует-
ся своей кинетической константой. Однако при анализе перехода в новое
состояние структуры целесообразно использовать эффективную кинетичес-
кую константу - К. Вопрос о корректном определении эффективной кинети-
ческой константы подробно анализировался в работе (Миронов, Кистер,
1988).Суть анализа заключается в следующем. Предположим, что исследу-
ется переход из А в В.Допустим также, что у этой реакции высокий энер-
гетический барьер и начальные концентрации А и В равны соответственно
1 и 0.( Эти условия соответствуют, например, процессу образования но-
вой спирали.) Поскольку кинетическая константа прямой реакции мала, то
мал и поток из А в В. Обратный поток определяется в данном случае кон-
центрацией В и, следовательно, тоже мал. Таким образом, суммарный по-
ток этой реакции равен примерно 0, а отсюда следует, что реакция нахо-
дится почти в равновесии и все промежуточные состояния при переходе из
А в В тоже находятся в равновесии. Следовательно, эффективная кинети-
ческая константа всего процесса определяется равновесными концентраци-
ями предпоследних состояний и кинетическими константами последней ста-
дии процесса.

Исходя из этих рассуждений, можно вывести формулу для эффективной
константы скорости распада спирали. Константа равновесия процесса пе-
210
рехода из состояния А в состояние В равна: Кд_в=ехр(-бС/КТ), где бС -
изменение свободной энергии при распаде спирали. Рассмотрим, что пред-
ставляет собой эти два состояния. Состояние А характеризует целую спи-
раль. В случае распавшейся спирали состояние В означает, что во всех
комплементарных парах разрушены водородные связи.Изменение энергии,
которое происходит при этом переходе равно бСспнралв. Действительно,
именно это значение требуется, чтобы разрушить все комплементарные
связи в спирале. Таким образом, величина константы распада зависит
только от энергии спирали. Аналогичный вывод был сделан и в работе
(АпзЬе1еу1с11 еФ а1.,1984).

Можно показать (Миронов, Кистер,1988), что для спирали, состоящей
из К комплементарных пар, эффективная константа скорости распада
спирали равна

Краспад=Нкпехр(-бСспнралв/ЙТ),	(6.1)

где кп - константа скорости образования одной нуклеотидной пары. Как
видно, константа распада зависит только от особенностей самой спирали
и не зависит от того, в какой структуре эта спираль существует.

Рассмотрим теперь, как изменится свободная энергия структуры при
образовании спирали. Появление нового двуспирального участка приводит
к появлению соответствующей петли. Кроме того, как уже говорилось, для
образования спиралей бывает необходимо разрушить мешающие спиральные
участки. Следовательно,изменение свободной энергии структуры можно
представить как сумму трех слагаемых: изменений свободных энергий при
образовании собственно спирального участка - бСспнралв, при появлении
петель - бСпетель» а также при разрушении мешающих участков -
бС	:

разрушение

бС	=бС +бС -бС

структуры спирали петель разрушение

Как видно, зта величина зависит как от образующейся спирали, так и от
того, в какой структуре она образуется.

Знание величины бСс1ру111ур1>1 позволяет рассчитать константу равнове-
сия этого процесса - К:

V

К- °6—-- -ехр(- бСструктурь/НТ) .
распада

Откуда, используя выражение (6.1), легко получить эффективную констан-
ту образования спирали:

К	=Ы*кехр((-бС +бС	)/НТ).	(6.2)

образования 1 лп*лН'' петель разрушение ''	•	'	'
Таким образом, вероятность образования спирали в структуре не зави-
сит от того какая эта спираль, важно только, в какой структуре она об-
разуется. Это можно интерпретировать следующим образом. Время образова-
ния спирали лимитируется процессом инициации. В предыдущем разделе уже
указывалось, что инициация включает в себя подготовительную стадию -
разрушение в случае необходимости спиральных фрагментов и образование
первой комплементарной пары. Вероятность образования этой пары опреде-
ляется вероятностью встречи комплементарных нуклеотидов, что в свою
очередь зависит от конформации петли, обеспечивающей локализацию нукле-
отидов. Эта величина дает основной вклад в энтропию, а стало быть, и в
свободную энергию петель. Множитель М отражает тот факт, что инициация
спирали может произойти в любой из И потенциальных нуклеотидных пар.
После образования инициирующей пары, этого "'центра кристаллизации",
формирование всего спирального участка.зависящего от к , происходит
очень быстро. Как уже указывалось, величина этой константы равна 106 -
108с.

Основная идеяподхода. После того как были рассмотрены структурные
условия, а также термодинамические параметры образования и распада
спиральных участков, можно приступить к исследованию кинетики образо-
вания вторичной структуры РНК (Миронов и др., 1.984; М1гопоу,К1зФег,
1986). Процесс образования вторичной структуры можно представить сле-
дующим образом. В каждый данный момент времени состояние вторичной
структуры можно описать длиной полинуклеотидной цепи и набором образо-
вавшихся топологически совместимых друг с другом спиральных участков.
Тогда существуют две возможности для изменения состояния молекулы: во-
первых, инициация и образование новой спирали и, во-вторых, удлинение
цепи ча один нуклеотид (распад спирали можно не рассматривать как
самостоятельную стадию, так как при этом увеличивается свободная энер-
гия). Образование спирали, как уже отмечалось, представляет собой
сложный, многостадийный процесс, для описания которого необходимо рас-
считать эффективную константу образования. Последовательность стадий
элонгации цепи и образования спиралей и представляет собой процесс об-
разования вторичной структуры. Задача состоит в том, чтобы наиболее
адекватно описать этот процесс.

Представим процесс самоорганизации вторичной структуры РНК в виде
цепи Маркова. В качество состояний системы будем рассматривать различ-
ные состояния молекулы. Переходы из одного состояния молекулы в другое
соответствуют переходам в цепи Маркова. Переходные вероятности опреде-
ляются соответствующими кинетическими константами. Таким образом, мож-
но рассчитать последовательность структурных перестроек.Для исследова-
ния же кинетики образования вторичной структуры необходимо включить в
рассмотрение время. Однако реальное время каждого перехода зависит не
только от соответствующей кинетической константы, но и от множества
других факторов.Например, от времени ожидания спонтанного распада ме-
212
шающей спирали. Поэтому предполагается, что время перехода является
случайной величиной.

Поскольку в построенной марковской цепи переходы обладают свойства-
ми: стационарности (в каждый момент времени вероятность перехода не
зависит от начала отсчета времени), ординарности (в каждый момент вре-
мени возможна только одна перестройка) и независимости от истории (ве-
роятность перехода зависит только от текущего состояния системы и не
зависит от того, каким образом образовалось это состояние), то время
перехода - случайная величина I, распределенная по закону Пуассона:

1'Ш = к.ехр(-кД),	(6.3)

где 1(Ь) - плотность вероятности; к, - кинетическая константа 1-то пе-
рехода.

Теперь, когда определены состояния и вероятности переходов, марков-
ский процесс перестроек вторичной структуры полностью определен. Тако-
ва общая идея подхода.

Алгоритм предсказания вторичной структуры. На первом этапе необхо-
димо определить те кирпичики, из которых будет построена структура,
т.е. выявить все возможные спиральные фрагменты. Здесь сразу возникает
вопрос, что является критерием существования такого фрагмента? Можно
ли ограничиться минимальной длиной, например три пары оснований в спи-
рале? По-видимому, разумно использовать энергетический критерий и от-
бирать спирали, стабильность которых выше заранее заданной величины.
Воспользуемся для этого таким критерием, как время жизни спирали. Су-
ществует отличная от нуля вероятность, что спонтанно раскроются после-
довательно все основания спирали. Среднее время этого процесса назовем
временем распада спирали - Фоасп. Из формулы (6.1) это время оценива-
ется величиной

Г. =1/К	=1/Ык эхр(-бС /ВТ) .

респ р&спад	п	спирали

Варьируя величину трасп, можно выбрать необходимое для каждого случая
число анализируемых спиралей.

При выборе числа потенциальных спиралей можно предположить, что оп-
ределяющую роль в процессе формирования структуры играют ..лабильные
спирали, время жизни которых на порядок или больше превосходит анали-
зируемый интервал времени. Эти спирали создают как бы каркас структу-
ры, а легкоразрушаемые спирали достраивают структуру. Образование и
распад этих слабых спиралей может происходить очень часто и быстро.
Они подстраиваются к каркасу, и их вклад в свободную энергию не явля-
ется решающим. Чтобы учесть это обстоятельство, целесообразно в мар-
ковском процессе рассматривать только относительно стабильные и проч-
ные спирали, а затем к полученной вторичной структуре добавить тополо-
гически совместимые спирали.
При анализе совместимости спиралей указывалось, что частично сов-
местимые спирали могут плавно перетекать одна в другую. Эти соображе-
ния позволили интерпретировать процесс формирования вторичной структу-
ры как исключительно динамичный, в течение которого невозможно выде-
лить статическую картину расположения спиралей. Все эти, вместе взя-
тые, соображения приводят к мысли о том, что реально не существует
постоянная и неизменная структура, а есть некий остов из прочных спи-
ралей, к которым пристраиваются мелкие спирали. Быстрые образования и
разрушения этих спиралей, а также перетекания спиралей создают впечат-
ления, что молекулы "дышат". По-видимому, эти быстрые изменения вто-
ричной структуры позволяют молекуле РНК более гибко выполнять свои би-
ологические функции.

Рассмотрим теперь моделирование марковского процесса структурных
перестроек.Для этой цели используется метод Монте-Карло. Предположим,
что предварительно рассчитано, что число потенциальных спиралей равно
И. Пусть на некотором этапе процесса образована структура из т
спиралей {5,,... ,5П). Из этого состояния возможны следующие переходы:
или образование одной из оставшихся спиралей 5и+1,...,5Ы или, если по-
линуклеотидная цепь еще не полностью синтезирована, удлинение ее на
один нуклеотид. Константа скорости роста цепи по некоторым имеющимся
данным зависит от последовательности ДНК, с которой идет транскрипция.
Однако обычно при расчетах эта величина принимается постоянной и рав-
ной 30-50 с'1. Кинетические константы образования для оставшихся спи-
ралей рассчитываются согласно формуле (6.2).После этого находим эффек-
тивную константу скорости перехода к=Ек1. Номер перехода, т.е. номер
образующейся спирали 1, определяем, моделируя реализацию г случайной
величины, равномерно распределенной на интервале [0,к] из условия

1-1 ।

Е к, < г < Е к, .
1=1	1	1=1 1

Затем осуществляем соответствующий переход - образование 1-й спирали
или удлинение цепи.

Время перехода определяем также, пользуясь методом Монте-Карло. Мо-
делируем случайную величину ф, распределенную по закону Пуассона (6.3)
с пара ;етром к. Реализация Ф этой случайной величины определяет время
перехода. Затем счетчик реального времени увеличиваем на I с и перехо-
дим к следующему этапу уже с новым состоянием. Процесс прекращается по
достижении заданного значения времени. Для получения распределения ве-
роятностей марковский процесс структурных перестроек необходимо повто-
рить достаточно большое число раз (М). Точность распределения-вероят-
ностей можно оценить величиной 1/ М. Достаточно хорошую качественную
картину можно получить при М=100 (точность =10%).Для более точных оце-
нок можно использовать М=1000 (точность =3%).
Существенное отличие предложенного алгоритма от рассмотренных выше
кинетических методов заключается в том, что анализируется время каждо-
го перехода. Использование вероятностных методов для выбора реального
времени позволяет проанализировать кинетику процесса.В результате рас-
считывается кинетический ансамбль вторичных структур, статистические
веса которых зависят от времени.

6.5.	РЕЗУЛЬТАТЫ ПРЕДСКАЗАНИЯ КИНЕТИЧЕСКОГО АНСАМБЛЯ ВТОРИЧНЫХ
СТРУКТУР РНК

Анализ кинетики формирования вторичной структуры тРНК. Наиболее
удобным объектом для проверки методов предсказания вторичных структур
РНК являются транспортные РНК, вторичные структуры которых хорошо из-
вестны и экспериментально подтверждены. Рассмотрим для примера процесс
образования вторичной структуры предшественника тРНКА1а из ВогпЫх тог1
в процессе транскрипции. Молекула предшественника состоит из 98 нукле-

Р и с. 6.10. Кинетический ансамбль вторичных структур пре-ФРНК из
ВотЬух тогу

а - формирование вторичной структуры в процессе роста цепи; б
распределение вероятности по кинетическому ансамблю. Кривая Ь показы-
вает рост полинуклеотидной цепи в зависимости от времени

отидов. В работе (СагЬег.Са^е, 1979) экспериментально был исследован
процесс синтеза и процессинга молекулы РНК и поэтому есть возможность
сравнить теоретические и экспериментальные результаты.

Расчет показал (рис.6.10), что через 0,6 с после начала транскрип-
ции цепь состояла из 28 нуклеотидов, которые образовали вторичную
структуру А, состоящую из одной спирали I. Эта спираль соответствует
ТС - стеблю зрелой тРНК. Как видно из рис. 6.1С,б, эта структура -
единственная возможная при данной длине РНК.

Примерно через 1,5 с цепь увеличилась до 60 нуклеотидов. В этот мо-
мент времени наиболее вероятно образование двух структур В и С (веро-
ятности 0,36 и 0,24 соответственно ), причем структура С содержит спи-
раль с антикодо'новой петлей. Хотя структура В более вероятна, но этот
путь процессинга оказался тупиковый. Из рис. (6.10,6) видно, что веро-
ятность образования этой структуры резко убывает. Спираль II распада-
ется и образуется спираль III, т.е. происходит переход к структуре С.
К этой структуре по мере роста цепи может достроиться спираль V и об-
разуется трехспиральная структура С.

Длина цепи достигает 80 нуклеотидов примерно через 2 с после начала
синтеза. Появилась возможность образоваться спирали IV. Таким образом,
формируется структура Е, когда к структуре В пристраивается спираль
IV. Возможен также другой путь процессинга - непосредственно из струк-
туры С формируется структура Е, соответствующая канонической структуре
"клеверного" листа. Однако к этому моменту времени вероятность образо-
вания структуры Р очень мала (0,12) и уступает вероятности образования
структуры Е (0,18). По-видимому, этот прямой путь формирования вторич-
ной структуры тРНК не является основным. Должны произойти значительные
структурные перестройки, чтобы эта наиболее энергетически выгодная
структура стала преобладающей. Заметим, что в это время существует до-
вольно большое количество структур, маловероятных и поэтому не указан-
ных на рис. 6.10.

Через 2,5 с вероятность структуры Р значительно увеличивается. Это
связано с тем, что структура Е оказалось неустойчивой, так как спираль
IV имеет сравнительно малое время жизни (0,7с) и при ее распаде воз-
можно образование существенно более стабильной спирали VI (время жизни
10бс). К концу рассмотренного интервала времени, через 3 с, вероят-
ность образования структуры Р достигла значения 0,58, значительно
превысив все остальные структуры.

Какие выводы следуют из анализа кинетики образования вторичной
структуры этой молекулы? По-видимому, основной вывод заключается в
том, что молекула может начать выполнять свои биологические функции не
ранее чем через приблизительно 2,5 с после начала синтеза. До этого
времени вероятность образования структуры типа "клеверный лист" слиш-
ком мала. При этом путь образования этой структуры оказался, так ска-
зать, непрямым, в различные моменты времени более предпочтительными
оказались другие структуры. Еще одно важное заключение - синтез допол-
нительного 3'- концевого участка молекулы предшественика не приводит к
образованию новой вторичной структуры и доминирующее значение структу-
ры Е остается.
Анализ влияния вторичной структуры мРНК на эффективность трансля-
ции. Приведем еще один пример использования кинетического подхода для
предсказания вторичной структуры РНК. Были рассчитаны вторичные струк-
туры мРНК ряда рекомбинатных плазмид, содержащие гены его белка
(1зегеп1апФ, Р1егз, 1980). Выбор объекта объясняется тем, что экспрес-
сия 'гена в этих плазмидах очень сильно зависит от нуклеотидной после
довательности нетранслируемой 5' части мРНК. Поскольку инициация тран-
сляции включает взаимодействие ЗОБ рибосомы с 5'областью перед геном,
то было предположено, что вторичная структура этой части РНК определя-
ет возможность контакта с рибосомой и влияет на частоту инициации
трансляции.

Рассмотрим более подробно участок РНК, включающий ЗВ последователь-
ность и стартовый кодон АНС у двух плазмид, наиболее сильно отличаю-
щихся друг от друга экспрессией гена его. На рис. 6. И, а изображен
участок РНК плазмиды с наиболее высокой экспрессией его гена. Действи-

Р и с. 6.11.Фрагменты наиболее
вероятных вторичных структур
РНК двух плазмид, несущих ген
его белка, на последователь-
ности выделены ЗБ участок и
стартовый кодон АНС

а - вторичная структура
фрагмента м-РНК, обеспечива-
ющей высокую экспрессию гена
его; б,в - вторичная струк-
тура фрагментов м-РНК, обеспе-
чивающей низкую экспрессию
гена его

тельно, во всех рассчитанных вторичных структурах кодон АНС всегда на-
ходится в петле и открыт для взаимодействия. Считается, что доступ-
ность стартового триплета более существенна для величины экспрессии,
чем место связывания с рибосомой. Большая часть нуклеотидов ЗВ после-
довательности также открыта, только два последних нуклеотида входят в
спираль I. Эта спираль практически всегда присутствует в структуре.
Правда, на рисунке указана еще одна спираль II, расположенная в центре
последовательности ЗБ, но это очень слабая спираль (время жизни 10‘2с)
и она частично совмещена со спиралью I. Можно предположить, что спи-
раль I будет формироваться полностью, вытесняя спираль II, тогда ос-
тавшиеся две пары А-Б и С-С не будут стабильны и распадутся. Следсва-
тельнс, большую часть времени функциональные участки узнавания и свя-
зывания с рибосомой будут доступны.

На рис. 6.11,6 и 6.И,в представлены аналогичные участки РНК другой
плазмиды, для которой синтез его белка имеет самую маленькую величину.
Из расчетов следует, что с вероятностью 70-80% будут образовываться
структуры со спиралями I, II и III. Как видно, большая часть 50 после-
довательности находится в спиральном состоянии.Нуклеотиды АИС старто-
вого кодона также образуют спираль I. и в этой ситуации взаимодействие
с рибосомой вряд ли возможно. Однако трансляция, хотя и в незначитель-
ной степени, все же происходит. Возможно, это объясняется тем, что
спирали I и II частично совместимы. Это означает в данном случае, что
почти все нуклеотиды, за исключением крайней С-С пары, могут образо-
вать другие комплементарные пары, относящиеся к спирале II. Этот без-
барьерный переход приведет фактически к вытеснению спирали I и к осво-
бождению нуклеотидов стартового кодона. На рис 6.И,в приведены фраг-
менты структур мРНК этой же плазмиды. Вероятность их образования 10 -
15%. При этом также возможны взаимные переходы спиралей. Однако из ри-
сунка видно, что перестройка спиралей IV и V не меняют картины и функ-
циональные участки остаются практически недоступны для рибосомы.

Из результатов анализа вторичных структур РНК видно, что при помощи
машинного эксперимента можно объяснить и главное предсказать величину
экспрессии, а также другие биологические свойства РНК.

6.6.	ЗАКЛЮЧЕНИЕ

Методы предсказания вторичных структур РНК получают большое расг
ространение в молекулярной биологии и генной инженерии. Анализ вторич
ных структур позволяет объяснить многие биологические явления.Первона
чально при определении структуры подсчитывалось число Уотсон - Криков-
ских пар и выбиралась Структура с наибольшим числом спаренных основа-
ний. Позже с появлением термодинамических параметров, характеризующих
вклад в свободную энергию различных комплементарных пар, а также одно-
цепочечных участков - петель, появилась возможность выбрать в качестве
критерия свободную энергию, причем на новом этапе снова были использо-
ваны те же подходы - перебор, методы динамического программирования и
кинетический алгоритм.

В качестве метода отбора оптимальной структуры в подавляющем боль-
шинстве случаев используется метод динамического программирования. Это
позволяет перебрать в обозримое машинное время огромное число вариан-
тов и выбрать одну оптимальную структуру. Недостатком этого подхода
является то обстоятельство, что рассчитанная единственная структура
может только на доли килокалорий отличаться от худших, которые будут
218
отброшены в процессе отбора.Понятно, что при неточном знании термоди-
намических параметров выбор энергетически наиболее оптимальной струк-
туры может оказаться ошибочным. Эти соображения заставили значительно
изменить этот алгоритм и в результате появилась возможность получать
не только оптимальную, но и структуры, близкие к ней по значению.

Многочисленные экспериментальные наблюдения за процессом образова-
ния вторичной структуры показали, что молекула РНК в процессе самоор-
ганизации может принимать различные формы, причем эти вторичные струк-
туры формируются с различной вероятностью. На возможность образования
различных структур для биологических молекул и соответственно сущест-
вование различных биологических функций у этих молекул указал еще 1975
г. Том (ТЬот, 1975). Он назвал такие структуры резонансными. Эти сооб-
ражения подсказывают, что для объяснения биологических функций РНК це-
лесообразно анализировать процесс образования молекулы. В ряде работ
делались попытки такого подхода.

Однако ко всем этим методам можно высказать замечание принципиаль-
ного характера. Дело в том, что в этих работах пытаются предсказать
равновесную вторичную структуру. В то же время анализ процесса образо-
вания пространственной структуры заставляет усомниться в целесообраз-
ности такой постановки задачи. Дело в том, что спиральные участки на-
чинают образовываться сразу по мере синтеза РНК. Рост цепи приводит к
всевозможным структурным перестройкам - спирали разрушаются и образу-
ются новые. Этот процесс не прекращается сразу и с окончанием роста
цепи. Трудно предположить, что сразу возникнет оптимальный набор спи-
ралей. Время релаксации к равновесию определяется характерными време-
нами структурных перестроек, которые в свою очередь определяются вре-
менами распада спиралей. Это время для спиралей с большим числом С-С
пар (например, 8-10 пар) может достигать 106с. Поэтому структура РНК
может очень долго релаксировать, скатываясь к своему минимуму. Вот
тут-то и возникает вопрос, так ли необходимо предсказывать равновесную
структуру,может быть, время ее образования превышает время жизни моле-
кулы РНК. Это, конечно, предельный случай, но возможность того, что
молекула РНК функционирует тогда, когда еще не образовалась равновес-
ная вторичная структура, вполне допустима. Напомним, что, исследуя
вопрос, в каких условиях среды может происходить самоорганизация,
Э.Шредингер писал в своей знаменитой книге (Шредингер,1972): " Живая
материя избегает прихода к равновесию".

Все сказанное заставило искать другой подход к проблеме предсказа-
ния вторичной структуры РНК. По-видимому, необходимо рассчитывать на-
бор структур оптимальных в каждый данный момент времени. Тем самым мы
приходим к задаче не поиска равновесной структуры, а к анализу самого
процесса, т.е. к исследованию кинетики самоорганизации молекулы РНК.
Можно сформулировать эту задачу как определение кинетического ансамбля
вторичных структур РНК - совокупности вторичных структур, статистичес-
кие веса которых зависят от времени. В дальнейшем развитие этого мето-
да пойдет по пути Долее адекватного описания процесса самоорганизации
вторичной структуры.

В заключение упомянем еше одну проблему, которая ждет своего реше-
ния. Речь идет о задаче взаимодействия двух молекул РНК. При этом мо-
жет существовать конкуренция между комплементарными участками в разных
цепях. Это обстоятельство сильно усложняет проблему предсказания вто-
ричных структур. Однако решение этой задачи поможет объяснить многие
биологические процессы. В частности, репликация плазмид в значительной
степени регулируется взаимодействием двух молекул РНК.
Глава 7. ОРГАНИЗАЦИЯ ХРАНЕНИЯ
МОЛЕКУЛЯРНО-ГЕНЕТИЧЕСКОЙ
ИНФОРМАЦИИ В БАЗАХ ДАННЫХ.
ПАКЕТЫ ПРИКЛАДНЫХ ПРОГРАММ
АНАЛИЗА НУКЛЕОТИДНЫХ
ПОСЛЕДОВАТЕЛЬНОСТЕЙ

Цель этой главы обозначить те вопросы, с которыми столкнется че-
ловек. который захочет практически приступить к работе на ЭВМ с ге-
нетическими текстами. используя те представления и методы, которые
были изложены в предыдущих главах. Для более полного ознакомления с
вопросами, которые рассматриваются здесь, рекомендуется обратиться к
компьютерным выпускам журнала Мис1е1с АсШз Кезеагсп (1982. Уо1. 10,
Цо 1; 1984. Уо1. 12, Ио 1; 1986. Уо1.14. Но 1). вышедшими также от-
дельными книгами под редакцией В.5о11, К. Л.ВоЬегФз, и книге "Ыис1е1с
ас!с1 ап-1 рго1е1п зе^иепсе апа1уз1з: а ргасЫса! арргоасЬ” под редак-
цией М, Д.В1зЬор, С.Ка»11п§з, 1987.

Весьма полезным является представление об информационно-вычисли-
тельном комплексе как о совокупности иерархически подчиненных уров-
ней, начиная от материаловедения и физики полупроводников до пред-
метной области конкретной науки. Предмет данной главы - отображение
предметной области молекулярной биологии и генетики на вычислитель-
ную среду.

7.1.	АППАРАТНОЕ ОБЕСПЕЧЕНИЕ. ТИПЫ ЭВМ. ТИПЫ ВНЕШНИХ НОСИТЕЛЕЙ

ИНФОРМАЦИИ

Для эффективной работы с большими массивами молекулярно-генети-
ческой информации необходимы компьютеры. Традиционно выделяется не-
сколько типов ЭВМ (Громов,1984): микро-ЭВМ. мини-ЭВМ, большие ЭВМ.
супер ЭВМ.

Эти типы выделяются по мошносги вычислительных ресурсов ЭВМ.
Прежде всего они отличаются по объему оперативной памяти. Объем па-
мяти ЭВМ является не единственной характеристикой, определяющей мощ-
ность машины. Важным параметром является также разрядность и коли-
чество основных регистров, разрядность шины, быстродействие и др.
Все эти характеристики в реальных ЭВМ взаимосвязаны. Чем больше объ-
ем памяти, тем больше необходимая разрядность регистров для эффек-
тивной работы и т.д. С развитием вычислительной техники, ее совер-
шенствованием и удешевлением условные границы между соседними клас-
сами ЭВМ смещаются в сторону более высоких значений.

Появление персональных компьютеров придало новый характер про-
цессу информационно-вычислительного общения исследователей с ЭВМ.
Вначале персональные компьютеры были 8-разрядными вычислительными
машинами (например, Арр1е И), в настоящее время в подавляющем боль-
шинстве они имеют 16-разрядные центральные процессоры. Появились об-
разцы 32-разрядных персональных ЭВМ, по своей мощности превосходящие
мини-ЭВМ недавнего прошлого.

Для долговременного хранения информации используются внешние но-
сители. Основными их типами являются магнитные диски с емкостью
2Мбайт-1Гбайт, магнитные ленты с емкостью 20Мбайт-1Гбайт, гибкие
магнитные дискеты с емкостью 128Кбайт-1,2Мбайт. На персональных
компьютерах получили распространение встроенные (несъемные) магнит-
ные диски типа "винчестер" с емкостью 5-120 Мбайт.

Различают внешние устройства прямого и последовательного доступа.
Накопители, использующие диски и гибкие дискеты, являются устрой-
ствами прямого доступа, т. е. в них возможен непосредственный дос-
туп к физической записи с заданным адресом И без необходимости про-
смотра всех промежуточных записей. В ленточных накопителях, в том
числе кассетных, для доступа к записи с адресом И необходимо промо-
тать ленту с текущего положения головки до этой записи. Поэтому слу-
чайный поиск на магнитной ленте требует много времени. В связи с
этим для доступа к базам данных информация с лент обычно переписыва-
ется на магнитные диски.

Из числа других периферийных устройств следует отметить печатаю-
щие устройства (принтеры). Наиболее часто используются принтеры с
лепестковым шрифтоносителем ("ромашкой") и матричные принтеры, в ко-
торых отпечаток литеры формируется при помощи иголочек. Они имеют
скорость печати 50-300 знаков в 1 мин. При помощи матричных принте-
ров можно печатать и графическую информацию. Для вычерчивания графи-
ков используются графопостроители различных типов.

7.2.	МОЛЕКУЛЯРНО-ГЕНЕТИЧЕСКИЕ БАЗЫ ДАННЫХ

Что такое "база данных"? Базу данных (БД) можно представить се-
бе как упорядоченный .набор данных, записанный на каком-либо носите-
ле. Данное - это число, логическая константа (типа "да" или "нет"),
либо фрагмент текста, имеющего смысл в данной БД. В реальных БД упо-
рядоченность может быть самой разнообразной в зависимости от пред-
метной области. Под выше приведенное определение попадает большой
контингент записанных знаний. Например, текст любой книги может слу-
жить примером БД, так как внутри себя этот текст определенным обра-
зом упорядочен. Для чего используется БД? Элементарный ответ - для
выдачи данного. Понятно, что из произвольного текста довольно трудно
извлечь необходимое данное, даже если оно там содержится в явном ви-
де. Дело в том, что художественное или научное сочинение как источ-
ник неформализовано и неформатировано.

Большую степень упорядоченности представляет собой постатейный
текст энциклопедий, справочников. Однако под БД обычно интуитивно
понимают высоко упорядоченный набор данных так, что можно говорить о
"формате" БД, т. е. о том, какая именно информация и в каких именно
позициях строки записана на носителе. Часто БД является набором от-
дельных записей, каждая запись относится к одному объекту реального
мира. Иногда запись (в особенности в библиографических БД) называют
вторичным документом в отличие от первичных документов, в которых
описываются реальные объекты. Разные стороны объектов описываются в
разных разделах записи, называемых полями. Записи сопоставляется
уникальное для данной БД слово - ее идентификатор. Объекты БД могут
иметь различные признаки, по которым объекты можно классифицировать
тем или иным способом. Ключом (ключевым словом) называется слово
(обычно из заранее обусловленного словаря), сопоставленное классу
объектов. Записи можно отыскать в БД по ключу или комбинации ключей.

При попытке фиксации знаний (что в первую очередь интересует ио
следователей) возникает две проблемы: формализация знаний и их фор-
матизация. В информатике традиционный путь накопления знаний - сос-
тавление фактографических БД.

Основные молекулярно-генетические БД. Объектами молекулярно-гене-
тических БД являются нуклеотидные, аминокислотные последовательнос-
ти, генетические карты, ферменты, нуклеотидные зонды и др. В настоя-
щее время основными молекулярно-генетическими БД (ВНоГзку еФ а!..
1986; Натт, Сатегоп, 1986; Сеог^е еФ а1., 1986) являются:

-	ЕМВЬ Нис1еоФ1с1е Бедиепсе Ва1а ыЬгагу (объем свыше 30 млн нуклео-
тидов, 1989);

-	ОепВапк ОепеИс Зедиепсе Ва1а Банк (свыше 30 млн нуклеотидов,
1989);

-	ЫВКР-Р1К РгоФе1п Зедиепсе БаФа Вазе (около 2 млн аминокислотных
остатков, 1989).

Постепенно пополняется отечественная БД нуклеотидных последователь-
ностей ГенЭкспресс - ВИНИТИ - ИМГ (12 млн нуклеотидов независимо
отреферированных последовательностей, 1989).

Представление молекулярно-генетических данных. Трудность задачи
формального представления знаний (имеются в виду области молекуляр-
ной генетики и молекулярной биологии) состоит в неабсолютной адек-
ватности форм представления знаний в научном языке объектам и явле-
ниям изучаемой предметной области, поскольку только через язык воз-
можна фиксация знаний. Кроме того, мы стремимся предвидеть и вклю-
чить з наши логические представления неизвестные (неоткрытые) явле-
ния. Мы должны смириться либо с необходимостью постоянного обновле-
ния логических построений, либо с их неполнотой.

В статьях (Еаутепсе, 1986; ЕгхеШапй е1 а1.,1982; ЗсИпеЫег е!
а1.,1982; БсНгоейег, В1а11пег ,1982; Соиу еФ а1.,1984) описаны моде-
ли представления нуклеотидных последовательностей с точки зрения мо-
лекулярного биолога (и соответствующие языки манипулирования данны-
ми ).

Рассмотрим одну из таких моделей данных, принятую с системе АС1ШС
(Соиу е! а1., 1984). Центральным понятием является последователь-
ность - участок генома, имеющий одну выделенную функцию. С ним ассо-
циированы следующие понятия: организм - биологический вид или таксо-
номическая группа любого уровня; категория - ключевые слова (для них
используется сетевая модель); тип - один из следующих девяти типов:
первичный транскрипт, зрелая мРНК, белок-кодирующий участок, интрон,
рРНК, тРНК, мяРНК, последовательность без уникального типа, все дру-
гие случаи; автор - авторы публикаций о данной последовательности;
ссылка - библиографические ссылки на последовательность; "материн-
ские поля" - известные непрерывные первичные последовательности. Эти
понятия могут иметь связанные с ними комментарии. Понятия последова-
тельность, организм, категория, тип, автор являются поисковыми.

Логическая структура БД нуклеотидных последовательностей.

БД ЕМВБ состоит из отдельных записей, каждая из которых относится к
одному участку генома или целому геному. Для этого участка хранится
нуклеотидная последовательность вместе с ее формализованным описани-
ем. Описание последовательности разбито на несколько полей, в кото-
рых описаны различные характеристики данной последовательности.

Таблица имен полей и их объяснение для БД ЕМВБ:

1В - идентификатор (уникальное короткое название).

АС - номер последовательности.
ВТ - дата ввода или изменения.
ВЕ - описание последовательности, включая все продукты, ею
кодируемые.

СТ - список ключевых слов.

ОБ - название организма.

Н5 - классификация организма.

ОС - название организма-хозяина (для вирусов, фагов и т.п.).

НС - классификация организма-хозяина.

Ю), НА, ВТ, ВБ - библиографическое описание последовательности.
СС - комментарий.

ЕН - заголовок таблицы особенностей.

ЕТ - таблица особенностей, список функциональных сайтов, областей на
последовательности, продуктов, кодируемых последовательностью.
модификаций нуклеотидов, список мутаций, разногласий вариан-
тов.

ЗД - поле статистики последовательности, за которым помещается сама
последовательность.

Аналогичные поля имеются и в других БД. В БД СепВапк вместо
таблицы РТ используется таблица сайтов и таблица особенностей.
В таблице сайтов описываются отдельные сайты или границы областей.
В ней приводятся координаты сайтов и их размер. В таблице особеннос-
тей отмечаются следующие области на нуклеотидной последовательности:
белок-кодирующая область, сигнальный пептид, зрелый пептид, области,
кодирующие тРНК и рРНК, мяРНК.

Отметим некоторые проблемы создания БД, не безразличные для поль-
зователя. Информацию для БД извлекают из текущего потока литературы
или получают непосредственно от авторов. Достаточно серьезную труд-
ность представляет собой своевременное отслеживание первичных источ-
ников (статей, книг, патентов и т.д.), имеющих отношение к теме.
В существующие БД последовательности поступают с некоторой задерж-
кой, иногда значительной и, кроме того, до одной трети всех последо-
вательностей не имеет описания.

Извлечение и формализация информации о последовательностях из
первичных источников в настоящее время ведется экспертами. Существу-
ет две точки зрения на то, кто является лучшим экспертом - автор
опубликованной последовательности или специально подготовленный ре-
дактор БД. С одной стороны, автор лучше всего знает свою последова-
тельность, но с другой - он субъективен в оценке своих результатов.
Для написания реферата недостаточно данных, содержащихся в первичном
источнике, необходимо привлечение общенаучных знаний. Экспертам так-
же приходится самостоятельно решать проблему достоверности знания,
делать обобщения и выводы и в соответствии с логической структурой
БД отражать их в реферате. Трудности усугубляются тем, что обрабаты-
вать приходится исследовательские и, следовательно, относительно не-
достоверные, ‘неустоявшиеся работы.

На этапе ввода информации в ЭВМ к возможным опечаткам в первичном
документе добавляются новые, которые лишь частично можно обнаружить
и скорректировать с помощью ЭВМ (применением двойного ввода, син-
таксического контроля и т.д.). При загрузке полученного вторичного
документа в БД возникает проблема увязки данной записи с уже имеющи-
мися в БД. В существующих БД значительный объем занимают дубли, воз-
никающие из-за независимого или намеренного секвенирования одних и
тех же участков генома. Например, один и тот же участок генома может
быть представлен как последовательность гена и одновременно в другой
записи как кодируемая им РНК. Кроме того, имеются близкородственные
последовательности, которые могут быть представлены как один объект
или как разные объекты.
Создатели БД решают указанные проблемы различными путями, поэто-
му разные БД имеют разное качество. Учитывая сказанное, пользовате-
лям БД следует иметь в виду, что они могут столкнуться с отчасти не-
достоверной и ошибочной информацией (см., например, гл.4.3, где опи-
саны проблемы создания выборок нуклеотидных последовательностей).

7.3. ПРЕДСТАВЛЕНИЕ ИНФОРМАЦИИ О НУКЛЕОТИДНЫХ ПОСЛЕДОВАТЕЛЬНОСТЯХ

Текстовое представление. Основной единицей хранения информации
на внешних носителях является файл данных. Файл можно определить как
логически объединенную область внешней памяти, имеющую свое имя. Со-
вокупность файлов образует файловую систему. Определенная область
внешней памяти обычно отводится под каталог файловой системы. Если
файловая система проста, например при последовательном расположении
файлов на магнитной ленте, каталог может отсутствовать.

Важным типом файлов на ЭВМ являются текстовые файлы. Это файлы,
логически состоящие из отдельных строк, отделенных признаком конца
строки. 3 строках содержатся обычные буквы, цифры и некоторые специ-
альные символы. Распространена кодировка текстовых файлов в коде
А5СП и ЕВСЭ1С.

Текстовые файлы являются наиболее стандартизованными файлами, и
поэтому они в значительной степени машинонезависимы. При кодировании
текстовых файлов общепринятым признаком конца строки является набор
из двух кодов СК/ЕР или в шестнадцатиричном коде ОВОА. В текстовом
файле могут содержаться и другие коды управления печатью, такие, как
переход к новой странице, коды табуляции, однако они не являются об-
щепринятыми и могут различаться для различных систем обработки текс-
та.

В п. 7.2 говорилось о том, что молекулярно-генетические базы дан-
ных содержат много описательной текстовой информаци. Кроме того, са-
ми последовательности также читаются в виде текста. Поэтому в целях
обеспечения переносимости дистрибутивные (т. е. готовые к передачи
пользователям) выпуски БД распространяются в текстовом представлении
с сохранением разделительных пробелов, отметок текущей длины, несмо-
тря на то, что значительный объем носителя информации, занятый соб-
ственно последовательностями, используется нерационально. Для эффек-
тивной работы БД переписываются магнитные диски в формате, отличном
от текстового.

Посимвольное представление. Нуклеотидные последовательности и
подавляющая часть белковых последовательностей являются линейной
(неразветвленной) цепочкой мономеров без знаков препинания. Интере-
сующая исследователя область может находиться в любом месте последо-
вательности. Для ускорения машинного доступа к таким областям удобно
226
представлять последовательности в виде непрерывной цепочки символов,
каждый из которых кодирует один мономер. В такой цепочке отсутствуют
пометки, введенные для облегчения визуального просмотра последова-
тельности или ее функциональной привязки. В наибольшей степени такой
модели данных отвечают файлы прямого доступа, которые поддерживают-
ся, по-видимому, на всех типах ЭВМ. Поэтому такое представление ши-
роко используется в системах обработки генетической информации. В
этом случае надо иметь в виду, что области, например диска, кодирую-
щие саму последовательность могут отрываться от областей, на которых
записано описание этой последовательности. Необходимые для визуаль-
ного просмотра метки, текущую длину, комментарии и т.д. вставляют
соответствующие программы обработки.

1-граммное представление. Посимвольное представление также явля-
ется расточительным, поскольку один мономер кодируется одним бай-
том (8 бит). Упаковка двух нуклеотидов в один байт применяется в
файлах последовательностей СепВапк'а, распространяемых на гибких
дискетах. Несколько усложняется доступ к отдельному нуклеотиду, но
принцип прямого доступа здесь сохраняется. Более сложные способы
упаковки будут рассмотрены в следующем разделе.

Стоит отметить еще один способ представления последовательностей
в некоторых системах. В этих системах последовательность нуклеотидов
превращается в последовательность перекрывающихся 1-грамм (см.гл.1).
Например, Т кодируется О, С- 1, А- 2, 0-3. Тогда 1-грамм коди-
руется целым числом в интервале от 0 до 4*-1, а последовательность
нуклеотидов превращается в последовательность целых чисел (рис. 7.1).
Такое представление используется в некоторых программах быстрого по-
иска гомологии (Ропйга! еФ а1., 1986).

ТСА О А А Т етА С

6____

27___

46___

58___

40

Рис. 7.1. 3-нуклеотидное кодирование последовательности. В резуль-
тате кодирования получается последовательность 6,27,46,58,40 ...

Сжатие информации. Сжатие (синоним упаковка) представляет собой
однозначно декодируемую перекодировку последовательности. Коэффици-
ентом сжатия К будем называть отношение количества байтов, занимае-
мых посимвольным представлением, к количеству байтов, занимаемых пе-
рекодированной, сжатой последовательностью. Таким образом, для по-
символьного представления коэффициент сжатия равен единице. Введем
также среднюю длину кода:

Ь=Е сТр(.

1

где - длина кода для 1-й буквы; р1 - вероятность 1-й буквы.

Для информации, записанной байтами К = 8/Ь.

Существует по крайней мере два способа сжатия информации: не ис-
пользующий и использующий статистические свойства последовательности
символов. Очевидно, что в первом случае для последовательности с ал-
фавитом из четырех символов максимальное сжатие информации возможно
с коэффициентом 4 (метод 1). Для последовательности, где допускается
5 символов Т,С,А,С,II, коэффициент сжатия не превышает 8/10225=3,445
(метод 2).

Выбор того или иного метода сжатия зависит не только от выигрыша
в объеме внешней памяти, но и от других обстоятельств, а именно зат-
рат на раскодировку, выигрыша в длительности считывания информации
из внешней памяти, обеспечения возможности прямого доступа и др.

Раскодировка в методе 1 проста на любом языке программирования,
в котором имеется возможность работы с отдельными битами. В методе 2
алгоритм раскодировки несколько сложнее. Можно закодировать последо-
вательности, упаковывая тринуклеотиды в один байт (метод 3), коэффи-
циент сжатия равен трем. Раскодировка осуществляется довольно прос-
то. По этому же принципу можно закодировать 1-грамму в т байт. При-
ведем коэффициенты сжатия для пятибуквенного алфавита для различных
значений ш (П обозначает целую часть числа):

Коэффициент сжатия

Г 8т

т 1	----- /т

1 1оёг5 ;

1	3	3

2	6	3

3	10	3,33

4	13	3,25

5	17	3,4

Таким образом, в случае т=5, 1=17 коэффициент сжатия близок к
предельному.

Рассмотрим статистические способы кодирования. В методе 2 каждый
из пяти символов кодируется одинаковым количеством бит. При этом
редко встречающийся символ И кодируется неэкономно. Справедливо ут-
верждение (см.Марков, 1982, с.165-166), указывающее предельную вели-
чину сжатия: средняя длина кода, оптимального в смысле длины

1_(В*,Р)=Н(РЫ(Р),

где 0<=Г(Р)<1; Р={р(} - распределение вероятностей для букв алфави-
та: В* - множество сообщений из букв алфавита, удовлетворяющее неко-
торым дополнительным условиям, которые мы здесь не будем указывать;
Н(Р)=-ьр,1о22Р, - шенноновская энтропия. Можно показать, что величи-
на 1'(Р) с помощью блочного кодирования может быть сделана сколь
угодно близкой к 0. Таким образом, среднюю длину кода можно сделать
сколь угодно близкой к величине энтропии последовательности в расче-
те на одну букву. Заметим, что сама величина энтропии зависит от мо-
дели порождения текста (см. "Представление молекулярно-генетических
данных").

Алгоритм построения оптимального кода был предложен Хафманом (см.
Марков, 1982). Приведем пример оптимального кода. Будем считать,
1 1

что веооятность появления Т.п,А,С равна р— - -р(Н), а вероятность
4	4

появления р(М)< -р. Идея статистического кодирования соо,,'огг г тггл
что наиболее вероятные символы кодируются коротким кодовым словом,
редкие - /длинным. Закодируем Т=00. С=01, А=10, 0=110, Н=111. Можно
показать, что э^от код является однозначно декодируемым. (Обеспече-
ние однозначной декодируемости является причиной того, что одна из
букв Т, С, А, С, все равно какая, кодируется тремя битами.) Средняя
11	11

длина кода 1-Зр(Ю+3*2( - -р(П))+3(- - -р(П)) = 2,2ь+0,75р(Ю бит.
4	4	4	4

Коэффициент сжатия в этом случае равен 3,55. Это еще не предел. При
кодировании 1-граммы имеется 4: "хороших" 1-граммы, т. е. не содер-
жащих Л, и 5‘-4‘ "плохих" 1-граммы, они имеют малую вероятность.

Пусть вероятность "плохой" 1-граммы не превосходит р, а сумма
вероятностей всех "плохих" 1-грамм не превосходит вероятности любой
из "хороших". Закодируем 4‘-1 "хороших" 1-грамм 2*1 битами, 1 "хоро-
шую" 1-грамму 2к+1 битами. й=5‘-4! "плохих" 1-грамм 2*1+п битами,
где п наименьшее число, определяемое из условия 2”>5’-4‘. Тогда К
можно оценить следующим образом: при 1=3, так значение К=3,98,
д-5’10’5; 1=4, тах значение К-3,99, о=7*10'6. Используется также сжа-
тие текстовой информации с использованием словарей. Обсуждение соот-
ветствующих методов выходит за рамки книги. Таким образом, как пра-
вило, информация, хранящаяся в компьютере, совсем не похожа на ту,
которая записана на дистрибутивных носителях.

7.4. УПРАВЛЕНИЕ БАЗАМИ ДАННЫХ

Важнейшим видом матобеспечения ЭВМ являются системы управления
базами данных (СУБД), т. е. системы для хранения структурированных
данных и доступа к ним по запросам пользователя (Кокорева, Малаши-
нин, 1984; Дейт, 1980). В настоящее время разработано значительное
число СУБД для ЭВМ различных типов, и число их растет. Это связано с
тем, что разработчики СУБД стремятся удовлетворить все возрастающие
потребности в этих системах. Можно согласиться с тем, что не сущест-
вует универсальной СУБД, одинаково пригодной для любых типов данных
(или моделей данных), и обычно каждая СУБД, кроме того, что она рас-
считана на определенную модель данных, оптимизируется для относи-
тельно небольшого диапазона значений данных. Это и понятно. Трудно
представить себе, что одинаково эффективно в одной и той же СУБД
можно хранить, осуществлять доступ и изменять такие данные, как кад-
ровые данные большого предприятия, пространственные модели машиност-
роительных деталей и первичные последовательности нуклеиновых кис-
лот. Несравнимы и типы запросов, которые предъявляются к этим систе-
мам.

Таким образом, имея в виду перспективы увеличения объемов молеку-
лярно-генетических БД, мы приходим к выводу о небходимости создания
специализированной СУБД в особенности для малых машин. Небольшие по
объему последовательностей БД можно поставить под управление СУБД
общего назначения, таких, как йВАБЕШ или В: 5000 на микро-ЭВМ.

Следует иметь в виду, что СУБД обычно не существуют сами по себе,
а входят в состав информационно-поисковых систем, интегрированных
пакетов (т. е. пакетов, осуществляющих большую часть стандартных
операций над данными), систем интерактивной инженерной графики и
т.д. СУБД в них выступает ядром программной части, связывающей БД на
внешнем носителе с интерфейсом пользователя (т. е. с теми программа-
ми, с которыми непосредственно общается пользователь).

Остановимся подробнее на функциональной части. Ниже идет список
запросов, на которые может ответить -специализированная СУБД.

1.	Создание подбазы данных по совокупности явных признаков. Напри-
мер, создание БД РНК В. зиЫШз.

2.	Поиск по ключу, например по ключу "глобиновые гены”.

3.	Внесение новых записей в БД.

4.	Создание новых записей путем объединения или расчленения старых.

5.	Статистика ключевых слов БД.

6.	Создание списка фрагментов открытых рамок трансляции для данного
биологического вида, например ДНК Н. зар!епз.

7.	Создание подвыборки последовательностей окрестности функциональ-
ных сайтов, например точек инициации транскрипциии по записям ко-
ординат промоторов в таблице особенностей.

8.	Статистика БД, например составление таблиц использования кодонов.
9. Сравнение данной последовательности с банком.

Перечислим несколько примеров реализации СУБД.

1.	ИПС ПОИСК (версия 1.2, ВИНИТИ) (Анев и др.,1982). Позволяет вести
БД большого объема порядка нескольких сот мегабайт. (Запросы
1,2,5, запросы 3,4 выполняются администратором БД.)
2.	Интегрированная система МВ15 (С51К0, В1у1з1оп о! Мо1еси1аг
В1о1о2У, АизТ.гаИа) для ЭВМ УАХ 11/750 (ВисЬоИз, Йе1зпег, 1986).
Позволяет одновременно работать с пятью заданными БД и выполнять
запросы 1,2,9.

3.	Информационная подсистема ВВфЕЗТ системы СЕИЕОБ для ЭВМ БЕС
УАХ/УМБ (Швеция) (Нагг еФ а1.,1986). Запросы 1,2.

4.	Поисковая подсистема (1ЕДЕМАМ пакета программ ВДАЗТАК для 1ВМ РС.
Запросы 1,2,9, имеется возможность широкого информационного поис-
ка по полю 54 (см. п.7.8) (Во^еФФ, В1аФФпег,1986).

5.	Библиографически ориентированная информационно-поисковая система
15 для микро ЭВМ "Искра-226" (Шепелев и др.,1986). Позволяет вес-
ти БД объемом до 2М. Способна выполнить запросы 1,2,3,4,5.

7.5.	ОРГАНИЗАЦИЯ ДАННЫХ НА ВНЕШНИХ НОСИТЕЛЯХ.

ПЕРЕДАЧА ДАННЫХ НА ВНЕШНИХ НОСИТЕЛЯХ

БД молекулярно-генетической информации могут передаваться из
центров, в которых они создаются, на магнитных лентах или дисках. Не
утратили своего значения представления БД в виде отпечатанных типог-
рафским способом книг. Кроме собственно БД в дистрибутивный вариант
могут включаться различные каталоги, указатели, облегчающие исполь-
зование БД человеком или машиной, программы доступа к БД и т.д. Соб-
ственно БД может содержаться в отдельном файле или может быть разби-
та на несколько отдельных файлов. Разбиение диктуется как объемом
памяти носителя (обычно разбиение делается для дискет, так как маг-
нитные ленты имеют достаточную емкость для размещения всех файлов),
так и логикой БД. Например, рассмотрим организацию файлов БД СепВапк
(выпуск 44.0, август 1986г.), распространяемой на дискетах объемом
320К. Вся информация размещена на 26 дискетах. На 23 из них находят-
ся: 1) файлы собственно нуклеотидных последовательностей; 2) файлы
сокращенных описаний последовательностей (БД с полным описанием пос-
ледовательностей требует слишком большого числа дискет), 3) индекс-
ные файлы, используемые СУБД. Все последовательности содержатся в 54
файлах, в каждом из которых они сгруппированы по таксономическому
признаку. Таким образом, каждая дискета содержит от одного до четы-
рех файлов последовательностей и соответственно описаний. 24-я дис-
кета содержит файлы указателей БД, 25-я - файлы СУБД, 26-я - файлы с
программами, выполняющими различные функции с нуклеотидными последо-

вательностями.
7.6.	ИНТЕРФЕЙС ПОЛЬЗОВАТЕЛЯ (ЯЗЫКИ ВЗАИМОДЕЙСТВИЯ)

Работа с удаленными и распределенными БД по линиям связи,
В настоящее время в мире нашли широкое применение сети ЭВМ, охваты-
вающие целые страны и континенты. Локальные вычислительные сети объ-
единяют информационно-вычислительные ресурсы в пределах небольшой
территории, на расстоянии нескольких километров. Скорость передачи
данных может достигать десятков миллионов бит в 1 с. Станциями здесь
называются единицы оборудования, будь то отдельная ЭВМ, терминал,
печатающее устройство, коммутационное устройство или другая локаль-
ная сеть. Станции сообщаются между собой на основе определенных пра-
вил, называемых протоколом. За рубежом наибольшую популярность полу-
чила локальная сеть, называемая ЕТНЕКЛЕТ (Мартин, 1985; Громов,
1984'.

Для сообщения на больших расстояниях используются линии связи об-
щего назначения, в частности телефонные линии связи. Для передачи
дискретных (цифровых) сигналов по таким линиям связи необходимо спе-
циальное устройство - модем, которое преобразует дискретный сигнал в
аналоговый, соответствующий пропускной способности линии, и обратно.
В настоящее время имеются модемы, обеспечивающие передачу со ско-
ростью до 2400 бит в 1 с (обычно 300 бит в 1 с). Для специальных це-
лей могут использоваться высокоскоростные линии связи, техническая
скорость передачи данных может достигать 1 гигабит в 1 с.

В Северной Америке, Европе, Японии существует целый ряд сетей,
таких, как ВI ГНЕТ, ЕАР.11, ТЕАМЕРАС. С АТ АРАС, ТЕЕЕНЕТ, 1Р55, АКРАНЕТ,
ТУШЕТ, АСЕЕМЕТ, ДАМЕТ и др. В СССР работает Государственная автома-
тизированная система научно-технической информации (ГАСНТИ) (Мали-
нин, 1987).

После подключения к системе пользователь со своей удаленной стан-
ции получает доступ к информационно-вычислительным ресурсам сети.
Объем этих ресурсов определяется помимо наличных ресурсов протоколом
высокого уровня, обеспечивающего пользователя известным уровнем до-
ступа к прикладным системам, реализованным в сети. По отклику систе-
мы пользователь, вообще говоря, не может установить, с каким именно
оборудованием он работает. Чаще всего люди используют сети для полу-
чения информации. Нашли распространение такие прикладные системы,
как электронная почта, электронные конференции и, что больше всего
нас интересует, работа с базами данных. К настоящему времени извест-
но порядка 3 тыс. различных БД. В некоторых из них накоплены сотни
тысяч вторичных документов. В виду этого прикладные системы могут
размещать отдельные файлы БД на разных физических устройствах, нахо-
дящихся в любом месте сети, тем самым БД превращаются в распределен-
ные. Систему, включающую в себя прикладные программы и БД, можно на-
звать банком данных. Так, в режиме теледоступа работают СепВапк.
ЕМВЬ, Р1Й-НВКЕ. В СССР в системе ПОИСК в ВИНИТИ возможен доступ к БД
ЕМВЬ (Анев и др., 1982). ПОИСК обеспечивает различные виды информаци-
онного поиска: библиографический, по ключевым словам и другим деск-
рипторам (описательным признакам) последовательности.

Прикладные системы (КиЬага еФ а1.,1982; КапеЫза еФ а1., 1982;
Беуегеих, 1982; РизФеИ, КаТаФоз, 1986; Нагг еФ а1., 1986; и др.)
обеспечивают специфическую работу с молекулярно-генетическими БД:
поиск по банку, вызов различных программ анализа, статистики и т.д.
Для этой цели создаются также национальные службы (8т1Ф11 Б.Н. еФ
а1.,1986; РКОРНЕТ,...,1986; 5ш1ФЬ Т.Е. еФ а1., 1986; и др.)

Работа на персональном компьютере. Большую популярность завоевали
прикладные системы, реализованные на персональных компьютерах (ПК).
С точки зрения пользователя работа на ПК имеет ряд ощутимых преиму-
ществ.

1.	Независимость от большой машины. Персональный компьютер внешне
похож на терминальное устройство. Поскольку в отличие от терминала
ПК для своей работы необязательно должен быть связан с большой ЭВМ,
на нем можно работать в удобное время, в удобном месте и в удобном
темпе.

2.	Удобство (комфорт). ПК характеризуется высокими эргонономичес-
кими качествами, надежен, практически не требует квалифицированного
обслуживания.

3.	Сравнительно мощные ресурсы.

4.	Развитое математическое обеспечение (МО). Поскольку тираж ПК
очень большой (сейчас эксплуатируется порядка 100 млн ПК), для них
разработано большое количество разнообразного МО высокого качества
и, что самое ценное, ориентированного на работу неподготовленного
пользователя. Эта ориентированность на пользователя, пожалуй, самое
важное свойство ПК. Для массы самых разнообразных применений ПК при-
думано огромное число способов, приемов, методов общения пользовате-
лей с ПК (иначе это называется интерфейсом пользователя). Остановим-
ся только на некоторых моментах.

Интерфейс типа "командный язык" Это тип интерфейса, когда пользо-
ватель отдает команды машине на псевдоестественном языке. Например,
в пакете программ ПНАЗТАК (По§2еФФ,В1аФФпег, 1986) запрос

ТГСАСА %83 >> (22,24) ТАТААТ %50 /БЕ0<пробел><пробел>
означает поиск промоторов в БД, а именно консенсуса "-35" при 83%
гомологии и консенсуса "-10" при 50% гомологии при расстоянии между
их 5' концами от 22 до 24 нуклеотидов в классе 8Е<2. Недостатки тако-
го языка: сложность освоения случайным пользователем (т. е. пользо-
вателем, обращающимся к прикладным системам от случая к случаю),
сравнительно медленная скорость набора команд, сильная неустойчи-
вость к ошибкам пользователя. Положительная сторона: сравнительно
высокая гибкость. Язык такого рода редко используется в системах
анализа нуклеотидных последовательностей.
Интерфейс типа меню. Меню - это набор альтернатив продолжения ра-
боты, предоставляемый пользователю. С помощью меню можно выразить
достаточно сложные запросы к прикладной системе, в то же время поль-
зователю не нужно учить командный язык. Выбор осуществляется нажати-
ем одной-двух клавиш, достигается высокая степень наглядности, при
длительной работе с системой вырабатывается автоматизм. Этот интер-
фейс очень широко применяется (Саппоп,1987; 1зопо, 1984).

Интерфейс типа макетный запрос (0иегу-Ьу-ехап1р1е). Все разнообра-
зие задач и подзадач, параметров и т.д. не исчерпывается набором
альтернатив. Поэтому при выборе из большого спектра возможностей,
например при задании фрагмента последовательности, используются дру-
гие средства. Кроме того, в сложных программах со множеством функций
многоуровневые меню утомительны, особенно при многократном повторе-
нии одних и тех же действий. В этом случае удобен интерфейс типа ма-
кетный запрос (Чиегу-Ьу-ехатр1е) (ППшап, 1982). Представим себе,
что программа предлагает заполнить бланк, в котором какие-то позиции
заполнены названиями функций и значениями параметров, применяемых по
умолчанию. Вы какие-то позиции изменяете, заполняете пустые клетки и
запускаете программу. В дальнейшем уже не надо продираться через
частокол вопросов и ответов, даже самых коротких, так как программа
запомнила все необходимые параметры.

Многооконный интерфейс. Важную роль в популяризации многооконного
интерфейса сыграли ПК фирмы Арр1е. С другой стороны, именно тща-
тельная проработка пользовательского интерфейса, в котором важней-
шую часть занимает многооконный интерфейс, обеспечила фирме Арр1е
коммерческий успех, а также успех у пользователей.

Многооконный интерфейс можно уподобить приборной доске современ-
ного автомобиля или даже небольшого самолета. Экран разбивается на
несколько зон или окон, в каждое из которых выводится информация,
характеризующая различные стороны информационно-вычислительного про-
цесса. Эти окна могут перекрываться, более нужные могут вытеснять
менее нужные, расширяться, исчезать и т.д. Многооконный интерфейс
может быть создан на различном программном уровне. В настоящее время
он обычно выполнен на уровне операционной оболочки (подробнее см.,
например, Мазурик, 1987).

Приведем в качестве примера одну из картинок пакета программ
1В1/РизФе11 (РизФеП, КаГаФоз, 1986) (рис.7.2). На экране показаны
окна:
сверху: 1) текущее устройство ввода-вывод;

2)	объем свободной памяти;

3)	текущее состояние клавиатуры;

4)	текущая дата и время;

5)	название текущей задачи;
Рг1п1ег Мет=200000

Ггх Лап 01,1988

=^=О 15 к [ 0 в Г ] ==^=

---Рго1е1п ТехХ—

РС18Р

----ПИА Тех!----

АСТКОА

5У40

---1/0 + Гогта!—
ПИАЮПЬЕ

—МоЫ111у 5148—
ОМА_ЗТЕ

1В1/РизХе11 Бедиепсе Апа1уз1з Ргодгавз В ь	.

_ _Пд<апН ра^Ь	...  С:\МТ01К\	1  20000000 Ьу1ез	сарасИу	«  10000000 Ьу1ез	ауаНаЫе	|	г- Метогу	.  		  5У40	а1з  	К_ККА	  АСУКСА	а*5

| С:\ОАТАВ\

1 Не1р 2 ОиИ 3 Ои1ри14 Ргхп! 5 Вгоизе6Ь0А0а1з7 51а1з 8 Кепате9ГипсН1рОСигзН1р

Рис. 7.2. Пример многооконного интерфейса в пакете программ 1В1-
РизФе11

внизу: 1) текущие функции ключей.

В центре могут находиться различные окна:

1)	главное меню;

2)	окно для установки даты и времени;

3)	окно, в котором описывается текущая задача;

4)	название основной и вспомогательной директории на диске;

5)	перекрестные указатели БД;

6)	каталог файлов, загруженных в память;

7)	скользящее окно каталога рабочей директории.

Заметим, что для оживления диалога, придания ему динамизма,
удобства ввода графической информации или целеуказания в современных
прикладных системах используются дополнительные средства: синтезатор
речи, музыки, манипулятор типа "мышь", указатель на экране (световое
перо), диджитайзеры (координатографы).

7.7.	СТАНДАРТНЫЕ ФУНКЦИИ ПРИКЛАДНЫХ ПАКЕТОВ АНАЛИЗА

Программы, которые необходимы большинству пользователей, включают
в себя следующие ставшие стандартными функции (Александров А.А. и
др., 1986; ЗФабеп, 1986):
- ввод и редактирование последовательностей, а также их описаний;
- поиск заданных олигонуклеотидов, включающих символы, кодирующие
неоднозначные нуклеотиды, а также поиск сайтов с неполной гомоло-
гией;

-	построение физических карт и таблиц фрагментов рестрикции по из-
вестной нуклеотидной последовательности, моделирование электрофо-
ретического разделения рестрикционных фрагментов;

-	трансляция последовательности в различных вариантах генетического
кода;

-	построение карт и таблиц потенциально транслируемых полипептидов в
заданном диапазоне молекулярных весов (так называемых открытых ра-
мок считывания);

-	распечатка таблиц использования кодонов и аминокислот, подсчет мо-
лекулярного веса и изоэлектрической точки полипептида, построение
карт гидрофобности и вторичной структуры белка;

-	поиск прямых, обратных и инвертированных повторов пс заданным па-
раметрам (в том числе несовершенных), графическое отображение пов-
торов на карте последовательности;

-	анализ и графическое представление гомологии двух нуклеотидных
последовательностей с заданными параметрами фильтрации (так назы-
ваемые точечные матрицы гомологии);

-	статистика последовательности, расчет встречаемости моно- и олиго-
нуклеотидов, расчет и построение функций ОС-содержания;

Некоторые пакеты программ имеют также расширенные функции, такие,
как:

-	поиск оптимальных зондов;

-	поиск сложных сайтов на последовательности или списке последова-
тельностей по заданной матрице частот встречаемости нуклеотидов;

-	поддержка проектов по секвенированию (стыковка и редактирование
фрагментов, их хранение);

-	моделирование генно-инженерных экспериментов.

Для больших ЭВМ и для наиболее развитых пакетов на мощных мини- и
микро-ЭВМ зто дополнительно:

-	выявление потенциальных вторичных структур РНК и оценка их энерге-
тических параметров;

-	оптимальное выравнивание двух близких последовательностей по за-
данным параметрам;

-	поиск гомологии между заданной последовательностью и всем банком;

-	физическое (рестрикционное картирование);

-	множественное выравнивание.

В настоящее время пакеты прикладных программ (ПШТ) анализа нукле-
отидных последовательностей представляют собой набор сравнительно
простых инструментов (хотя они могут быть реализованы при помощи
очень сложных алгоритмов, использующих мощные математические мето-
ды). Они взяли на себя механическую работу, но пока еще не стали ин-
теллектуальными помощниками пользователя. В основном машины могут
Пакет	Тип ЭВМ	Организация-разработчик	Литература
-	ЕС-1040	НИВЦ АН СССР (Пущино)	-
МОЛГЕН	ЕС-1060	ВНИИ молекулярной биоло- гии (Новосибирск)	-
МАЛИ	ЕС-1010	ВНИИ генетики и селекции промышленных микроорга- низмов (Москва)	Миронов и др.,1987
СЕЬ	СМ-4	Институт цитологии и генетики СО АН СССР	Жарких, Рогозин,1984
НЕШ	СМ-4	НИВЦ АН СССР (Пущино)	Лунина, 1984
Адаптация паке- та 1зопо	Электро- ника-бо	Институт молекулярной биологии АН СССР (Москва)	-
ЗЕЧВПБ	Искра-226	Институт молекулярной генетики АН СССР (Москва)	Голованов и др.,1986

сейчас оперировать лишь строгими фактами. Для исследователя имеет
значение знание, зафиксированное не только в отдельных, строго уста-
новленных "атомарных" фактах, но и гипотезы, факты, нуждающиеся в
проверке и интерпретации, теоретические обобщения, новые механизмы,
понятия. Эффективность оперирования с ними и составляет талант уче-
ного. Могут ли помочь в этом компьютеры, в особенности там, где на-
коплены большие БД?

7.8.	ОБЗОР ОТДЕЛЬНЫХ ПРИКЛАДНЫХ ПРОГРАММ И ФОРМЫ ВЫДАЧИ ИНФОРМАЦИИ

В этом разделе мы остановимся на некоторых программах, выполняю-
щих функции, перечисленные в разделе 7.7. В настоящее время создано
большое количество разнообразных ППП для анализа нуклеотидных после-
довательностей для всех основных типов ЭВМ. В той или иной мере они
перекрывают спектр функций, изложенный в предыдущем разделе. Подроб-
ные сводки имеющегося матобеспечения приводятся в работах Квина,
Корна, Роулингса и др. (Когп, Чиееп, 1984; Ка^Нп^з, 1986; В1гес1о-
гу..., 1987). Следует иметь в виду, что пакеты программ постоянно
совершенствуются, и такие сводки быстро устаревают. В СССР наиболее
широко используются следующие пакеты программ (см. таблицу), которые
охватывают почти весь спектр отечественных ЭВМ.

В связи с переходом на новую вычислительную технику, постепенным
освоением в СССР выпуска персональных ЭВМ (имеются в виду в частнос-
ти Искра-1030, ЕС-1840 и другие перспективные типы ЭВМ, в том чи-
сле разработки стран-членов СЭВ), в организациях - участницах Все-
союзной программы "Генинформ", а также странах - участницах КП НТП
СЭВ - ведется интенсивная работа по созданию нового программного
обеспечения в области молекулярной биологии и генетики. Можно наде-
яться, что в ближайшем будущем персональные ЭВМ станут у нас обычным
оборудованием биологических лабораторий.

За рубежом наибольшей популярностью пользуются персональные ЭВМ
фирмы 1ВМ и совместимые с ними компьютеры. Для этого типа ЭВМ имеет-
ся ряд коммерческих продуктов, в частности ШШ 1В1 - РизФеИ,
М1сгоСеп1е, ВНАЗТАВ, ВНАБУБ (Саппоп, 1987; Ноу1е,1987), РС/Сепе. Эти
программные продукты являются показательными для рассматриваемого
рынка матобеспечения.

Важное значение имеют выходные формы ШШ. Особенно наглядны гра-
фические формы вывода информации. На рис.7.3-7.7 представлены неко-
торые примеры таких форм, полученных на пакете БЕСКОВ. На рис. 7.3
показан фрагмент рестрикционной карты 5У40ХХ. Слева обозначены имена

кт кт

СТКЫС

СТТА-4С
ссмсс
СФКС
ятссят
сстисс
ТТТА-И
нсст
ССИТсс
ССРСС
сснсс
тентСИ
сснгчнммнгчтсс
сситс
РССССУ

Рис. 7.3. Пакет 5ЕЧВВ5. Программа 0>51Т2. Фрагмент рестрикционной
карты БУ40ХХ

сайтов (в данном случае рестриктаз), справа - соответствующие сайты
узнавания. Вертикальные черточки обозначают положение сайтов узнава-
ния. Черточки вниз - положение сайтов узнавания по обратной нити. На
рис. 7.4 показан фрагмент распечатки той же последовательности с
указанием имеющихся на ней сайтов. На рис. 7.5 изображена карта отк-
рытых рамок считывания для последовательности ТЕША. Более информа-
301 ААССААСТТССТСТТТСАСАССТТАТТТСАССССАТССТССТОСОССССС 350

ТТССТТСААССАСАААСТСТССААТАААСТССССТАССАССАСССССССС

~1®Ы<В> ~ЖЬ<1>

НАЕ1

~НАЕШ

ЖО1

"ВВУ51

~ВВУ1<1>

лСРК101

~ИГО4Н1

"ИРАН

"ПАЕ1

"ННА1

Рис. 7.4. Пакет 8Е0ВББ. Программа <2>5!Т2. Фрагмент распечатки после-
довательности 374ОХХ

Слева и справа указаны координаты последовательности. Точки над
последовательностью отмечают каждый десятый нуклеотид. Стрелка рядом
с названием рестриктазы указывает на первый нуклеотид сайта узнава-
ния. В угловых скобках для рестриктаз с непалиндромным сайтом указа-
но направление нити, по которой найден сайт: Г - прямая нить, I -
инвертированная

тивными являются подобные карты, на которых кроме открытых рамок
считывания приводятся графики вероятности кодирования белка (см. гл.
3), местоположение сайтов, напоминающих промоторы и терминаторы (см.
гл.4), а также других особенностей анализируемой последовательности.
Такие карты весьма полезны при характеризации участков генома
(БФайеп, 1986). Эту карту можно дополнить картой инвертированных
повторов (потенциальных шпилек, рис.7.6).

Одной из наиболее часто применяемых функций анализа последова-
тельностей является построение так называемых точечных матриц гомо-
логии (гл. 1). Эти матрицы, особенно при удачном подборе параметров
фильтрации, дают ценную информацию о гомологичных областях последо-
вательностей (рис. 7.7).

7.9.	ПЕРСПЕКТИВЫ

Первое направление - развитие программно-аппаратных средств. Бли-
жайшие перспективы в этой области связаны с быстрым развитием тради-
ционной вычислительной техники, увеличением быстродействия ЭВМ, уве-
личением объема памяти, усовершенствованием внешних запоминающих
устройств. В настоящее время становятся доступными БД и соответству-
ющее программное обеспечение на. оптических дисках, емкость которых
значительно перекрывает объем современных БД и накопленного матема-
тического обеспечения. Второе - создание автоматизированных рабочих
мест (АРМов) генного инженера и других подобных АРМов на основе мош-
н . 4 М-Ч Ч ^ЧЛ 1—! Ц, ,г ,1—I1-—1,
...41 II „5 ч. Ч .............Ь-Ц , . ЦЦ

I-1-----1-1---ш—।_____!____1—^ НН ।

г—............................./... Ч? ,

—1 г1 н^-0,	,, , /1-----11—1 , , |—Ь|	н

-—'н.к.г-Ч—и !—I?	Ч-Ц 4,1?^

©	2©	4©	б©	8©	1©© %

• Л ГТ 11.4	: - 1517 )

Рис. 7.5. Пакет 8Е(5В08. Программа у>РЕРТ. Карта потенциальных пепти-
дов для последовательности ТЕША

Слева указаны номера фаз трансляции. Внизу и вверху - масштабная
линейка. Горизонтальная линия на карте обозначает открытую рамку
считывания. Высокая черта выше этой линии обозначает инициирующий
кодон АВС, низкая - СВС. Открытая рамка заканчивается терминирующим
кодоном (длинная черта). Отдельные терминирующие кодоны указаны ко-
роткими штрихами. Пользователь может задать минимальный размер от-
крытой рамки считывания

ной ЭВМ, сопряженной с графической станцией, разработка высокоэффек-
тивных графических языков. Третье - новые методы анализа генетичес-
ких текстов, включающих как новые алгоритмы анализа отдельных облас-
тей, так и автоматизацию моделирования сложных генетических систем,
в которых анализ первичной структуры выступает лишь как один из
уровней исследования. Четвертое - переход от отдельных молекуляр-
но-генетических БД к интегрированным БД и, возможно, формирование на'
основе этого баз знаний (Стогний, Глазунов,1986). Пятое - постоянная
разработка концептуального интерфейса, т. е. гносеологических и со-
ответствующих им "естественных" (т. е. того, что обычно сужается до
понятия "общение на естественном языке") программных средств общения
исследователей и программных комплексов. Шестое - разработка средств
гибкого и эффективного управления гигантскими массивами информации.
С этой проблемой неизбежно столкнутся коллективы, которые в настоя-
щее время приступают к осуществлению проекта секвенирования генома
человека, содержащего приблизительно 3 млрд пар нуклеотидов. Трудо-
емкость этого проекта оценивается в 150-2000-30 000 человеко-лет, а
цена от 60 млн до 3 млрд долларов (ЕоЬег1з 1987а,Ь). Однако первич-
ная последовательность генома будет лежать мертвым грузом, если не
будет средств работы с ним. Уолтер Гильберт, основавший компанию Се-
поте СогрогаМоп, предполагает после завершения проекта по секвени-
рованию извлекать прибыль, обслуживая потребителей информации по че-
ловеческому геному. По-видимому, это перспективное дело.
Рис. 7.6. Пакет 5ЕСВП5. Программа СИСТЕМ. Схема инвертированных пов-
торов длиной 7 пар нуклеотидов на последовательности ТЕ! ПА, разде-
ленных не более чем 101 нуклеотидом. Выведены только совершенные
повторы.

На схеме повторы показаны равнобедренными треугольниками, сто-
роны которых соединяют два элемента повтора, а высота определяет
значимость повтора в условных единицах. Повторы заданного типа, как
видно из сравнения с рис.7.5, локализуются вблизи начала и конца
структурной части гена ТЕША

у -06/07 *1  ЗЕ-03

М5Р40ХХ (0000*1 -00-100

Рис. 7.7. Пакет ЗЕфВПЗ. Программа <3>КЕУЛ. Точечная матрица гомологии
между фрагментами 1-400 последовательности 5У40ХХ

Параметры фильтрации: точка ставится на матрице, если совпадают 6
нуклеотидов из 7. 1,3*10"3 - ожидаемая плотность точек на матрице.
Хорошо виден повтор длиной 72 пары нуклеотидов, а также серия более
мелких повторов вблизи начала последовательности
Приложение А

Таблица кодирования нуклеотидов, включая вырожденные

Основные нуклеотиды

Обозначение	Английское название	Русское название
А	Абеп1пе	Аденин
С	Су1оз1пе	Цитозин
0	Сиап1пе	Гуанин
Т	ТЬупппе	Тимин
и	Пгас!1	Урацил

Знаки, кодирующие набор нуклеотидов

Обозначение	Набор	Название
К  У  М  V  5  К  Б  Н  V  В  Ы  (пробел)	(А,С)	Пурин (Риг!пе)  (С.Т/11)	Пиримидин (Руг 1т1с11пе)  (А,С)  (А,Т/Ц)  (С,С)  (С,Т)  (А, С.Т/11)  (А,С,Т/П)  (А,С,С)  (С.С.Т/П)  (А,С,С,Т/Ц)‘  Нет никакого нуклеотида

‘Иногда этот набор обозначается знаком минус. Знак минус
используется также в базах данных в тех случаях, когда неиз-
вестно, какой нуклеотид стоит в данном положении.
ЛИТЕРАТУРА

Адельсон-Вельский Г.М., Диниц Е.А., Карзанов А.В. Потоковые алгорит-
мы. М.: Наука,1975.119с.

Александров А.А., Голованов Е.И., Сприжицкий Ю.А. Основные функции
пакетов прикладных программ анализа нуклеотидных и аминокислотных
последовательностей//Теоретические исследования и банки данных по
молекулярной биологии и генетике. Новосибирск,1986. С.61-64.

Александров Н.Н., Миронов А. А. Распознавание промоторов ЕзсЬетчсЫа
соИ по первичной структуре ДНК//Молекуляр. биология. 1987. Т. 20.
С.242-249.

Анев П.Д., Василева В.И., Матеева Ж.Ц. Интерактивная информационно-
поисковая система ПОИСК-1.2. Часть первая. Описание применения.
М.:МЦНТИ,1982. 32 с.

Бородовский М.Ю..Миронов А.А..Певзнер П.А. О значимости встречаемос-
ти слов в непрерывных текстах с учетом самопересечений//Математи-
ческие и вычислительные методы в биологии. Биомолекулярные систе-
мы. Пущино,1987.С.67-68.

Бородовский М.Ю., Сприжицкий Ю.А., Голованов Е.И., Александров А.А.
Статистические закономерности в первичных структурах функциональ-
ных областей генома Е.соИ 1.Частотные характеристики//Молекуляр.
биология.1986а.Т.20.С.1014-1023.

Бородовский М.Ю., Сприжицкий Ю.А..Голованов Е.И., Александров А.А.
Статистические закономерности в первичных структурах функциональ-
ных областей генома Е.соИ И. Неоднородные марковские модели
//Молекуляр. биология. 19866. Т. 20. С. 1024-1033.

Бородовский М.Ю., Сприжицкий Ю.А., Голованов Е.И., Александров А.А.
Статистические закономерности в первичной структуре функциональной
области генома Е.соИ. III. Компьютерное распознавание кодирующих
областей//Молекуляр. биология.1986в.Т. 20,Ы 5.С.1390-1397.

Бородовский М.Ю., Шепелев В.А., Александров А.А. Закономерности кон-
текстного смещения частот синонимических кодонов в Е. со11//Моле-
куляр. биология.1988.Т.22,И 3.С. 767-779.

Вапник В.Н. Задача обучения распознавания образов. М.:Знание, 1971.

Вапник В.Н., Глазкова Т.Г., Кощеев В.А., и др. Алгоритмы и программы
восстановления зависимостей. М.:Наука, 1984.816с.

Голованов Е.И. Статистические методы электронномикроскопического
картирования и математического моделирования функциональных сигна-
лов генома. Дис. .. канд. ф.-м. наук. М.,1987.124с.

Голованов Е.И., Шепелев В.А., Александров А.А. Система программ для
исследования нуклеотидных последовательностей на микро-ЭВМ "Иск-
ра-226"//Теоретические исследования и банки данных по молекулярной
биологии и генетике. Новосибирск,1986.С.59-60.

Громов Г.Р. Национальные информационные ресурсы: проблемы промышлен-
ной эксплуатации. М.:Наука, 1984. 240с.

Гусев В.Д., Куличков В.А., Титкова Т.Н. Анализ генетических текстов.

1. Ь-граммные характеристики//Вычислительные системы. Новосибирск,
1980.Вып.83. С.11-33.

Гэри М., Джонсон Д. Вычислительные машины и труднорешаемые задачи.
М.:Мир,1982.416с.

Дейт К. Введение в системы баз данных. М.:Наука,1980.

Доув У. Биологические выводы//Фаг лямбда. М.:Мир,1975.С.379-399.

Дэвидсон Н., Сцибальский В. Химические и физические свойства ДНК фа-
га лямбда/'/Фаг лямбда. М. :Мир, 1975.С.65-111.

Жарких А.А., Рогозин И.Б. СЕВ. ИНН для автоматизированного анализа
первичной структуры ДНК. Руководство к использованию. Новосибирск.
Препринт, 1984. 28 с.

Зыков А.А. Теория графов. М.:Наука,1987,381 с.

Кантор Ч., Шиммел П. Биофизическая химия Т.2.М.:Мир,1984. 493 с.

Карзанов А-В. О минимальных по среднему весу разрезах и циклах гра-
фа//Качественные и приближенные методы исследования операторных
уравнений. Ярославль,1985.С.75-82.

Кимура М. Молекулярная эволюция, теория нейтральности. М.:Мир, 1985.
С.177-222.

Кокорева Л.В., Малашинин И.И. Проектирование банков данных. М.:Нау-
ка, 1984. 256с.

Крамер Г. Математические методы статистики. М.:Мир,1975.

Крылов В.Н. Современные проблемы бактериофагии//Успехи микробиоло-
гии. 1985. Т. 20. С. 122-153.

Крылов В.Н., Ребентиш Б.А., Дебабов В.Г. и др. Изучение расщепления
ДНК новых лямбдоидных бактериофагов специфической эндонуклеазой
ЕсоВ1//Молекуляр. биология.1977. Т. 11.С.820-825.

Крылов В.Н., Цыганков Ю.Д. Новые лямбдоидные фаги ЕзскеПсЫа
со11//Генетика.1976.Т.12.С. 102-104.

Кульба А.М..Горелышев А.С..Фомичев Ю.К. Рестриктазный анализ ДНК фа-
га 5М Рзеибошопаз аеги21поза//Молекуляр. биология. 1986. Т. 20, И 1.
С.181-184.

Лунина Н.Л. Система обработки нуклеотидных последовательностей НЕ1В.
Материалы по математическому обеспечению ЭВМ. Серия мини-ЭВМ.
Вып.9. НИВЦ. Пущино,1984. 46с.

Льюин Б. Гены. М.:Мир,1987.С.21-54.

Лысов Ю.П., Флорентьев В.Л., Хорлин А.А. и др. Определение нуклео-
тидной последовательности ДНК гибридизацией с олигонуклеотидами.
Новый метод//Докл. АН СССР. 1988.7.303,11 6.С. 1508-1511.

Мазанов А.Л..Киселев В.И. Банк данных белков и нуклеиновых кислот.
Теоретические исследования и банки данных по молекулярной биологии
и генетике. Новосибирск,1986.С.32-35.

Мазурик В.П. Прикладные системы и решение задач// Персональные
компьютеры: информатика для всех. М.:Наука, 1987.С.102-144.

Малинин М.М. Об интенсификации научно-информационной деятельнос-
ти//Научно -техническая информация. Сер.2. Информационные процессы
и системы. М.:ВИНИТИ,1987.Ы 10. С.31-32.

Манькин А.С., Копылов А.М.. Рубцов К.Г., Скрябин К.Г. Модель вторич-
ной структуры 185 рРНК рибосом эукариот//Докл. АН СССР.1981.Т.256,
И 4. С. 1006-1010.

Марков А.А. Введение в теорию кодирования. М.:Наука,1982.192с.

Мартин Дж. Вычислительные сети и распределенная обработка данных.
Программное обеспечение, методы и архитектура. М.: Финансы и ста-
тистика. 1985, вып. 1. 256с,

Машко С.В., Козлов Ю.И., Генинг Л.В., и др. Распределение последова-
тельностей ДНК, узнаваемых специфическими эндонуклеазами//Молеку-
ляр. биология. 1977.Т. И.С. 1124-1135.

Миркин Б.Г., Родин. Графы и гены. М.:Наука,1977.240с.

Миронов А.А., Александров Н.Н. Быстрый метод поиска гомологий нукле-
отидных последовательностей//Биофизика. 1988Л 2. С. 229-232.

Миронов А.А., Александров Н.Н., Люсиновская-Гурова Л.В., Кистер А.Э.
Пакет прикладных программ для анализа нуклеотидных последователь-
ностей//Молекуляр, биология. 1987. Т.21, С. 672-677.

Миронов А.А., Дьяконова Л.П., Кистер А.Э. Предсказание ансамблей
вторичных структур РНК. Кинетический анализ самоорганизации// Мо-
лекул. биология. 1984. Т. 18,И 6. С. 1686-1694.

Миронов А.А., Кистер А.Э. Теоретический анализ кинетики образования
вторичной структуры РНК в процессе транскрипции и трансляции. Учет
дефектных спиралей//Молекуляр. биология.1985.Т. 19,И 5.С.1350-1357.

Миронов А.А. Кистер,А.Э. Теоретический анализ структурных перестроек
в процессе образования вторичных структур РНК//Молекуляр. биоло-
гия. , 1988. Т. 23, И 1. С. 61-72.

Певзнер П.А. Эффективный алгоритм упаковки ветвлений во взвешенном
графе//Комбинаторные методы в потоковых задачах. М.:ВНИИСИ,1979.
С.113-126.

Певзнер П.А. Задача о минимальном в среднем цикле и физическое кар-
тирование молекул ДНК//Дискретная оптимизация и компьютеры: Тез.
докладов III Всесоюзной школы-семинара, М.,1987.С.200-201.

Певзнер П.А. Рестрикционные графы и физическое картирование молекул
ДНК//Биополимеры и клетка.1988а.Т. 4,И 5.С.233-238.

Певзнер П.А. Эффективность фильтрации в методах быстрого поиска го-
мологий //Теоретические исследования и банки данных в молекулярной
биологии и генетике. Новосибирск,19886.

Певзнер П.А., Миронов А.А. Применение метода ветвей и границ для фи-
зического(рестрикционного) картирования молекул ДНК/7Тенетика и
биохимия микроорганизмов - биотехнологии,М.,1986.С.80.

Певзнер П.А., Миронов А.А. Эффективный метод физического картирова-
ния//Молекуляр.биология.1987а.Т.21,И 3.С.788-796.

Певзнер П.А., Миронов А.А. Выбор оптимальных олигонуклеотидных зон-
дов для локализации генов//Математические и вычислительные методы
в биологии. Пущино, 19876.С.85-86.

Пехов А.П., Щербакова Е. В., Медведкова Н.А., Кривская К.С. Рестрик-
ционное картирование фактора генетического переноса//Молекуляр.
генетика, микробиология и вирусология.1985,Т.З.С.19-22.

Ратнер В.А., Жарких А.А., Колчанов Н.А. и др. Проблемы теории моле-
кулярной эволюции. Новосибирск: Наука,1985.

Романовский. Алгоритмы решения экстремальных задач. М.:Наука, 1977.
352с.

Сагитов В.Р., Метлицкая А.З., Александров А.А. Избирательность рест-
риктазы Взрй! в отношении собственных сайтов на ДНК// Биополимеры
и клетка.1987.Т.З.С.289-294.

Спирин А.С. Молекулярная биология: Структура рибосомы и биосинтез
белка.М.:Высшая школа, 1986. 301с.

Сприжицкий Ю.А., Нечипуренко Ю.Д., Александров А.А., Волькенштейн
М.В. Закономерности сблоченности нуклеотидов в кодирующих и неко-
дирующих областях последовательностей ДНК из различных организ-
мов//Молекуляр. биология.1988.Т. 22,И 2. С.338-356.

Стефик М., Эйкинс Я., Балзер Р., и др. Экспертные системы// Киберне-
тический сборник. М.:Мир,1985,22.С.170-220.

Стэгний А.А., Глазунов Н.М. Современные проблемы создания интегриро-
ванных систем баз данных//Киберненика. Становление информати-
ки. М.: Наука, 1986.С.128-138.

Сумароков Л.Н. Перестройка системы научно-технической информа-
ции//Научно-техническая информация. Сер.2. Информационные процессы
и системы. М..ВИНИТИ,1987.И 9. С.1-4.

Туманян В.Г., Сотникова Л.Е., Холопов А.Е. Об определении вторичной
структуры РНК по последовательности нуклеотидов//Докл. АН СССР.
1966.Т.166,И 6. С.1465-1468.

Форд Л., Фалкерсон Д. Потоки в сетях.М.:Мир,1966.276 с.

Шепелев В.А., Голованов Е.И., Александров А.А. Информационнопоиско-
вая система 18 для ППЭВМ "Искра-226'*//Персональные компьютеры и
локальные сети. Новый Афон,1986.С.110-111.

Шеннон К. Работы по теории информации и киберненетике. М.: Изд-во
Иностр.лит.,1963.С.243-332.

Шредингер Э. Что такое жизнь? М.:Атомиздат,1972. 88с.

Эйген М. Самоорганизация материи и эволюция биологических макромоле-
кул. М.:Мир,1973. 216с.

АЬгетзИу К., ^аг<1 Б.Е. РЕА5М1В МАР: а ппсгосотриФег рго^гат Гог
Й1зр1ау апй зРога^е оГ р1азпий йаЬа//Сепе. 1986Ло1.46Л 1.Р.127-
130.

АШзоп Ь. Лее СЛ. Везйхсйоп зйе тарр1п§ 15 1п зерагайоп
1Ьеогу//Сотр.Арр1. В1озс1.1988.Уо1.4Л 1.Р.97-102.

А1та2ог Н. А Магкоу апа!уз1з о! ВНА 8едиепсе5//Л.Т11еог.В1о1.1983.
Уо1.104.Р.633-645.

А1та2ог Н. Мис1еоййе й1зй1ЬиЬ1оп апй йе гесо^пИхоп о! сосИпё
ге^хопз 1п ВИА зейиепсез ап йГогтаЫоп Йеогу арргоасЬ// Л.ТЬеог.
ВЮ1.1985. Уо1.117.Р. 127-136.

Апз1хе1еу1с11 УЛ., Уо1о§ос1зк11 АЛ., ЬиказМп АЛ., Егапк-Катепекзк!1
М.В. 81о» ге1аха11опа1 ргосеззез 1п Йе теШп§ о! Ипеаг Ыоро1у-
тегз//В1оро1утегз. 1984Ло1.23Л 1.Р.39-58.

АгдиезЬ В.О., Шеке! С.Л. А риг 1пе-руг1т1й1пе тоШ уег11у1п§ ап
ИепМса! ргезепсе 1п а!тозЬ а11 §епе Ьахопопис §гоирз//Л.Ткеог.
В1 о1.1987.Уо1.128.Р.457-461.

Аггайа В., УаЬегтап М.8. Ап Егйоз-Вепу! 1а» »1Й зЫ йз//Ас1у. Май.
1985Ло1.55. Р. 13-23.

Ва1пз V. МВЬТАН: а ргоёгат й а11§п тиШр!е ВИА зедиепсез// Иис1.
Ас!<13 Вез. 1986. Уо1.14.Р.159-177.

Весктапп Л.8., Вгепйе! V., ТгЛопоу ЕЛ. 1пйгуеп1п§ зе^иепсез
ех!ЫЬ (ИзИпс! уосаЬи1агу//Л.В!ото1.8йисЬ. Вуп. 1986. Уо1.4. Р.391-
400.

Ве11оп В. СопзйисЫоп о! гез!г1с11оп тарз//Сотр.Арр!.В!озс!. 1988.
УО1.4Л 1.Р.111-116.

Веппейеп Ь.Л., ВепйЛат!п В.Н. Сойоп зе!ес11оп 1п уеаз!//Л.В1о1.
Скет! зйу. 1982. Уо1.2574. Р. 3026-3031.

ВеппеИ ОЛ., УапоГзку С. 8едиепсе-апа1уз1з о! орегаког сопзШиМуе
ппгкапй о! Ргурйрйап орегоп о! ЕзсйегХсЫа со11// Л.Мо1.В1о1.
1978. Уо1.121.Р.179-192.

Вег§, 0.0., уоп Н1рре1, Р.Н. 5е1есй1оп о! ВЫА ЫпсНп^ з11ез Ьу
ге§и.1айогу ргойешз: 81а'ЫзЪ1са1-тесЬап1са1 йеогу апй аррИсайоп
йо орегайгз апй рготойгз//!. Мо1. В1о1. 1987. Уо1.193, Ы 4.Р.723-
750.

Вег§0.0., уоп Н1рре1 Р.Н. 5е1есйоп о! ВИА Ыпйхп^ зйез Ьу
гееи1айгу ргоЬейз. II. ТЬе ЫпЫп§ зресШсИу о! сусИс АМР
гесерйг ргойхп й гесо^пШоп з!йз//Л. Мо1. В1о1. 1988.Уо1.200.
Р. 709-723.

В1ЬЬ М., Е1пй1ау Р.В., ТоЬпзоп Н. ТЬе ге1аЬ1опз1пр Ьейееп Ьазе
сотрозШоп апй сойоп иза^е 1п Ьасйг1а1 §епез апй 1й изе Гог йе
з!тр1е апй геИаЫе 1<1епййсайоп о! ргойй соЫп^ зедиепсез//
Сепе.1984.Уо1.30.Р.157-166.

В1111п§з1еу Р. ЗййзЫса! тейойз 1п Магкоу С1ха1пз//Аппа1з Май.
8ЬайзЬ. 1961. Уо1.82.Р. 12-40.

ВИоГзку Н.8., Вигкз С., Е1скей Л.VI., еЬ а1. ТЬе ОепВапк §епейс
зедиепсе йаГа ЬапкЛЛис!. Ас!йз Кез.1986.7о1.14, Ы 1.Р. 1-4.

В1гй А.Р. ВМА теГЬу1аЫоп апй Гйе Ггедиепсу оГ Срб !п ап!та1 ВИА
//Мис1. Ас!<15 Кез.1980,7о1.8.Р.1499-1504.

В1а1зйе11 В.Е. А ргеуа!епГ регзГзкепЬ §1оЬа1 попгапйот!пезз ГЬаГ
йГзЫпеихзкез сой!п§ апй поп-сой!пе пис1еаг ВМА зедиепсез//Й.Мо1.
Еуо1.1983а.7о1.19.Р.122-133.

В1а!зйе11 В.Е. Сйохсе о! Ьазе аГ зНепк сойопзИе 3 !з зе1есЫуе1у
пеиГга! !п еисагуоЫс зГгисГига! §епез: И та!пГа1пз ехсезз зкогГ
гипз оГ «еак апй зЬгопе куйго^еп Ьопй1п§ Ьазез//Й.Мо1.Еуо1. 1983Ь.
Уо1.19.Р.226-236.

В1а1зйе11 В.Е. А теазиге оГ ГЬе зшПагИу оГ зеГз оГ зедиепсез поГ
геди1г!п2 зедиепсе а112шпепГ//Ргос. На11. Асай.5с1.08А.1983с. 7о1.
83. Р.5155-5159.

В1а1зйе11 В.Е. Магкоу ска!п апа1уз!з Ппйз а зГепШсапГ !пПепсе оГ
пеГ^ЬЬогГпе Ьазез оп 1йе оссигепсе о! а Ьазе 1п еисаг!оГ!с пис1еаг
ВЫ А зедиепсез ргоГе1п-сой!п§ апй попсой!п§//Мо1.Еуо1.1985. 7о1.21.
Р.278-288.

В1аке В.Б. ,Еаг1еу 8. В!зЬг!ЬиГюп апй еуо1иЫоп о! зедиепсе сйагас-
Гег1зГ!сз 1п ЬЬе Е.соИ 2епоте/7й.В1ото1.8Ггис1.Вуп. 1986. 7о1.4,
Ы 2.Р.291-307.

ВооЬй К.8. .Ьеикег 6.8. ТезЬ!п§ Гог Ь’пе сопзесиЫуе опез ргорегЧу,
1пЬегуа1 Егарйз апй ^гарк р!апаг1Ьу из1п§ РЧ-Ьгее а1йог!Ы1тз//й.
СотриЬ. 8уз Ь.5с!.1976.Уо1.13,Ы 3. Р. 335-379.

Вогег Р.Ы., Беп§1ег В., Т!посо 1.,Йг., ВЫепЬеск О.С. ЗЬаЫИЬу о{
г1Ьопис1е!с ас!й йоиЫе-зЬгапйей ЬеИсез// Й.Мо1.В!о1. 1974. Уо1.
86Л 4.Р.843-853.

Вогойоузку М.Уи., Сизе!п-2айе 8.М. А^епега! ги1е Гог гап^ей зег!ез
о! сойоп 1гедиепс1ез 1п йШегепЬ 2епотез//Л. В!ото1. БЬгисЬ. Вуп.
1989. Уо1.6.Р.1001-1012.

ВгапйА.Н., Вгеейеп Ь., АЬгайат й., 8Ьегпй1ап2 К., ЫазтуЬ11 К.
СЬагасЬег 1гаПоп о! а зПепсег 1п уеазЬ - а ВЫА зедиепсе »!Ы1
ргорегЫез оррозИе Ьо Ыюзе о! а Ьгапзсг!рЬ!опа1 епкапсег/7Се11.
1985. Уо1. 41.Р.41-48.

Вгееп 8., ИаЬегтап М.8., Екап^ Ы. Кепеуа! Ьйеогу Гог зеуега!
раНегпз//й. Арр 1. РгоЬ. 1985. Уо1.22. Р. 228-234.

Вгепйе! V., Весктапп Й.8., ТгИопоу ЕЛ. ЫщрпзЫсз о! пис1еоЫйе
зедиепсез: тогрЬо1оеу апй сотрагГзоп оГ уосаЬи!аг1ез//Й.В1ото1.
81;гисЬ.Вуп. 1986.УО1.4.Р. 11-21,

Вгепйе! V., Натт С.Н., ТгИопоу ЕЛ. ТегпппаЬогз оГ 1гапзсг!риоп
»Ш1 КИА ро1утегазе Ггот Езскег!с!1!а со11: ийаЬ Гкеу 1оок 1 !ке апй
кот» Го Лпй Ы1ет//Й.В!ото1ес.5ЬгисЬ.Буп. 1986.7о1.3Л 4. Р.705-723.

Вгепйе1 V., ТгИопоу ЕЛ. А сотриЬег а1§ог1ГЬт Гог ГезГ!п§ роГепЫа!
ргосаг!оЫс Гегт1паГогз//Мис1.Ас1йз Кез. 1984, 7о1.12, И 10. Р.
4411-4427.
Висйег Р., Тг1Гопоу ЕЛ. Оп Яизз1поу'з сотрНаИоп оГ еисаПоИс
Йапзсг1р1;1оп 1пШаНоп з!йз: ЬеЙег Й Йе ейНог/ЛЕТЬеог.
В1О1. 1987. 7о1. 126, Ы З.Р.373-375.

Вис1ю1й С.А., Ве1зпег АЛ. МВ13 - ап йй^гайй зузйт Гог Йе
гей!еуа1 апй апа1узез о! зедиепсе йай Ггот пис1е!с ас!йз апй
ргой1пз//Иис1. Ас1йз Кез.1986.7о1.14,Ы 1.Р.265-272.

СатрЬеП А. СотргеЬеп81уе УЙоП^у.Уо1.8Л.У. :Р1епит Ргезз, 1977.
Р.259-280.

СатрЬеП А. ,Войй1п В. ЬатЬВа II //СоИ 5рг1п§ НагЬог ЬаЬог.,
1983. Р. 365-380.

Саппоп С.С. Зедиепсе апа1уз!з оп т1сгосотрийгз//8с1епсе. 1987.
7о1.238Л 4823.Р.97-103.

Сапйг С.К., ЗсЫтте! Р.К. В1орЬуз1са1 СЬеппзйу РЬ I: ТЬе СопГогта-
Ыоп оГ В1о1о§1са1 Масгото1еси1ез, СЬ. 6 /И.Н.Егеетап. Зап
Егапз!зсо, СА.1980.

СИатЬегПп М., Ва1с№1п К. Ь., Вег§ ?• Ап епгут1са11у зупйезей ВВА
о! а1йгпаЫп§ Ьазе зедиепсе: рйуз!са1 апй сйетйа! сйагасйгйа-
Ыоп//Л.Мо1.В1о1.1963.7о1.7Л 4, Р.334-349.

Сйуай! V., ЗапкоГГ Б. Боп^езЬ соттоп зиЬзедиепсез о! Йо гапйот
зедиепсез//Л.Арр1. РгоЬаЫ 1.1975. Уо1.12. Р. 306-315.

С1ауег!е Л.М., Воиеие1егеЬ В. Неиг1зЫс 1пГогтаПопа1 апа1уз!з оГ
Зедиепсез//Вис1е1с Ас1й Везеагсй.1986.7о1.14, Р.179-196.

СоШпз «1.Е., Сои1зоп А.ЕЛ. АррИсаИопз о? рагаНе! ргосезз1п§
а1§ог1М1тз Гог ВЫА зедиепсе апа1уз1з/Лис1.Ас1йз Вез. 1984.Уо1.12,
Ы 1.Р.181-192.

Сотау Е., ИиззЛоу В., Сотау 0. Ап ассе1ега!ей а^огуИип Гог
са1си1а11пе ЪЬе зесопйагу зЪгисЪиге оГ з1п§1е з^гапйей ВВАз
//Иис1. Ас1йз Вез. 1984. Уо1.12,11 1.Р. 53-66.

Сои1зоп А., 5и1з1;оп <1., Вгеппег 3., Кагп Л. То«аг<1 а ркузхса! тар о!
М1е шепоте о! ЪЬе петаЪойе СаепогЬаЬйШз е1е§ап//РгосЛа11. Асай.
Зс1. ВЗА. 1986.УО1.83.Р.7821-7825.

Паппа К., Заек 6.Н., ВаЪЬапз П. ЗЪисИез о? 31т1ап 71гиз 40 БЫА VII.
А с1еауа§е тар оГ Йе 5740 Сепоте//Л.Мо1.В1о1. 1973.7о1.78. Р.363-
376.

ВаукоИ М.0. АМаз оГ ргойхп зедиепсе апВ зйиейге, ЫаИопа!
В1отей1са1 Везеагск ЕоипйаМоп, Маз1пп§1оп, В. С. ,1972.

ВаукоГГ М.0. А11аз оГ ргоШп зедиепсе апй зйисйге/ЛазЫпейп:
Сеог^ейта Впхуегзйу, 1978.

БауйоИ Л.Е. В1зМп2У1з!1ей иогйз 1п йайа зедиепсез: АпаИзез апй
АррИсаИопз пеуга! сой1п§ апй ойег ?1е1йз//Ви11. Май. В1о1.
1984.701.46.Р.529-543.

Векеп Л.С. Мах1та1 соттоп зиЬзедиепсез//В1зсгей Май. 1979. 7о1. 26.
Р. 17-31.

Веуегеих Л., НаеЬегИ Р., Зт1й1ез 0. А сотргейепз1уе зе!; о!
зечиепсе апа1уз!з Тог Не УАХ/7Лис1. АсИз Кез. 1982. Уо1. 10, Ы 1.
Р.387-396.

ВеУое Н., Т1посо 1.,Лг. ТЬе зЬаЫИГу оГ Ье11са1 роГуписГеоГИез:'
Ьазе сопГг1ЬиЫоп//Л.Мо1.В1о1.1962Ло1.4, Ио 6.Р.500-517.

йе’ЛаспНг К. ТЬе ЫишЬег о! КереаН ЕхресЬей 1п Капйот Ыис1е1с АсИ
Бечиепсез апй Роипй 1п Сепез//Л.Т11еог.В1о1.1981Ло1.91.Р.71-98.

ВЫИопТ.Б., РоопА.ОЛ., У1п ТУай Нах, ВЫПоп Е.К.Б. СоИрЬаее
НК139 ГпГеегаНз ЬеНееп Мз апй зирй//ЛЛ1го1.1982. Уо1.44. Р.716-
719.

ОГгесНгу оГ ргоГехп апй пис1е!с ас И зечиепсе ЬаЬа зоигсез //СойаЬа 1
Ви11.1987.Ы 65.Р.1-59.

01х Т. I. ,К1егопзка Т.Н. Еггогз ЬеИееп зГГез 1п гезНхсЫоп зИе
тарр!пе//Сотр. Арр1.В1озс1.1988Ло1.4,Ы 1.Р.117-124.

ВоЬзоп М. Л., ТиИе М.Р., КоЬегЧз Ы.А., еГ а1. СопзегуаЫоп оГ
еГГ1с1епсу рготоГег зечиепсез 1п БассЬаготусез сегеу1з1ае/7Ыис1.
Ас 1Ьз Кез.1982.Уо1.10.Р.2625-2637.

ВоеееМ Р.Е., В1аИпег Р.К. Регзопа! ассезз Н зечиепсе ЬаГаЬазез оп
регзопа! сотри1егз//Нис1. АсИз Кез.1986.Уо1.14, Ы 1,611-619.

Во! К.Н.,	Ъ.Р. МиШр1е ргосагуоЫс г1Ьопис1е!с ро1утегазе

зхета ГасНгз//М1сгоЫо1. Кеу. 1986Ло1.50, Р.227-243.

Вгтапас К., ЬаЬаЬ I., Вгикпег I., Сгкуеп^акоу К. Зечиепсхпе оГ те§а-
Ьазе р1из ВНА Ьу ЬуЬгИГгаЫоп: Неогу о! ГЬе теЬЬой//Сепот1сз.
1989ЛО1.4.Р. 114-128.

Вие§1еЬу К., К1ппз Н., КооЬ Л. А сотриЬег ргоегат Нг ЬеГегтхпаПоп
Не з1зе о! ВЫА гезЬгНЫсп ГгаетепГз//Апа1.В1осЬет. 1981. Уо1.
110. Р. 49-55.

Вигапй К., Вгеееееге Р. Ап еШсхепЬ ргоегат Го сопзГгисЬ гезГгхсЫ-
оп тарз Ггот ехрегхтепЬа! ЬаЬа «1111 геаИзЫс еггог 1еуе1// Ыис1.
АсИз Кез. 1984Ло 1.12,Ы 1.Р.703-716.

Е1§еп М., ЗсйизЬег Р. Тке Нурегсус1е. А Рг1пс1р1е оГ ЫаЬига! БеИ-
0геап12аНоп //В1е ЫаЬиг»1ззепзскаГГеп.1978. Уо1.65,Ы 7.Р.341-369.

ЕГзтаппЕ., уЛИскеп-Вегетапп В., Ми11ег-НП1 В. ЗресШс ЬезГгис-
Ыоп оГ Не зесопй 1ас орегаЬог йесгеазез гергеззИп оГ Не орегоп
1п ЕзсЬег 1сЬ1а соИ Г1уеГоИ//Л.Мо1.В1о1.1987. Уо1.195. Р.949-952.

ЕИег Л.К., БоиМегп Е.М. МеазигетепЬ о! ВИА 1еп§Н Ьу ее1-е1есЬго-
рЬогез!з 2. СотраНзоп оГ теЬЬойз Гог геГаЫпе тоЫИЬу оГ
ГгаетепГ 1епеЫ1//Апа1.В1осЬет. 1983. Уо1.128, И 1.Р. 227-231.

ЕИег Л.К., БоиЬЬегп Е.М. СотриЬег-аИей апа1уз!з оГ опе-Ытепз1опа!
гезГг1сЬ1оп ГгаетепЬ §е1з //Ыис1е1с асИ апй ргоГехп зечиепсе
апа1уз!з: а ргасЫса! арргоасЬ/М. Л.ВГзЬор, С. Л. Ка»11пез. ОхГогй;
ИазМпеЬоп, В.С.: 1КЬ Ргезз,1987. 417 с.

РГсЬапГ С., СаиЫег С. БЬаЫзЫса! теЬЬой Гог ргесНсЫпе ргоГеГп
соЫпе гесНопз 1п пис1е!с асИ зечиепсез//СотриЬ. Арр1. В1озс1.
1987Л01.3.Р. 287-295.
РГскеЬЬ ЗЛ. Кесо^пШоп оГ ргоНГп сос11пё ге^Ипз 1п РМА зедиепсез
/Лис 1. Ас Из Кез. 1982. Уо 1.10. Р. 5303-5318.

Р1егз IV., СопИегаз К., йеТУасй'Ьег К., ей а1. КесепЬ ргоегезз 1п Не
зедиепсе йеНгтИаЫоп оГ Ьас Нг ПрИа^е М52 ЮГА//В1ос111т1е. 1971.
Уо1.3.Р. 495-506.

ПНИ IV., ЗтГН Т., Ка1рЬ IV. Марр1п§ Не огйег оГ РМА гезИИНоп
Гга^тепГ/Лепе. 1983. Уо1.22, Ы 1.Р. 19-29.

РИсЬ IV.М. Са1си1а11П2 Не ехресНй ГгедиепсГез оГ роГепНа! зесоп-
йагу зИисНге 1п пис1е!с ас Из аз а ГипсИоп оГ з'Ьет 1еп§Н, 1оор
з!ге, Ьазе сотрозШоп апй пеагезЬ пеИЬЬог ГгедиепсГез// Ыис1.
АсИз Кез. 1983Ло1. И. Р. 4655-4663.

РопйгаГ С., Реззеп Р., Ье Веих Р. Рг1пс1р1е о Г сойГПсаИоп Гог
ди!ск сотраНзопз	Не епЫге Ыото1еси1е йаЬаЬапкз апй

аззосГаГей ргойгатз 1п РОКТКАК 77/Лис1. Ас Из Кез.1986.Уо1.14, Ы
1.Р. 197-204.

РгеГег З.М., РеГегзЬеГт М., НГскеу Р.К.& Тигпег Р.Н. Тйегтойупатс
зГийГез о Г КМА зГаЫ1Иу//З.В1ото1.3ЬгисГ. Руп. 1984. ЛГо1.1, Ы 5.
Р.1229-1242.

РгеГег З.М., КГеггек К., Зае^ег З.А., еЬ а1. Ттргоуей Ггее-епег§у
рагатеЬегз Гог ргейИЫопз оГ КМА йир!ех зНЫ1Иу//РгосЛаЫ.
Асай.ЗсПОЗА 1986Ло1.83,Ы 24.Р.9373-9377.

Ргезсо З.К., А1ЬегГз В.М., РоГу Р. Зоте то1еси1аг йеНПз оГ ЬЬе
зесопйагу зГгисГиге оГ г1Ьопис1е1с асИ/ЛаГиге. 1960. Уо1.188,М
4745.Р.98-101.

РгГеЫапЬ Р., КеЬез Ь., ВгиЫа^ Р., еГ а1. СЕИЕ313, а кпо»1ей§е-
ЬазеЬ еепеЫс епй1пеег!пй з!ти1аЫоп зузГет Гог гергезепЬаПоп оГ
оепеЫс ЬаГа апй ехрегГтепЬ р1апп1пй/Лис1. АсИз Кез. 1982Ло1.10,
Ы 1.Р.323-340.

уоп СаЫп А., Ве1азсо З.С., ЗскоНе! З.Ь., еЬ а1. Ресау оГ тЮ1А 1п
Езскег 1сМа соИ: 1пуезЫ§аЫоп оГ Не ГаГе оГ зресГПс зедпепЬз
о Г Ггапзсг 1рХз//Ргос.ЫаГ1. Асай. 5с1 .РВА. 1983Ло 1.80, Ы З.Р. 653-657.

Сапога М.С., КоГоЫ Е.С., МагИеге Р., Ьоиз В.С. РоГепЫа! зесопйагу
зГгисГиге аЬ ЬгапзГаЫоп-ГпШаЫоп з!Гез//Ыис1. АсИз Кез.1987.
Уо1.15. Р. 345-360.

СагЬег К.Ь, Са^е Ь.Р. //Се11.1979Ло1.18.Р.817-828.

СагЬеп РЛ. Магкоу Апа1уз1з оГ У1га1 РЫА/ККА зедиепсез//З.ТЬеог.

В1О1. 1980Ло1.82. Р. 679-684.

СагЬпег М.Оп Не рагайохИ! зИиаЫоп На! аг!зе Ггот попЬгапзШуе
ге1аЫопз//Зс1. Ат. 1974Ло1.231.Р. 120-128.

СаШпЬ. ТЬе ГпГогтаЫопа! Неогу апй Не 11у1пй зузГетз. Ы.У.:
Со1итЫа ОпГуегзПу Ргезз, 1975.Р.'35-40.

Сау Ы.О., ^а1кег З.Е. ТЬе АТР орегоп: пис1еоГИе зедиепсе оГ
рготоНг апй Не §епез Гог Не тетЬгапе ргоНГпз, апй Не йе11а
зиЬипИ оГ Е.соИ аЬр-зупНеЬазе/Лис!. АсИз Кез. 1981. Уо1. 9.
Сеог^е С.С., Вагкег Ш.С., Кип! Е.Т. ТЬе рго!е1п 1йеп!1 ПсаЫоп
гезоигсе (Р1К)// Ыис1. АсИз Кез., 1986.Уо1.14,Ы 1.Р.11-16.

Сеог^е Д., СЫгХкзхап 1.0. 5едиепсе-зрес1Пс епйопис!еазе ВатН1:
ге!ахаЫоп о! зедиепсе гесо§пШоп//Ргос.КаЫ.Асай.5с1.и5А. 1982.
Уо1.79.Р.2432-2436.

СИЬЬз А.Й., Мс1п!уге С.А. ТЬе Лаурат, а теЫюй Гог сотраг!п§
зедиепсез// Еиг.Л.ВИсЪет. 1970.Уо1.16.Р. 1-11.

СНЬег! V., Ма^огэ 1., Махат А.М. Ог^атзаИоп апй ехргезз!оп о Г
сЬготозотез. ВегИп: ВаЫет КопГегепгеп, 1976.Р. 167-172.

Соай У/.В., КапеМза М. I. РаЫегп гесоепШоп 1п пис1е!с ас!йз
зедиепсез. 1. А §епега! теНой Гог Г1пй1п§ 1оса1 котоГо^уез апй
зутте!г1ез//Мис1.Ас1йз Кез.Уо1.1982,Ы 10.Р.247-263.

Со1й В., РгГЬпо» 0., БсйпеИег Т., е! а1. //Апп. Неу. МГсгоЫо!.
1981. Ус! 35.Р.363-403.

Со1йз!е1п Ь., ИаНгтап М. 5. Маррте ВИА Ьу зЬосйазЫс ге1аха!1оп//
Айу.АррИей МаЬЬ.1987.Уо1.8,Ы 2.Р.194-207.

Со1оуапоу Ей.I., БргГгЫЬзку Уи.А., АГехапйгоу А.А. СотриЬег
апа!уз!з оГ ГипсЫопа! з11ез оп пис1ео!1йе зедиепсез//51гис1иге
апй ГипсЫопз оГ рго!е1пз апй пис!е1с ас!йз: 6-М ОББК-Ргапсе
з1троз1ит: АЬзУгасЪз. ТзкйаИиЬо, 1982.Р.52.

СоЬоЬ 0., Та^азЫга У. Зедиепсе зеагсЬ оп а зирегсотриЬег// Кис1.
Ас1йз Кез.1986.Уо1.14.Р.57-64.

Сси^к Е.1.,Соие11 И.Н. В1гес! са1си1а!1оп о! -Ыпе з1зез о! ВЫА
Гга^теп^з зерагаЪей Ьу §е! е1есЛгорйогез1з//Кис1е1с Ас1йз Кез.
1984. УО1.12Л 1.Р.845-853.

Сои1йеп 1.Р.,1аскзоп В.М.Ап 1пуепз1оп ЬЬеогет Гог с1изЪег йесот-
розШоп о! зедиепсез й1зЫпйи1зйей зиЬзедиепсез// 1. Ьопйоп
Май. Бос. 1979. Уо1.20. Р. 567-576.

Соиу М., СаипЫег 6. Сойоп Оза^е 1п ЪасГегГа: согге!аиоп чигп §епе
ехргезз171Ьу//Кис1.АсГй.Кез.1982. Уо1.10. Р.7055-7074.

Соиу М., У111еге1; Р., Ми§п1ег С., йасоЬгопе М., СаиЫег С. АС1ГОС: а
пис1е!с ас!й‘зедиепсе йаЬа Ьазе апй апа1уз!з зузЬет// Яис1. Ас1йз
Кез.1984.Уо1.1,И 1.Р.121-127.

0га11а 1., СгоЬЬегз В.М. Ргее епег^у оГ 1трегГес! пис!е1с ас!й
ЬеПеез. II. Бта11 Ьа1гр1п 1оорз//1.Мо1.В!о1. 1973. Уо1.73Л 4.
Р. 497-511.

СсапЬпат К. Апппо ас!йз йШегепсе ГоггтНа Ьо Ье1р ехр!а!п рго!е1п
е7о1и!1оп//Бс1епсе.1974.Уо1.185.Р. 862-864.

СгапЫ1ат К., ОаиЫег С., Сопу М. Сойоп Ггедиепсез 1п 119 1пй1У1йиа1
§епез сопПгт сопзГзЬеп! скоГсез о! йееепегаЬе Ьазез ассогй!п2 Ьо
шепоте !уре//Кпс1. Ас1йз Кез.1980а, Уо1.8.Р. 1893-1912.

СгапЫ1ат К., СаиЫег С., Соиу М., е! а1. Сойоп са!а1о§ иза°е апй
§епоте 1гуроЫ1ез1з//Кис1.Ас1йз Кез. 1980Ь. Уо1.8.Р.г49-г62.
Сгау к.З., Веесйег В.Е., 01зоп МЛ. СотриГег-Ьазей 1та§е апа1уз!з о?
опе-й!тепз1опа1 е1ес1горГ1огеГ1с §е15 изей Гог 1Ъе зерагаНоп оГ
СМ А гезГгчсНоп Гга§тепГ.з//Мис1.Ас1йз Кез. 1984Ло1.12,Ы 1. Р. 473-
491.

СгГЬзкоу М., Веуегеих 3., Виг§езз К.К. Тке сойоп ргеГегепсе р1оС:
§гаГ1с апа1уз!з оГ ргоСе!п сой!п§ зедиепсез апй ргейГсНоп о? §епе
ехргезз1оп//Ыис1.Ас1й Кез. 1984. Уо1.12. Р.539-550.

СгоЬ В., БСиЪег К. Кесо§пИ;Гоп оГ 111-йеПпей зГ^паГз 1п пис1е!с
ас!й зедиепсез//Сотри1. Арр1. В1озс1.1988Ло1.4. Ы 1.Р.79-88.

Сгоззеап Н., Р1егз V. РгеГегепНа! сойоп иза§е 1п ргосагуоИс §епез:
1Ье орНта1 сойоп-апМсойоп 1пГегасНоп епег^у апй 1ке зе!есПуе
сойоп иза^е 1п еГГГсГепИу ехргеззей §епез//Сепе. 1982. Уо1. 18. Р.
199-209.

Сгоззтап А.В., ЕуГскзоп йЛ., Сгозз С.А. Тйе МрВ §епе ргойисС о!
Е.соИ 1з а з1§та ГасГог Гог йеаС-зйоск рготоСегз//Се11.1984. Уо1.
38.Р.383-390.

Сгизк1п К.В., 5тШ1 Т.Р. Мо1еси1аг ^епеНсз апй сотриСег апа1уз!з//
Сотри!. Арр1. В1озс1.1987.Уо1.3.Р.167-170.

Си1Ъаз Ь.Й., ОйГугко А.М. 5Сг1пй оуег1арз, раНегп таГсЫп» апй
попСгапзШуе еатез//й.СотЫпа1огГа1 Тйеогу (зег.А). 1981. Р. 183-
208.

Найп 5., Випп Т., БсЫеГГ К. ВрзСгеаго гергеззТоп апй СКР зНтиГаИ-
оп оГ Гйе ЕзсйегГсЫа соИ В-агаЫпозе орегоп // Й.Мо1.В1о1. 1984.
УО1.180.Р.61-72.

Натт С.Н., Сатегоп СЛ. ТЪе ЕМВЬ йаГа ИЪгагу//Ыис1. Ас1йз Вез. 1986.
УО1.14Л 1.Р.5-10.

Наг1еу С.В., Неупо1йз К.Р. Апа1уз1з оГ Е. соИ рготоГег зедиепсез/7
ЫисНАсГйз Кез. 1987.Уо1.15.Р.2343-2361.

Нагг В., РаИтапР., На^йзйгот М., ШаМзЬгот Ь., СизйаГззоп Р.
СЕИЕОЗ, а сотрийег зузйет Гог ВЫА апй ргойеГп зедиепсе апа!уз!з
сопГа1п1п§ ап ГпГогтаЫоп геГгГеуа! зузйет Гог ГЪе ЕМВЬ йаГа
11Ьгагу//Ыис1. Ас1йз Кез. 1986Ло1.14Л 1.Р.273-284.

Нагг К., НаййзГгот М., СизГаГззоп Р. Беагсй а^огИйт Гог раГГегп
тайсй апа1уз!з о Г пис1е!с ас!йз зедиепсез/711ис1. Ас1йз Вез. 1983.
УО1.11.Р.2943-2957.

Назе^ауа М., Уазипа^а Т., М1уаГа Т. Бесопйагу зГгисйиге оГ М52 рйа§е
РЛА апй Ыаз 1п сойе тогй изаее//Нис1.Ас1йз Вез. 1979. Уо1.7Л 7.
Р. 2073-2079.

Не1т-Вусйо»зк1 К.М., <11зоп А.С. КаГез оГ пис1еаг ВИА еуоГиНоп 1п
рйеазапГ-11ке Ыгйз: ЕуГйепсе Ггот геэГгИНоп тарз//Ргос.йаГ1.
Асай.5с1.В5А.1986.Уо1.83,Ы 3.Р.688-692.

Н1пйз 1.Р., В1аке В.В. ВеИпеаНоп оГ сой!п§ агеаз 1п ВЫА зедиепсез
Гйгои^й азГ^птепГ оГ сойоп ргоЬаЫИГГез// й. ВГото!. ЗГгисГ. Вуп.
1985. УО1.3.Р. 543-551.
НопТ^тап А., Майа1па 3., А1Гиу!а Б., ей а1. Р1азт!й уесГогз ЬезТ^пей
Гог Гйе апа1уз!з оГ ГгапзсгТрНоп ГегпппаНоп з1йпа1з//6епе. 1985.
7о1.36,Ы 2.Р.131-141.

НорПеГй 3.3. Ыеига! пеГтогкз апй рйузГса! зузГетз »11Ь етег^епГ
соИесГПе сотриГаНопа! аЫИГ1ез//Ргос.ЫаГ1.Асай.2с1.и5А. 1982.
Уо1.79.Р.2554-2558.

Ноу1е Р. Узе оГ соттегс1а1 зоГГдааге оп 1ВМ регзопа! сотриГегз//
Ыис1е1с ас!й апй ргоГеТп зечиепсе апа1уз!з: а ргасНса! арргоасЬ/
М. <1.В1зйор, С.Й. Ка^Ип^з. ОхГогй; ^азИп^Гоп, С.С.: 1КЕ Ргезз,
1987.417 с.

НипГ Т.Р., Ма§азап!к В. Тгапзсг ГрНоп оГ §1пА Ьу ригИТей
Езсйег 1 с!па соИ сотропепГз: соге КЫА ро1утегазе апй ГЬе ргойисГз
оГ §1пР, §1пС апй й1пЕ//Ргос.ЫаГ1.Асай.5с!.05А.1985.7о1.82.Р.8453-
8457.

Ийа У. ВЫ А зечиепсез апй тиШуагГаГе зГаНзНса! апа!уз!з.
СаГе§ог1са1 й!зсг1гп1паГ1оп арргоасЬ Го 5' зрИсе з!Ге з1§па1з оГ
тКЫА ргесигзогз 1п Ы^йег еикагуоГез' еепез//СотриГ.Арр1. В1озс1.
1987. 7о1.3.Р. 93-98.

Ткетига Т. Согге1аГ1оп ЬеГтееп Гке аЬипйапсе оГ Е.соИ ГгапзГег КЫАз
апй ГЬе оссигепсе оГ Гке гезресНу сойопз !п Из ргоГеТп §епез: А
ргороза! Гог а зупопутоиз сойоп сЬо!зе ГЬаГ 1з орНта! Гог Г Ее
Е.соИ Ггапз1аНопа1 зузГет//Й.Мо1. В1о1.1981.701.151.Р.389-409.

Ткетига Т. Согге1аНоп ЬеГтееп ГЬе аЬипйапсе оГ уеазЬ ГгапзГег КИАз
апй Ы1е оссигапсе оГ ГЬе гезресГПе сойопз !п ргоГеГп §епез//
Й.Мо1.В!о1.1982.701.158. Р. 573-597.

Тгап! М.Н., Огозг Ъ., Айкуа Б. СопГго! е1етепГ »!Й1п а зЬгисЬига!
§епе - ГНе §а! орегоп оГ Езскег1сп1а соИ// Се11. 1983. 7о1.32.
Р.783-788.

ТзегепГапЬ В., Е1егз V. Бесопйагу зЬгисЬиге оГ тЮТА апй еГГ1с!епсу
оГ Ггапз1аЫоп 1пИ1аЫоп//0епе. 1980.7о1.9, И 1.Р.1-12.

Тзопо К. А сотриГег рго^гат раскате Гог зГогТпй апй геЬг1е71п§
ВЫА/КИА апй ргоЬеТп зечиепсе йаГа//Иис1.Ас1йз Нез.1984.7о1.12,Ы 1.
Р.101-112.

йасоЬзоп А.В., Соой Ь., БтопеШ <1., 2икег М. Боте з!тр1е сотриГа-
Ыопа! теГйойз Го шргоуе Гйе Го1й1п§ оГ 1аг§е ВЫАз// Ыис1.Ас1йз
Кез. 1984.701.12Д 1.Р.45-52.

йоЬпзоп М.5., ВооИГНе К.Р. А теГЬой Гог Гйе зТтиНапеоиз аИ^птепГ
оГ ГЪгее ог тоге ат!по ас!й зечиепсез// Й.МоНЕуо!. 1986. 7о1. 23.
Р.267-278.

йогйап В.К. СотриГег ^епегаНоп оГ ра!г1пе зсЬетез Гог ЮТА то1еси-
1ез// Й.ТЬеог.В1о1.1972.701.34,Ы 2.Р.363-378.

КапеЫза М. Озе оГ зГаНзНса! сгТГегГа Гог зсгееп1п§ роГепНа!
ИотоТойГез 1п пис1е!с ас!йз зечиепсез// 1Тис1е!с Ас1йз Кез. 1984.
701.12Л 1.Р. 203-214.
КапеМза М., К1е1п Р., СгеГГ Р., ВеЬГз! С. Сотрите? апа1уз!з апй
зкгискиге ргеДГскГоп оГ пис!е1с асГДз апй ргокеГп//Ыис1. Астйз
Нез. 1982Ло1.ЮЛ 1.Р.417-428.

КагИп 3., СНапйоиг С., Оз!; Е., Тауаге 8., Когп Ъ.Л. Ые» арргоаскез
Гог сотрикег апа1уз!з оГ пис!е!с ас!й зедиепсез// РгосЛак1. Асас1.
8с1.В8А.1983.Уо1.80.Р.5660-5664.

Кагр К.М. А сйагаскегГзакГоп о? кИе тШтит сус1е теап 1п а
ЛегарЬ/ЛГвсгеке Макк. 1978.Уо1.23Л З.Р.ЗО9-ЗИ.

Ке11у Т.Л.,5тГкЬ Н.О. А гезкгГскГоп епзуте Ггот НеторЫИз
1пГ1иепгае. И.Вазе зедиепсе оГ гесо^пШоп з!ке//Л.Мо1.В1о1.1970.
УО1.51Л 2. Р. 392-400.

Кезз1егС., Но1кке Н.-Л. ЗресГПсГку оГ гезкг1ск1оп епйопис1еазез
апй теккуНзез - а геу1е» (ЕДГкГоп 2)// Сепе, 1986.Уо1.47.Р. 1-153.

Кйоигу С., Сгизз Р. Епкапсег е1етепкз//Се11.1983Ло1.33, Р.313-314.

КГезег Т. ВМАСЕЬ: а сотрите? рго^гат Гог ДекегтГпГпе ВИА Гга^тепк
з!гез из1пе а зта11 сотрикег едшррей »1кЪ а ^гарЫсз каЫек//
Ыис1. АсИз Кез. 1984Ло1.12 Л 1.Р.679-689.

КоЪага У., АкГуата К., 1зопо К. ТЬе ркузГса! тар оГ кке »ко1е Езске-
гИк!а со11 скготозоте: аррИсак!оп оГ а пе» зкгакакет Гог пар И
апа1уз!з апй зогкГпе о? 1аг§е шепоте 11Ьгагу//Се11. 1987. Уо1. 50.
Р. 495-508.

Ко1азкаг А.З., Кеййу ВЛ.В. А теккой ко Исаке ргокеГп сосНп^
зедиепсез Гп ВМА оГ ргосагчокГс зузкетз//Кис1.АсИз Вез. 1985.
Уо1.13.Р.185-194.

Ко1кег К., УапоГзку С. АккепиакГоп 1п алппо ас!й ЫозупккекГс
орегопз// Апп. Неу. Сепек. 1982Ло1.16.Р. 113-134.

Копорка А. 1з кке 1пГогтак1оп сопкепк оГ ВЫА еуо1ик1опагу з!§п1Г1-
сапк// Л.Ткеог.В1о1.1984Ло1.107.Р.697-704.

Когп Ъ. Л., Чиееп С.Ъ. Апа1уз1з оГ Ыо1о21са1 зедиепсез оп зта11 сот,-
рикегз//ВКА.1984.Уо1.З.Р.421-436.

КогпЕ.Л., ЧиеепС.Е., ^е^таи МЛ. Сотрикег апа1уз!з оГ пис1е!с
асИз ге§и1акогу зедиепсез//РгосЛак. Асай. 3с1. ВЗА. 1977Ло1. 74.
Р. 4401-4405.

Кгатег Е.К., МШз В.К. Зесопйагу зкгискиге ГогтакГоп йигГп^ НЫА
зупкйез1з//Кис1.Ас1йз Нез. 1981Ло1.9Л 19.Р. 5109-5124.

Кги^ег К., 6гаЬо»зк1 Р.Л., 2аи§ А.Л., ек а1. Зе1Г-зр11с1п§ НИА:
АикоехсГзГоп апй аикосус!1зак1оп оГ кке гГЬозота! ВЫА 1пкегуеп1п2
зедиепсе оГ Текгакутепа//Се11.1982Ло1.31. Р.147-157.

Кгу1оу УЛ. Мо1еси1аг Ьазез оГ §епек1с ргосеззез// Ргос. оГ кке 14
1пкегп. Соп^г. Сепек. Мозсо»: М1 г, 1981 Ло1.3. В. 2. Р. 15-24.

Кикага 8., Макзио Р., Рикатига 8., ек а1. СЕЫА8: а Дака- Ьазе Гог
пис1е!с ас И зедиепсе апа1уз1з//Мис1. АсИз Кез. 1982Ло1. ЮЛ 1-
Р.89-100.

ЕапДег Е.8., Ч/акегтап М. 8. СепотГс таррГп^ Ьу Г1пйегрг1пк1пй гапДот
с1опез: а та'ЬЬета'Ыса1 апа1уз!з//Сепот!сз. 1988. Уо 1.2. Р. 231-239.

Еапйаи М., УГзйкГпВ., Иизз!поу К. Ап еГПсГепГ; з1г1пй таГс1Ип§
а!еогШ1т к йГГГегепсез Гог писНоЪИе апй алппо ас!йз
зедиепзез//Ыис1.Ас!йз Кез.1986.Уо1.14.Р.247-263.

Еа»гепсе С.В. ВаГа зГгисГигез Гог ВМА зедиепсе тап1ри1аГ1оп//Ыис1.
АсИз Кез.1986.Уо1.14,Ы 1. Р.205-216.

ЕеГзсйег 5. Арр!ГсаМопз оГ а1§еЬга1с Еоро1о§у. Сгарйз апй пеГтогкз.
ТЕе РГсагй-ЕеГзскег Гкеогу апй Реуптап !пЕейга1з.Ы.У.: Бргчпеег-
Уег1а§,1975.Р.220.

Ее»1з Л., ВоЕу Р. ВегГуаИоп оГ Гке зесопйагу зГгисГиге оГ 55 Ю«А
Ггот Из ЫпсНпе оГ сотр1етепГагу о1Г^описНоНйз// ЫаГиге. 1970.
УО1.225Л 5232.Р. 510-512.

Е!ртап В. 1., МаГге! .1. СотрагаГпуе апа1уз1з оГ пис1е!с ас И зедиеп-
сез Ъу ГкеГг §епега! сопзГга1пГз//Ыис1. АсИз Кез.1982.Уо1.10,К 8.
Р.2723-2739.

ЕГртап В.Л., Ч/ИЬиг ЧЕЛ. СопЕехГиа! сопзЕгаГпЕз оп зупопутоиз сойоп
сйо1се//Л.Мо1.В1о1.1983.УО1.163.Р.363-376.

Е!ртап В.Л., 1ШЬиг IV.Л., 8т!Й1 Т.Р., ^аГегтап М.8. Оп Г Ее зГаИз-
11са1 з!йп1Г1сапсе оГ пис1е!с ас Из з1т!1аг1Нез/7Ыис1. Ас!йз Кез.
1984ЛО1.12Л 1.Р.215-226.

Еик К., 8гуЪа1зк! V. А с1из!ег оГ 1еГЬ»агй, гйо-йерепйепЕ Г '
ЪегтГпаЬогз 1п ГЪе Л §епе оГ соИркаее 1атЬйа//0епе. 1983.Уо1.21,
И З.Р.175-191.

МаГпаС.У., Ыо1апС.Р., 8га1ау А.8. Мо1еси1аг	беГегт!паГ!оп

ргоегат//Ыис1.АсИз Кез. 1984.Уо1.12, И 1.Р.695-702.

Ма!ге1 Л.У., Еепк К.Р. Епйапсеб ^гарЫс таГгГх апа1уз!з оГ пис!е!с
асИ апй апппо асГс! зедиепсез//Ргос.МаЕ1.Аса(1.8с!.08А.1981.Уо1.78.
Р. 7665-7669.

МагГппез Н.М. Ап еГГ!с!еп1 теГйоб Гог Г1пс11п§ гереаГз !п то1еси!аг
зедиепсез//Ыис1.АсИз Кез. 1983.Уо1.11.Р. 4629-4634.

МагЧГпез Н.М. Ап КИА ГоИ!п§ ги1е//Иис1.АсИз Кез. 1984. Уо1.12,Ы 1.
Р. 323-333.

Магиуата Т., ОоЛоЪог! Т., АоГа 8., 1кетига Т. Сойоп иза^е 1аЬи1аГей
Ггот СепВапк еепеИс зедиепсез йаГа //ИисГ.АсГйз Кез.1986. Уо1.14.
Р.Г151-Г197,

МсС1иге IV.К. Месйап!зт апй сопГго! оГ Ггапзсг!рГпоп ИШаГпоп !п
ргокагуоГез//Апп.Ке7.В!ос11ет. 1985.Уо1.54. Р. 171-204.

МсЕасЫап А.В., Возз»е11 К.В. СопГИепсе 1!т1Ез Гог йотоН^у !п рго-
1е!п апй §епе зедиепсез. Тйе с-тус опсо^епе апй айепоуГгиз Е1а
рго1е1п//Л.Мо1.В!о1.1985.Уо1.185. Р.39-49.

МГгопоу А.А., А1ехапйгоу Ы.Ы. ЗГаГпзПса! теГйой Гог гарИ йото1о§у
зеагсй//Иис1. Ас!йз Кез.1988.Уо1.16.Р.5169-5174.

МГгопоу А., К!з1ег А. КЫА зесопйагу зЕгисГиге ГогтаГпоп Йиг1п§
Егапзсг 1рНоп//Л.В!ото1ес. ЗГгисГ.Вуп. 1986.Уо1.4, Ы 1.Р. 1-9.
МТзйе! С. 3. Не» зТаТТзТТса! арргоасй То йТзсг ТтТпаТе ЬеТтееп ргоТеТп
сой!п§ апй поп-сойТпе гееТопз Тп ВМА зечиепсез апй Из еуо1иТТоп//
3.Тйеог.ВТ о1.1986.Уо 1.120Л 2. Р. 2223-2236.

МойТапо С., ВаТТТзТигзТ 6., МоТиТзку А.С. Ыопгапйот раТТегпз оТ
сойоп иза^е апй оТ писТеоТТйе зиЬзТТТиТТопз Тп Ъитап а1Та- апй
ЬеТа-^ТоЬТп §епез: Ап еуоТиТТопагу зТгаТе^у гейисТп^ ТЬе гаТе о?
тиТаТТопз »ТТЬ йгазТТс еТТесТз//РгосЛаТ1.Асай.8сТЛ8А. 1981. Уо1.
78. Р. 1110-1114.

Могеаи 3., Магсаий В., МазсЬаТ Р., еТ а1. А+Т-гТск Нпкегз йеТТпе
ТипсТТопа1 йота!пз Тп еикагуоТТс ВЫА/ЛаТиге. 1982. Уо1.295. Р.260-
262.

Ми11ег V., РТТсЬ Ш.М. Еуо1иТТопагу зе1есТТоп Тог регТесТ ЬаТгрТп
зТгисТигез Тп уТга1 ВЫАз//ЫаТиге.1982.Уо1.298.Р. 582-585.

МиШ^ап М.Е., На»1еу В.К, МсС1иге IV.К. ЕзсЬегТсЫа со1Т рготоТег
зедиепсез ргейТсТ Тп уТТго РИА роТутегазе зе1есТ1У1Ту/Лис1. АсТйз
Кез. 1984. Уо1.12Л 1.Р. 789-800.

МигаТа М., КТсЬагйзоп 3.8., Зиззтап ЗЛ. 81ти1Тапеоиз сотрагТзоп оГ
ТЬгее ргоТеТп зечиепсез//Ргос. ЫаТ1. Асай. 5с1. В5А. 1985. Уо 1.82.
Р.3073-3077.

МаЬагго С., КоЫлпз К.С., Кеййу Е.Р. Сепе ргойисТ оТ у-Т§г Опс:
ЬуЬгТй ргоТеТп сопТаТпТп§ а рогТТоп оГ асТТп апй ТугозТп-зресТ ТТс
ргоТеТп кТпазе//8с!епсе.1984.Уо1.223.Р.63-66.

ЫакаТа К., КапейТза М., Ве11з1 СИ. РгейТсИоп оТ зрИсе ^ипсТ1опз 1п
тКЫА зечиепсез//Иис1.Ас1йз.Кез.1985.Уо1.13, Р.5327-5340.

Иеей1етап 8.В., Иипзсй С.В. А Сепега! теТйой аррНсаЫе То зеагсй
Тог зТтИагШез 1п Тйе атТпо асТйз зечиепсез оТ Тто ргоТеТпз// 3.
Мо1.В1о1.1970.Уо1.48.Р. 444-453.

МеитаТег Р.8. А ргоегат раскате аррНсаЫе То ТЬе йеТесИоп оТ
оуег1арз ЬеТтееп гезТгТсТоп тарз/Лис 1.Ас 1 йз Кез. 1986. Уо1.14,11 1.
Р. 351-362.

Ыо1ап С.Р., Ма1па С.У., 8га1ау А.З. Р1азт1й тарр!п§ сотриТег
ргоегат// Ыис1.АсТйз Кез. 1984.Уо1.12Л 1.Р.717-729.

Ыис1еТс ас!й апй ргоТеТп зечиепсе апа1уз!з: а ргасНса! арргоасй/
М.Й.ВТзкор, СЛ. Ка^Ип^з. ОхТогйЛазМп^Топ, В.С.: 1КЬ Ргезз, 1987.
417 с.

МиззТпоу К. 8оте ги1ез Тп ТЬе огйег1п§ оТ пис1еоТ1йез 1п ТЬе ВЫА//
Иис1.АсТйз Кез.1980а.Уо1.8.Р.4545-4562.

ЫиззТпоу К. 8Тгоп§ айепТпе С1из1ег1п2 Тп пис!еоТТйе зечиепсез// 3.
ТЬеог.ВТ о1.1980Ъ.Уо 1.85.Р.285-291.

ЫиззТпоу К. ЫеагезТ пеТйЪЬоиг писТеоТТйе раИегпз// З.ВТо1. Сйет.
1981а.Уо1.256.Р.8458-8462.

ИиззТпоу К. ЕисагТоТТс й1пис1еоТ1йе ргеТегепсе ги1ез апй 'ЫаеТг
ТшрИсаТТоп Тог йе^епегаТе сойоп иза§е //З.Мо1.В1о1.1981Ь. Уо1.
149.Р.125-131.
ЬиззГпоу К. ВоиЫеГ; Ггедиепсез Гп еУоГиЫопагу йГзЛпсГ §гоирз//
Ьис1. АсГйз Кез. 1984аЛо1.12.Р. 1749-1763.

ЬиззГпоу К. БГтопй йоиЫеГ ргеГегепсез 1п писГеокГйе зедиепсез апй
ВМА 2еотекгу//.Т.Мо1.Еуо1.1984ЬЛо1.20. Р. 111-119.

ЫиззГпоу К. СотрПаМоп о Г еикагуоМс зедиепсез агоипй Ггапзсг ГрГЛоп
ГпГЬГаЫоп зГГ;ез/7.Т.ТЬеог.В1о1.1986аЛо1.120, Р.479-487.

ЬиззГпоу К. Боте еиГйеИпез Гог ГйепН ГГсаГГоп оГ гесо^пШоп
зедиепсез: ге^иГаГогу зедиепсез ГгедиепЫу сопГаГп (Т)СТС/САС(А),
ТСА/ТСА апй (Т)СТС/САС(А)// ВГосЬГт. ВГорЬуз. АсЬа. 1986ЬЛо1. 866.
Р. 93-108.

ЬиззГпоу К., ЙасоЬзоп А.В. РазГ а1еог1'Ы1т Гог ргейГсГГпе ГЬе
зесопйагу зГгисГиге оГ зГпеГе-зЬгапйей КЬА/7Ргос. ЫаЫ. Асай.БсГ
05А.1980Ло1.77,Ы 11.Р. 6309-6313.

01зоп МЛ., ВиГсЬГк Й.Е., СгаЬат МЛ. еЬ.аГ. Капйот с1опе зГгаГейу
Гог ^епотГс гезГгГсГГоп таррГп§ Гп уеазГ//Ргос. ЬаЫ. Асай.БсГ ЛБА.
1986Ло1. 83. Р. 7826-7830.

РарапГсоГаи С., Соиу М., МГпГо Й. Ап епег^у тосГе! ЬЬаГ ргейГсГз ВЬе
соггесГ Го1й1п§ оГ ЬКЫА апй ЬЬе 55 ЮГА тоГесиГез// ЬисГ.АсГйз Кез.
1984ЛО1.12Л 1.Р.31-44.

Рагкег К.С., УГаГзоп К.М., УГпо^гай Й. МаррГп§ оГ с1озей сГгсиГаг
ВМАз Ьу с1еауа§е »ГГЬ гезГг ГсЫоп епйописГеазез апй саПЬгаЫоп Ьу
а^агозе §е! е!есГ;горЬогезГз//Ргос. ЫаЫ.Асай.БсГ ЛБА.1977.УоГ. 74,
Ь З.Р. 851-855.

Реагзоп IV. АиГотаЫс сопзГгисГГоп оГ гезГгГсЫоп зГГе тарз//Ьис1.
АсГйз Кез. 1982ЛО1.10Л 1.Р.217-227.

Реугпег Р.А. В-ГирГе ВЫА зедиепсТп^: а сотриГег апаГузГз//!. ВГото-
1ес. ЗГгисГ. Оуп. 1989Ло1.7.Р.63-73.

Реугпег Р.А., ВогосГоузку МЛи., МГгопоу А. А., I. ТЬе зГепГГГсапсе оГ
ЬеуГаГГоп Ггот теап зГаГГзГГса! сЬагасГегГзГГсз апй ргесГГсГГоп оГ
ЬЬе Ггедиепсу оГ оссигепсез оГ »огйз//Т. ВГотоГес. ЗГгисЬ.Вуп.
1989а. УО1.6.Р.1013-1026.

Реугпег Р.А., ВогосГоузкГ МЛи., МГгопоу А. А., ЫпйиГзНсз оГ
пис1еоГГйе зедиепсез: П.БЬаЫопагу тогйз Гп еепеГГс ГехГз апй
зоппа! зГгисЬиге оГ ВИА//Т. ВГотоГес. БЬгисГ. Вуп. 1989Ь. УоГ.6.
Р.1027-1038.

РЬГПГрз СЛ., АгпоГЬ Т., Лаг Ге В. ТЬе еГГесГ оГ сойоп иза§е оп ГЬе
о!ГеописГеоЬГйе сотрозИГоп оГ ГЬе Е.соИ шепоте апй ГйепНГГса-
ГГоп оГ оуег- апй ипйег-гергезепГей зедиепсез Ьу Магкоу сГаГп
апа1узГз// ЬисГ.АсГйз Кез.1987а.УоГ.15.Р.2627-2638.

РЬГГГрз СЛ., Агпо1й й., ЛагГе К. МопоЛЬгои^Ь ЬехаписГеоГийе
сотрозЛГоп оГ ГЬе ЕзсЬегГсЬГа соГГ шепоте: а Магкоу сЬаГп
апаИзГз//Мис1.АсГйз Кез. 1987ЬЛо1.15.Р.2611-2626.

РГраз Й.М., МсМаЬоп Й.Е. МеГЬой Гог ргейГсГГпе КИА зесопйагу
зГ;гис'1иге//Ргос. ЬаЫ. Асай. БсГ. ОБА. 1975. Уо1.72Л 9. Р.2017.
РИкаШз В.В., Саг1опе С.М., Ейтопйз Р., Мауег ВЛ. НоЬизЬ
ез'Ыта'Ыоп оГ зЬапйагй сигуез Гог ргоГеГп то!еси1аг те1§Ы; апй
Ипеаг йир1ех ВМА Ьазе-ра1г питЬег аГЬег §е1 е1есЬгорЬогез1з//
Апа1.В1осЬет. 1986Ло1.152. Р. 346-360.

РоИзку В., Огееп Р., СагГГп В.Е. еГ а1. ЗресШсИу оГ зиЬзНаГе
гесо^пГЫоп Ьу ЕсоК! гезГгИЫоп епйописНазе// Ргос. ЫаЫ. Асай.
5с1. ПЗА.1975.Уо1.72.Р.3310-3314.

Ро1пег С., Вог§а1 Ь., Огозг В. РМАР.РМАРЗ: ВМА рЬузГса! тар соп-
зГгисЫпе ргоегатз//Ыис1. АсИз Нез. 1984.Уо1.12,Ы 1. Р.227-236.

РогзЬке В. А сИгесЬ теазигетепГ оГ ЬЬе ипг1ррег1п§ гаГе оГ а пис1е!с
асИ йоиЫе Ье11х//В1орЬуз. СНет. 1974.Уо1.2.Р.97-101.

РНОРНЕТ, а паЫопа! сотриЫп^ гезоигсе Гог И Ге зсГепсе гезеагсЬ//
Нис1. АсИз Кез.1986Ло1.14,Ы 1.Р.21-24.

РиНтап В. Мо1еси1аг аззосГаЫопз 1п Ыо1оеу. Ы.-У.: АсайетИ Ргезз.
1968.Р.235.

РГазЬпе М. ТЬе орегоп. СоИ Брг1пе НагЬог. И.-У.: СоИ 5рг1п§ НагЬог
ВаЬогаГогу Ргезз.1978, Р.325-343.

РизНН й., КаГаГоз Р.С. А сопуепГепГ апй айарГаЫе тИгосотриГег
еп’НгоптепГ, Гог ВИА апй ргоГеГп зечиепсе тап!ри1аГ1оп апй
апа1уз1з//Иис1. АсИз Кез. 1986ЛО1.14,Ы 1,479-488.

КасктеЬг Н.К., 2еЬеГпег 0., МигГаИо Н., еГ а1. Апа1уз1з оГ созтИз
из1п§ 1ГпеагГгаЫоп Ьу рЬа^е 1атЬйа Гегт1пазе//0епе.1985. Уо1.40,
К 2. Р.259-266.

Ка^Ипез С. ТЬе зоГГдааге йГгесЬогу Гог то1еси1аг Ыо1ой1зЬз. Е1а1п
Со1ез:1986.Р.300.

НеГсЬ й.С., ВгаЬзсЬ Н., Ваит1ег А. Оп ЬЬе зЬаЫзЫса! аззезтепГ оГ
з1т11аг1Ыез 1п ВЫА зечиепсез//Ыис1е!с АсИз Кез. 1984. Уо1.12Л
13. Р. 5529-5543.

НеГсЬ <1.0., МеГзке V. А з!тр1е зГаЫзГГса! з!§п1Г1сапсе ГезГ оГ
»1пйо» зсогез 1п 1аг§е йоЬ таГгГсез оЬГаГпей Ггот ргоЬеГп ог
пис!е!с ас!й зечиепсез//СотриЬ. Арр1. В1озс1.1987.Уо1.3.Р.25-30.

НоЬегГз Ь. №Ьо отаз ЬЬе Ьитап §епоте//5с!епсе.1987а.Уо1.237, К
4813.Р.358-361.

НоЬегЬз В. Нитап шепоте: риезИоп оГ созЬ//5с1епсе. 1987Ь, Уо1.237Л
4821.Р.1411-1412.

Ноте ОЛ., ТгаИог В.Е.Н. Оп Не ГпГогтаЫопа! СопГепГ оГ У1га1
ВЫА//Л.ТЬеог.В1о1.1983Ло1.101.Р. 151-170.

Низзе1з Р.Т., СгапйаН К.Е., ЕеИЬаит К. СЕВУ515: Разса1-1тр1етеп-
Ьей апа!уз!з оГ опе-й!тепз1опа1 е1есГгорЬогез!з ее1з//Ыис1.АсИз
Кез. 1984ЛО1.12Л 1.Р. 493-498.

5а1зег IV. С1оЫп тКМА зечиепсез: Апа1уз1з оГ Ьазе ра1г1п§ апй
еуоИНопагу 1тр11саЫопз//СоИ ЗргГпе НагЬог Зутр. ОиапГ. В1о1.
1977.УО1.42.Р.985-1002.
Зап^ег Е., Сои1зоп А.К., Ноп§ С.Е., РеЪегзеп С.В. Кис 1еоЪ1 Зе
зериепсез оГ Вас1ег1орпа§е ВКА/Л1.Мо1.В1о1. 1982.Уо1.162. Р.729*

СапкоИ В. Ми1а11оп 1геез о Г зериепсез//81АМ Л.Арр!. Ма€к. 1975.
Уо1. 78.Р.35-42.

ЗсЬаГГег Н.Е., ЗейегоГГ К.К. Гтргоуей езИтаИоп о! ВИА Гга§теп1
1еп§1Ьз Ггот а§агозе §е1з//Апа!.В1осЬет.1981. 7о1.115.Р.113-122.

5сЬпе1йег Т.В., 81огто С.В.» Со1й Ъ., ЕкгепГеисН А. 1пГогта11оп
соп1еп1 о! Ыпй!п§ зИез оп пис1ео€1йе зериепсез//,!. Мо1. В1о1.
1986. Уо1.188.Р.415-431.

8с1те1йег Т.В., 81огто С.й., Наетег Л. 8., Со1й Ь. А йез!§п Гог
сотри^ег пис1е1с-ас1й-зериепсе з^ога^е, геГг!еуа1, апй тап!ри!а-
Ноп// Ыис1. Ас 1йз Кез. 1982.Уо1.10.Р.3013-3024.

Зскгоейег й.Ь., ЫаНпег Е.К. Еогта1 йезсгирНоп о! а ВИА ог1еп!ей
сотрите? 1ап^иа^е//Кис1. Ас1йз Кез.1982.7о1.10, К 1.Р.69-84.

ЗсЬгоейег й.Ь., В1аЫпег Е.К. Ьеаз1-зриагез теНюй Гог гез1г!с11оп
тарр!п§//Сепе.1978.Уо1.4,Ы 2.Р.167-174.

8е11егз	Р.8. Оп €Ье	ЪЬеогу апй	сотриЪаИоп оГ	еуо1и11опагу

й1зЪапсез//81АМ й. Арр1. Маки 1974. Уо1.26. Р. 787-793.

811ар1го	В. А.,	Кизз1поу	К., Ырк1п	Ь. Е., Ма1зе1	«1.7. , йг. Ап

1п1егас11Уе йо! таких зузЪет Гог 1осаНпи ро1еп11а11у з1§пШсап!
ГеаЫгез 1п пис!е1с ас1й то1еси!ез// ,1.В1ото1ес.81гис1. Вуп.1987.
У01.4Л 5.Р.697-706.

81т «1.Е., В1п§пат Н., Гиегз! С. К., Реагзоп М.Ь. МиШзИе скагас^ег
о! Ьоз1-гап§е ти^аНопз 1п Ьас1ег 1орЬа§е 1атЬ(1а//У1го1о§у. 1977.
Уо1. 83.Р.180-194.

ЗкерЪегй ,1.СЛ. Мекюй 1о йе!егт1пе 1Ье геас11п§ Ггате о! а рго!е!п
Ггот риг!пе руг!т1(11пе §епоте зериепсез апй Из розз!Ые
еуо1и11опагу зиз€1 Г1са11оп//РгосЛа11.Асай.Зс!. ВЗА. 1981.Уо1. 78.
Р.1596-1600.

8Ыпе В., Ва1§агпо Ь. ТЬе 3'-1егт1па1 зериепсе о? ЕзскегхсЫа соИ
168 гхЬозота! ВКА: Сотр1етеп1агу 1о попзепзе 1г1р1е1з апй
МЬозота! Ыпй1п§ зИез// Ргос. Ка11. Асай. 8с1.118А. 1974Ло1.71.Р.
1342-1346.

ЗйозЬак К. ЗерагаИоп 1Ьеогу//й.Аззос. Сотри!;. МасЬ. 1987. Уо1.28.Р.
769-779.

Зкраег Е.С. Сопз1га1п1з оп сойоп соп!ех1 1п ЕзсЬег 1сЫа соИ ^епез:
ЪИе1г розз!Ые го!е 1п тойи1а!1п§ Ше еШсхепсу о! 1гапз1а11оп//
й.Мо!.В1о1.1986. Уо1.188.Р. 555-564.

811и1тап М. «1., 81е1пЬег^ С.М., ^ез1тоге1апй И. Тке сой!п& ГипсИоп оГ
пис!еоНйе зериепсез сап Ье йезсгйЬей Ьу зЪаИзИса! апа1уз!з//й.
Т11еог.В1о1.1981.701.88. Р. 409-420.

81аЪег СЛ., Коиззеаи й., Ноо1апй.В. Оп 1Ье з€ге1Ып§ оГ ВИА 1п
гер1а11оп 1Ьеог1ез оГ §е1 е!ес1гор!1Огез1з//В1оро1утегз. 1987. 7о1.
26, Ы 6.Р.863-872.

260
ЗпнГ.Ь Н.О., В1гпзка11 Н.С. А 51тр1е теШой Гог ЕМА гезкгГсНоп
тарр1п§//Ыис1.АсГйз Кез.1976.УоТ.З.Р.2387-2398.

5тШ1 Б.Н., ВгиНаё Б., г’пейГапйР., Кейез Ь.Н. ВЮИЕТ: паТГопа!
сотриъ1п§ гезоигсе Тог тоГесиГаг Ыо1оеу//Мис1. Ас1(1з Кез.1986.
УоГ.Ю 1.Р.17-20.	и. ,

5тИЬ Т.Р., СгизкГп К., ТоГтап 5., Еаи1кпег 0. ТЬе то1еси1аг Ью1о§у
сотрикег гезеагск гезоигсе//Нис1. АсГйз Кез.1986. Уо1.14Д 1.

ЭпГГА Т.Р., ГКакегтап М. 5., Вигкз С. ТЬе зкакГзНса! йГзкгГШГоп оГ
писГеГс асГйз зГтГ1агГТГез//Кис1. АсГйз Кез.1985.7о1.13. К 2.

5т ИЬ Н.О., VII сох К Л. А гезЬг!сЫоп епгуте Ггот НеторЫ 115
хпПиепгае. I. РигШсаЫоп апй ^епега! ргорегЫез//й.Мо1. В1о1.
1970. 7о1.51,Ы 2.Р.379-391.

5оиЬЬегп Е.М. МеазигетепЬ о? Б№А 1еп§1п Ьу §е1 е1ес!;горЬогез1з//
Апа!.В1осЬет. 1979.Уок 100,кТ 9.В.319-323.

8оЬе1 Е., МагИпез Н.М. А ти1Ыр1е зедиепсе аИ^птепЬ рго^гат//
Мис1. Ас1йз Кез. 1986.7о1.14.Р.363-374.

5Ьайеп К. Ап 1пЬегас11Уе ^гарМсз рго§гат Гог сотраг!п§ апй а!1§п1п§
пис1е1с ас!й апй ат!по ас!й зедиепсез//Кис!. Ас1йз Нез.1982. 7о1.
10.Р.2951-2961.

81айеп К. МеазигетепЬз оГ ЬЬе еГГесЪз ЬЬаЬ сой!п§ Гог а рго1е!п Ьаз
оп БИА зедиепсе апй 1Ье1г изе Гог Г1пй1п^ §епез//Иис1. Ас1йз. Кез.
1984а.7о1.12.Р.551-567.

ЗЬайеп Н. СотриЬег теЬЬойз ио 1осаЬе з1§па!з 1п пис1е!с ас!й
зедиепсез//Нис1. Ас1йз Кез.1984Ь.7о1.12Л 1.Р.505- 519.

ЗЬайеп К. СотриЬег те^Ьойз Ьо 1оса1е §епез апй 51§па1з 1п пис1е!с
ас!й зедиепсез//СепеЫс Еп§1пеег1п^: рг1пс1р1ез апй теЫюйз. 1985.
7о1.7.Р.67-114.

ЗЬайеп К. ТЬе сиггегЛ зЬаЬиз апй рогЬаЫИЬу о? оиг зедиепсе
Ьапй11п§ зоГ1^аге//Кис1. Ас1йз Кез.1986.7о1.14, Мо 1.Р.217- 232.

ЗЬайеп К. Ме1Ьойз 1о йеПпе апй 1оса1е раЫегпз о! тоЫГз 1п
зедиепсез//СотриЬ. Арр1. В1озс1.1988.7о1.4, К 1.Р.53-60.

81айеп К., МсЬасЫап А.Б. Сойоп ргеГегепсе апй Из изе 1п [йепЪуГу-
1п§ ргойе1п сой!п§ ге§1опз 1п 1оп§ БКА зедиепсез//Кис1. Ас1йз Кез.
1982.701. ЮЛ 1.Р.141-156.

ЗЬаЫзЫса! апа1уз!з о Г БИА зедиепсе йа1а/В. 5Ле1г. ИгУ.: Беккег.

81ее1е й.М. Ьоп§ соттоп зиЬзедиепсез апй 1Ье ргоххтИу о! 2 гапйот
31Г1ПЕ5//81АМ й.Арр!.МаьЬ.1982.7о1.42.Р.731-737.

81еПс М. 1пГегг1п§ БКА зЬгисЬиге Ггот зеетепЬаЫоп БаЬа// АгШ.
1п1е1. 1978.7О1.11Д 1.Р.85-115.

Зйогто С.Б. 1йепШуп§ сой!п§ зедиепсез//Мис!е1с ас!й апй ргойетп
зедиепсе апа1уз!з: а ргасЫса! арргоаск/М.й.В1зЬор, С.й. Ка1лгИп§з.
ОхГогйЛазЫп^Ьоп, В.С.: 1НЬ Ргезз, 1987. 417 с.

ЗЬогто С.Б., 8сЬпе1йег Т.Б., Сс1й Ь. СЬагасЬег хзаЫоп оГ Иапз-
1аЫопа1 1пШаЫоп зИез 1п Е.со11//Кис1. Ас1йз Кез. 1982а.7оЦ0
РЛогто С.В., ЗскпеИег Т.В., СоИ Ь. , ЕЬгепГеисЬЬ А. Взе о! Ы1е
"РегсерЬгоп" а^огИЬт 1о (11з!1п§и1з11 1гапз1аНопа1 хпШаИоп
зИез 1п Е.со11//Ыис1. АсИз Кез. 1982Ь. Уо1.10. Р. 2997-3011.

8Ьогто С.В., ЗскпеИег Т.В. СоИ Ь. ЧиапЫШхуе апа1уз!з о! Ы1е
ге1аЫопз!ир ЪеЬгееп пис1ео!Ие зезиепсе апй ГипсЫопа! асЫуИу//
Ыис1. АсИз Кез.1986.7о1.14, Ы 16.Р.6661-6679.

8!ис1п1ска С.М., КаЬп С.М., Сшшппяз 1Л., 5а1зег V. СотриФег теШН
Гог ргеЛсИп^ ЬЬе зесопЬагу зЬгисЬиге оГ зш^е-зЬгапЬеЬ РКА//
Нис 1. Ас Из Кез. 1978.7о1.5Л 9.Р.3365-3387.

8!и11сЬ К.» КоМе К. ЕМВОРКО - ап аиЬотаЫса11у §епега!ес! рго!е!п ’
зезиепсе ЬаЬа Ъазе//Сотри!.Арр1.В1озс1.1989. Уо1.5Л 1.Р. 15-18.

8и1з!оп Л., Ма11е1 Е., ЗЬаЬеп К. е! а1. 8оГ!таге Гог §епоте тарр1п§
Ьу Г1п2егрг1п11пе ЬесЪп1зиез//СотриЬ.Арр1.В1озс1.1988. 7о1.4Л 1.

8иззк1пс1 М.М., ВоЬзЬеИ В. Мо1еси1аг яепеНсз оГ Ьас!ег1ор11а§е Р22//
М1сгоЫо1.Неу. 1978. Уо1.42.Р. 385-413.

Тетр1е!оп А.К. РНуИ^епеИс ИГегепсе Ггот гез!г1с!1оп епйопис1еазе
с!еауа§е зИе тарз 1»Ш1 раг!1си1аг геГегепсе Ьо Ы1е еУо1иЫоп оГ
Ьитапз апЬ ЬЬе арез//Еуо1иЬ.1983. 7о1.37.Р.221-244.

ТеггуВ.Л., Ласк ТС.Е.» Мос1г1с11 Р. ЕасПИа^еЬ ЛГГизИп Ьиг1п§
са1а1уз1з Ьу ЕсоК! епЬопис1еазе. ЫопзресШс 1п1егас11опз 1п ЕсоН!
саи1уз1з//Л.В1о1. СЬет.1985. 7о1.260.Р. 13130-13137.

Т1ют К. 81гис1ига1 зЪаЬШЪу апЬ тогр1ю§епез1з. СкарЪег 7, И.У.:
АсаЬепис Ргезз. 1975.Р. 124-150.

Т1посо I., Лг., ОЫепЬеск 0.» Ьеу1пе М.В. Ез11та11оп оГ зесопЬагу
зЪгисЪиге 1п г!Ьопис1е!с асИз//Ма1иге. 1971.7о1.230» И 5293.

ТгатопЪопо А.» МассЫ аЪо М.Е. РгоЬаЫ 1 Цу оГ сосИп§ о Г а ВИА
зезиепсе: ап а^огИЬт 1о ргеЛсЪ 1гапз1а1еа геаЫп§ Ггатез Ггот
Ы1е1г НаегтоЬупатс скагасиг1зисз//Кис1.АсИз.Кез. 1986.7о1.14.

ТгИопоу ЕЛ.» ВгепЬе! V. СЫ0М1С: а ЫсНопагу оГ Пае §епеИс соЬе//
РМ1аЬе1рЫа: Ва1аЬап РиЫ 1зЫп§. 1986.272Р.

ТиПегуР., Веззеп Р.» Ми^п1ег С., Нагои! 8. Кез!г1с!1оп тар
сопз!гис!1оп из!п§ а 'сотр!е!е зеп!епсез сотраМЫ! Ну'
а1^огИкт//Сотри!.Арр1. В1озс1.1988.Уо1.4»Ы 1.Р. 103-110.

ОЫепЬеск О.С.» Вогег РЛ., Веп§1ег В. »Т1посо 1.»Лг. 8!аЫ1Иу о!
КЫА Ьа1гр1п 1оорз: А6- Ст- 06//Л.Мо1.В1о1.1973, Уо1.73Л 4.

ОНтап Л.В. Рг1пс1р1ез оГ ЬаЬа Ьазе зузЬетз. КоскуШ» МВ:Сотри!ег
8с1епе Ргезз,1982. Р.197-210.

Уа1епЫп-Напзеп Р., А1ЬгесМзеп В., Ьоуе-Ьагзеп Л.Е. ВИА рго!е!п
гесо^пШоп - аетопзЬгаИоп оГ ЬЬгее §епе!1са11у зерагаЬей
орегаЬог е!етеп!з Ька! аге гезихгей Гог гергеззИп о? Пае
ЕзсЬегНЫа соИ ЬеоСАВВ рготоЬегз Ьу ЬЪе ЬеоК гергеззог//ЕМВО Л.
1986ЛО1.5. Р. 2015-2021.

^аЬегтап М.5. 8езиепсе аИ^птеп! 1п ЬЬе пе!§11Ьог11оос1 оГ ори тит шИЬ
§епега! аррИсаИоп Ьо йупатс рго§гатт!п§//РгосЛа!.АсаЬ.Зс! Л5А.
1983.Уо1.80.Р.3123-3124.

262
^аЬегтап М.З.Сепега! теЫюйз о Г зедиепсе сотраг 1зоп//Ви11. МаЬЬ.Вин.
1984,46,И 4.Р. 473-500.

^айегтап М.5, МиШр1е зедиепсе аН^птеп! Ьу сопзепзиз// Ыис1. Ас1йз
Кез.1986.7о1.14.Р.9095-9102.

^аЬегтап М. 3. РгоЬаЫШу й1з,Ьг1Ьи,Ь10Пз Гог ВЫ А зедиепсез сотра-
г1зопз// Боте таЫхетаИса! диезЫопз 1п Ыо1о&у. БИА Зедиепсе
Апа1уз1з.1986.Р.29-56.

^аЬегтап М. 3., АггаЫа К.. Са1аз В. й. РаНегп гесо&пШоп 1п зеуега!
зедиепсез - сопзепзиз апй а11ептепЬ//Ви11. МаЫ1.В1о1. 1984. 7о1.
46.Р.515-527.

^аЬегтап М.З., Сп^з й.К. 1пЬегуа1 §гар!1з апй тарз о! БИА// Ви11.
МаПк В1о1.1986.7о1.48,Ы 2.Р.189-197.

^аЬегтап М.З., ЗтХ'Ы! Т.Е., Веуег ^.А. Зоте Ыо1о§1са1 зедиепсе
теЬг!сз//Айу.МаЫ1. 1976.7о1.20.Р.367-387.

^аЬегтап М.З., ЗтШ1 Т.Е., КаЬсйег Н.Б. А1^ог 1 ЪЬт Гог гез^гюНоп
тар сотраг1зопз//Кис1.Ас!йз Кезеагсй.1984.701.12, И 1.Р.237-242.

ИЛЪиг V.й., Ыртап Б.й. Кар1й зхтПагИу зеагскез оГ пис1е!с апй
ргоЬе!п йаЬа Ьапкз//Ргос.ЫаЬ.Асай.Зс1.БЗА., 1983.7о1.80.Р.726-730.

ИШатз А., Т1посо 1.,йг. А йупат!с рго&гатт1п& аГ^огШип Гог
Ппй1п§ а11егпа11уе 1ША зесопйагу з1гис1игез//Ыис1. Ас1йз Кез.
1986.7о1.14.Р.299-315.

VIIИатз М.Е. Е1ес1гоп1с Ба1аЬазез//Зс1епсе. 1985.7о1.228, Р. 445-456.

ТСоезе С.К., Маргит Б.й., СирЬа К., еЬ а1. Зесопйагу зЬгисЬиге тойе!

Гог Ьас1ег1а1 163 г!Ьота! ША: рЬу1обепе11с, епзутаИс апй
сИеппса! еУ1йепсе//Иис1.Ас1йз Кез.1980.7о1.8,И 10. Р.2275-2293.

^оп§ й.Т.Е., Сейег^геп К. Ка1ига1 зе!ес11оп уегзиз рг1т!Ъ1уе ёбпе
зйгисйиге аз йе1егт1пап1 о! сойоп иза§е//Еиг.й.В1ос!1ет. 1986. Уо1.
159.Р.175-180.

ТСи1кап М. ,Ьо11 Т.й. Сотри1ег-а1йей сопзЪгисИоп оГ пис1е!с ас!й
гез!г1с11оп тарз из!п§ йеПпей Уес€огз//Сотри1. Арр1. В1озс1.1985.
7о1.1,Ы 4.Р.235-239.

ЕеЬеЪпег С., ЕгчзсЬаиГ А., Бекгаск Н. АрргоасЬез 1о гез1г1с!1оп тар
йе1егт1па11оп//Кис1е1с ас!й апй рго!е1п зедиепсе апа!уз1з: а
ргасИса! арргоасЬ/М.й.В1з!юр, С.й. КатлгИп^з. ОхГогйЛазПт§1оп,
Б.С.: 1К1. Ргезз.1987. 417 с.

2е11е1пег С., БеИгасИ Н. А сотриЪег рго§гатт раскате Гог гезЪПсЫоп
тар апа!уз!з апй тап1ри1а11оп//Иис1.Асхйз Кез.1986. 7о1.14, К 1.

211игк1п 7.В. Регюй1с11у 1п БИА ргчтагу з1гис1иге 1з йеПпей Ьу
зесопйагу зЬгисЬиге оГ ЬЬе сойей ргоЬе!п// Яис1. Ас1йз Кез. 1981.
7о1.9.Р.1963-1971.

2икег,М., ЗЫе§1ег.Р. ОрЫта! сотриЬег 1о1й1п& о! 1аг^е ША зедиеп-
сез из1п§ Ы1егтойупат1сз апй аихШагу 1пГогтаЫоп// Яис1. Ас1йз
Кез. 1981.7о1.9,И 1.Р.133-148.
ОГЛАВЛЕНИЕ

ПРЕДИСЛОВИЕ.........................................................

ВВЕДЕНИЕ...........................................

ГЛАВА 1. ПОИСК ГОМОЛОГИЙ (А.А.Миронов)..............................

ГЛАВА 2. СТАТИСТИЧЕСКИЕ МЕТОДЫ АНАЛИЗА ГЕНЕТИЧЕСКИХ ТЕКСТОВ
(М.Ю.Бородовский, П.А.Певзнер)......................................

ГЛАВА 3. РАСПОЗНАВАНИЕ КОДИРУЮЩИХ ОБЛАСТЕЙ В НУКЛЕОТИДНЫХ
ПОСЛЕДОВАТЕЛЬНОСТЯХ (М.Ю.Бородовский)...............................

ГЛАВА 4. РАСПОЗНАВАНИЕ ФУНКЦИОНАЛЬНЫХ СИГНАЛОВ (Н.Н.Александров,
....................................................................

ГЛАВА 5. ФИЗИЧЕСКОЕ (РЕСТРИКЦИОННОЕ) КАРТИРОВАНИЕ МОЛЕКУЛ ДНК
(П. А. Певзнер).....................................................

ГЛАВА 6. МЕТОДЫ ПРЕДСКАЗАНИЯ ВТОРИЧНЫХ СТРУКТУР РНК
(А. Э. Кистер).....................................................189

ГЛАВА 7. ОРГАНИЗАЦИЯ ХРАНЕНИЯ МОЛЕКУЛЯРНО-ГЕНЕТИЧЕСКОЙ ИНФОРМАЦИИ
В БАЗАХ ДАННЫХ. ПАКЕТЫ ПРИКЛАДНЫХ ПРОГРАММ АНАЛИЗА
НУКЛЕОТИДНЫХ ПОСЛЕДОВАТЕЛЬНОСТЕЙ (В.А.Шепелев).....................221

ПРИЛОЖЕНИЕ А.......................................................242

ЛИТЕРАТУРА..........................................................

Научное издание

Александров Александр Анатольевич, Александров Николай Николаевич,
Бородовский Марк Юрьевич и др.

КОМПЬЮТЕРНЫЙ АНАЛИЗ ГЕНЕТИЧЕСКИХ ТЕКСТОВ

Утверждено к печати Институтом молекулярной генетики АН СССР

Редактор издательства РЛ. ЦЫБУЛЬСКАЯ Художник БЛС РЯБЫШЕВ

Художественный редактор НЛ МИХАЙЛОВА

Технический оедактоо ЯИ. КУПРИЯНОВА

ИБ № 40240

Подписано в печать 20.02.90. Т-07702. Формат 60x90 1/16. Бумага офсетная 1. печать офсетная
Усллечл. 16,5. Усл. кр. отт. 16,88. Учжздл. 18,1. Тираж /500 эка. Тип. зак. 4327. Цена 3 р. 40 к.

Ордена Трудового Красного Знамени издательство "Наука”

117864 ГСП-7, Москва В-485 Профсоюзная ул, 90.

2-я типография издательства "Наука”, 121099, Москва Г-99, Шубинскин пер, 6.

Оригинал-макет подготовлен на компьютере в Институте молекулярной генетики АН СССР
3 р 50 к.

Как расшифровать генетическую
информацию, что в лей служит
словами, а что знаками пре-
пинания, какие средства нсполь
зует природа для записи своих
уклзани ц- - на это необходимо
было пайтп ответ, чтобы попять,
как прочитанная генетическая
информация оживает в клетке.
Для ответа потребовалось разви-
тие повой дисциплины компью-
терной генетики, лежащей па.
стыке био 1011111 п информатики.

«НАУКА»